
大模型原理与训练 / 系统课时
在贪心采样与束搜索间选择
在贪心采样与束搜索间选择
贪心搜索和束搜索都可以在 generate 中得到确定性结果,但它们保留候选的方式完全不同。本篇用同一模型对比 num_beams=1 与多束搜索,建立搜索质量、确定性和计算成本之间的判断框架,并给出实际选择边界。
学习目标
- 能解释 greedy 与 beam search 在每一步保留候选的差异
- 能用
num_beams配置并运行两种确定性生成 - 能依据任务目标判断何时值得支付束搜索的额外计算成本
两种搜索到底差在哪里
贪心搜索每一步只保留当前概率最高的 token,一旦选中就不回头。它计算路径单一、速度快、结果稳定,但局部最优选择可能让后续整体序列质量受限。
束搜索会同时保留若干条累计得分较高的候选序列。每一步先扩展所有 beam,再从新的候选中留下得分最好的若干条继续搜索,因此能够避开一部分“第一步看起来最好、整体却较差”的路径。
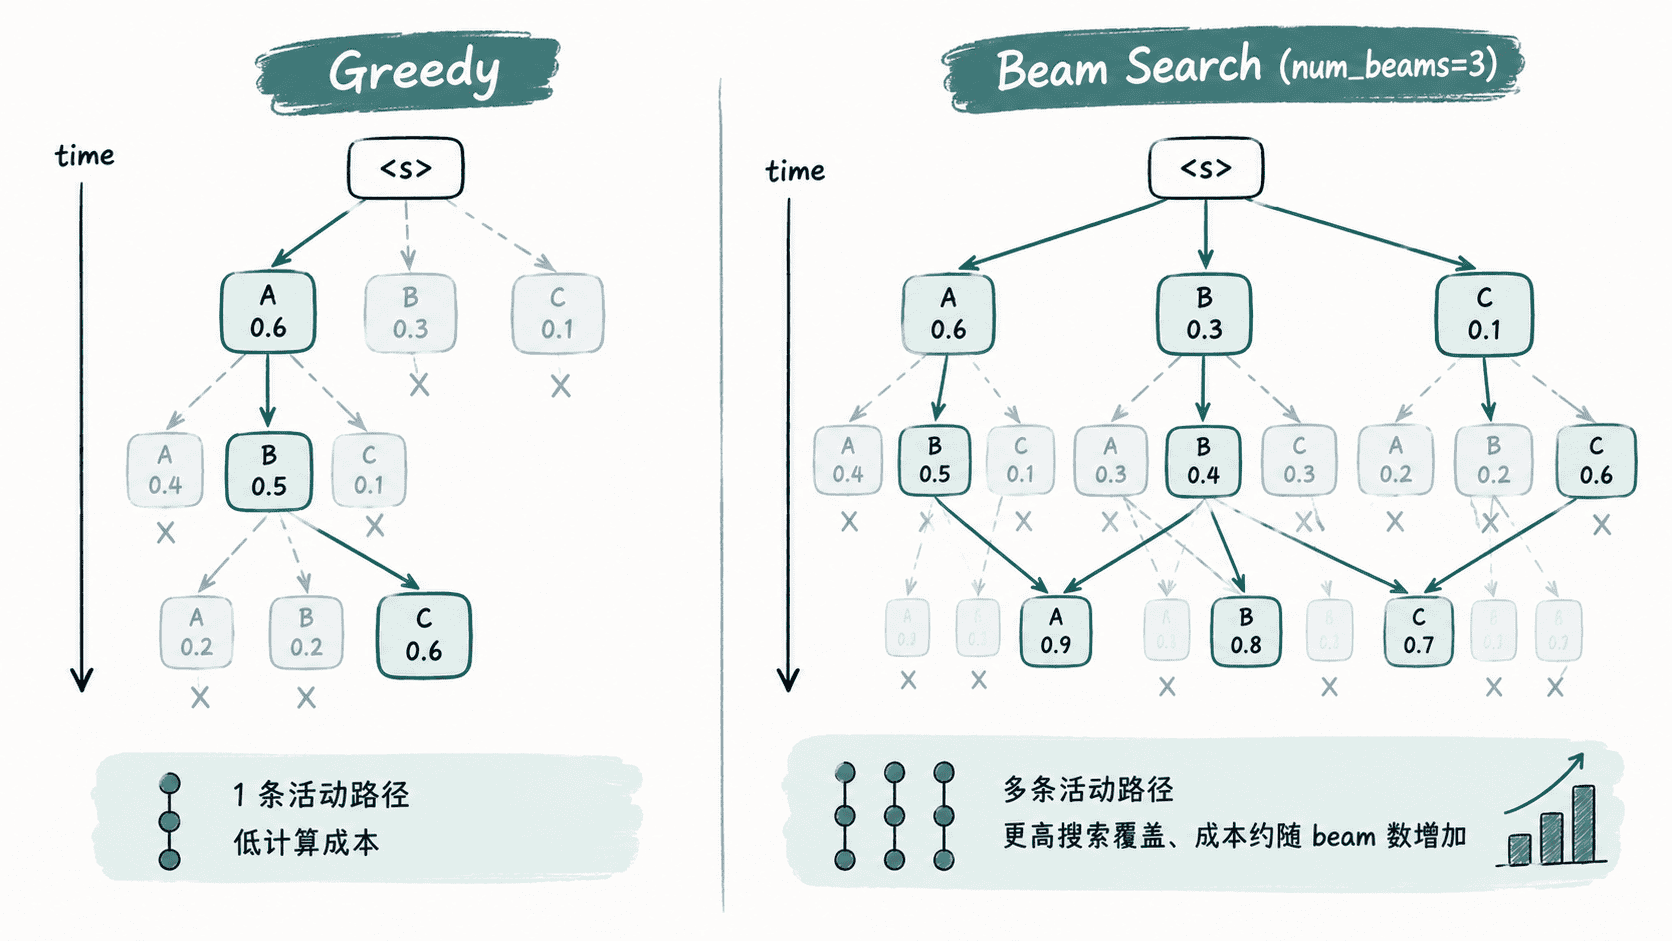
这里的 greedy 不是随机采样:当 do_sample=False 且 num_beams=1 时,它就是确定性的贪心搜索;当 do_sample=False 且 num_beams>1 时,则进入确定性的束搜索。
用同一提示词比较两种生成
下面的示例只改变搜索策略,长度、停止 token 与模型保持一致,便于观察策略差异。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "sshleifer/tiny-gpt2"
prompt = "The best way to learn programming is"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)
inputs = tokenizer(prompt, return_tensors="pt")

common = {
    "max_new_tokens": 20,
    "do_sample": False,
    "eos_token_id": tokenizer.eos_token_id,
    "pad_token_id": tokenizer.eos_token_id,
}

greedy_ids = model.generate(**inputs, num_beams=1, **common)
beam_ids = model.generate(
    **inputs,
    num_beams=4,
    early_stopping=True,
    **common,
)

greedy_text = tokenizer.decode(greedy_ids[0], skip_special_tokens=True)
beam_text = tokenizer.decode(beam_ids[0], skip_special_tokens=True)

print("greedy:")
print(greedy_text)
print("beam:")
print(beam_text)
预期输出
greedy:
<GENERATED_TEXT_GREEDY>
beam:
<GENERATED_TEXT_BEAM>
两段文本都以原提示词开头,并且在同一模型与参数下可重复得到相同结果。具体续写内容取决于模型文件版本,不应把某一段自然语言输出写死为程序断言。
用任务目标决定是否开 beam
| 判断维度 | Greedy | Beam Search |
|---|---|---|
| 活动候选数 | 1 条 | num_beams 条 |
| 确定性 | 高 | 高,前提是不开随机采样 |
| 计算与显存 | 最低 | 通常随 beam 数明显增加 |
| 搜索覆盖 | 只看单一路径 | 同时比较多条高分路径 |
| 常见适用任务 | 快速基线、低延迟生成 | 翻译、摘要等偏向单个高概率答案的任务 |
束搜索不等于“beam 越大质量越高”。对开放式续写、聊天和创意写作,过强地追逐高概率序列常会让文本更保守、重复,甚至不如合理采样自然;而在机器翻译、受约束摘要等需要稳定输出的任务里,它更常有价值。
num_beams=4 可以作为验证束搜索行为的起点,但生产参数应通过真实任务集评估。beam 数增加时,同一时间会维护更多候选以及各自的缓存状态,所以延迟和显存开销都会上升。
识别几个常见误区
num_beams=1 与“采样”没有必然关系。是否随机由 do_sample 决定;只有开启采样后,token 才按概率分布随机抽取。把 greedy、beam 与 sampling 混在一起比较,会误判结果的确定性。
early_stopping=True 主要影响束搜索何时停止,不是把输出强行缩短。最终仍受 eos_token_id、max_new_tokens 等条件共同约束。
如果系统首先要求低延迟、低成本和稳定基线,优先从 greedy 开始;如果任务更看重全局序列得分,并且可以接受更高计算开销,再开启 beam search。选择搜索策略时,最重要的不是参数名,而是任务究竟需要“一条最快路径”还是“多条候选中再做全局比较”。