
大模型原理与训练 / 系统课时
对齐序列标注的词元标签
对齐序列标注的词元标签
序列标注的数据通常按“词”提供标签,但 Transformer 实际按子词训练。这里解决一个关键错位:把每个原始词的标签准确投到 tokenizer 产生的 token 上,并用 -100 屏蔽特殊 token 和不参与损失计算的重复子词。
学习目标
- 使用 fast tokenizer 的
word_ids()建立 token 与原始词的对应关系 - 为特殊 token 和重复子词设置忽略索引
-100 - 区分“只训练首个子词”和“所有子词都训练”两种对齐策略
为什么标签会错位
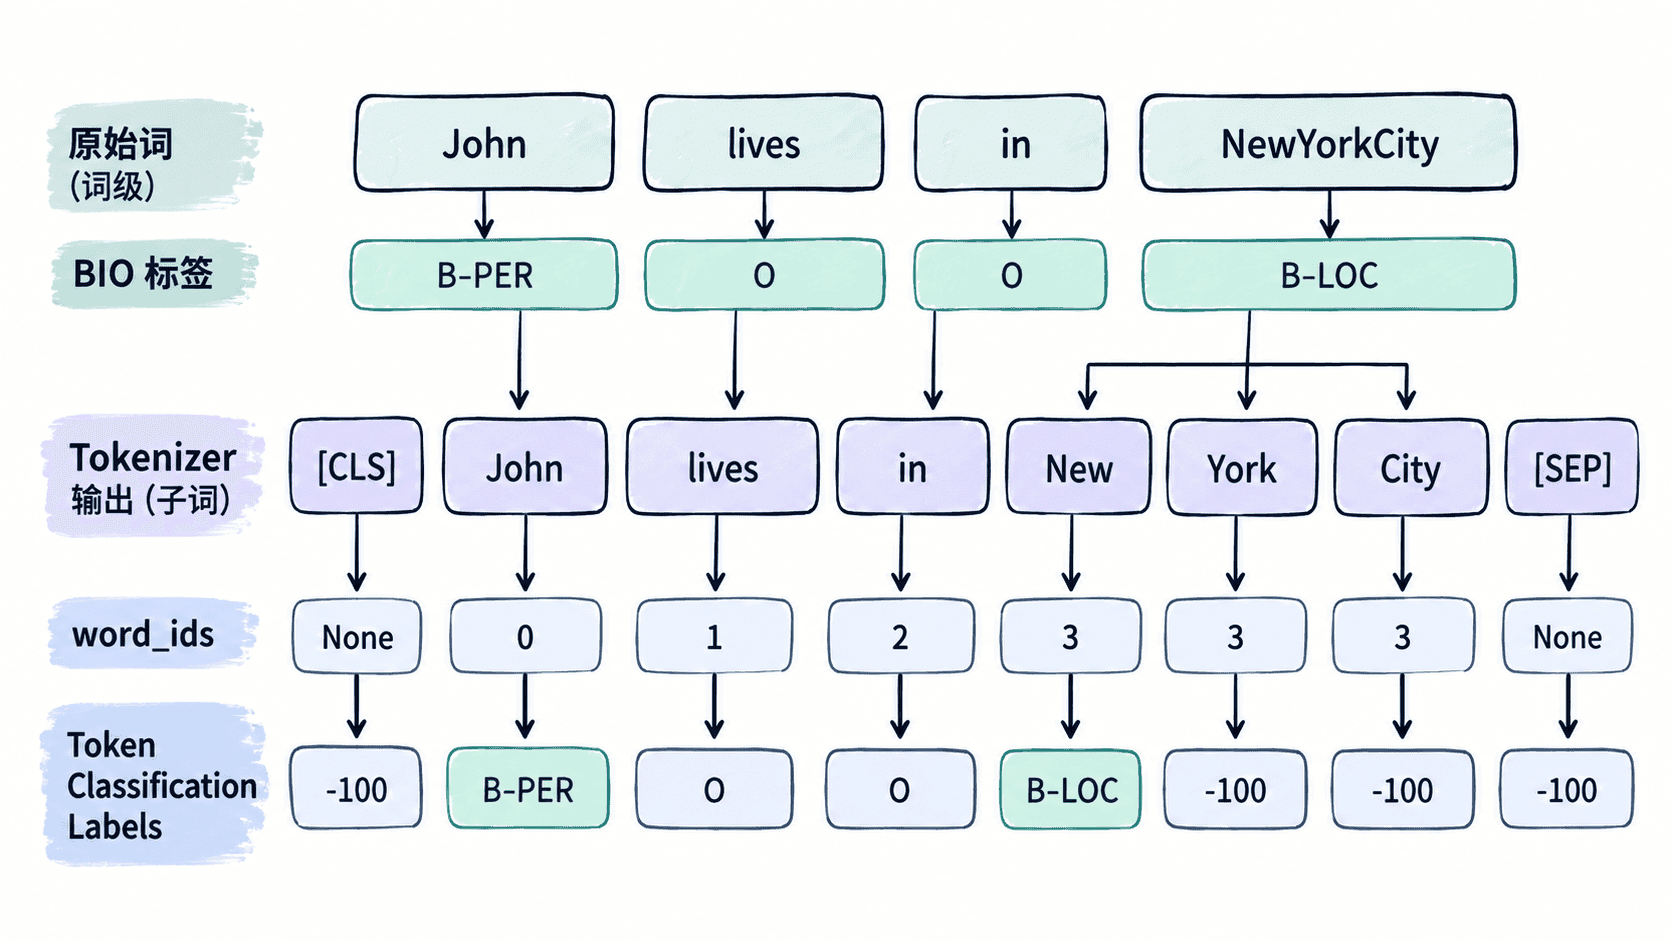
NER、词性标注等任务常把一条样本表示为词列表和等长标签列表,例如 ["John", "lives", "in", "NewYorkCity"] 对应 [B-PER, O, O, B-LOC]。但模型输入还会加入 [CLS]、[SEP] 等特殊 token,一个较长词也可能被拆成多个 WordPiece 或 BPE 子词,因此 token 数量通常不再等于标签数量。
如果直接把原标签数组交给模型,轻则长度不匹配,重则标签落到错误 token 上。真正需要的是“token 位置 → 原始词位置”的映射。
用 word_ids 构造 labels
word_ids() 只在 fast tokenizer 上可用,所以应显式使用 use_fast=True。下面采用“只训练每个词的第一个子词”策略:一个词被拆成多个子词时,仅首个子词继承词级标签,其余位置写入 -100。
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("bert-base-cased", use_fast=True)

example = {
    "tokens": ["John", "lives", "in", "NewYorkCity"],
    "labels": [1, 0, 0, 3],  # 0=O, 1=B-PER, 3=B-LOC
}

encoded = tokenizer(
    example["tokens"],
    is_split_into_words=True,
    truncation=True,
)

word_ids = encoded.word_ids()
aligned_labels = []
previous_word_id = None

for word_id in word_ids:
    if word_id is None:
        # [CLS]、[SEP] 等特殊 token 不参与 token classification 损失。
        aligned_labels.append(-100)
    elif word_id != previous_word_id:
        # 每个原始词只有第一个子词保留监督信号。
        aligned_labels.append(example["labels"][word_id])
    else:
        aligned_labels.append(-100)
    previous_word_id = word_id

encoded["labels"] = aligned_labels

print(
    "input_and_labels_same_length="
    + str(len(encoded["input_ids"]) == len(encoded["labels"]))
)
print(
    "one_train_label_per_word="
    + str(sum(label != -100 for label in aligned_labels) == len(example["labels"]))
)
print(
    "special_tokens_ignored="
    + str(all(label == -100 for wid, label in zip(word_ids, aligned_labels) if wid is None))
)
预期输出
input_and_labels_same_length=True
one_train_label_per_word=True
special_tokens_ignored=True
这里的 is_split_into_words=True 很重要,它告诉 tokenizer 输入已经按词切分,不应把整个列表当成普通字符串。word_ids() 返回的 None 表示特殊 token,整数则表示当前 token 来自第几个原始词。
为什么使用 -100
Hugging Face 的 token classification 模型底层通常使用交叉熵损失,而 PyTorch CrossEntropyLoss 默认把 -100 作为 ignore_index。因此,标签为 -100 的位置仍存在于张量中,用来保持序列长度一致,但不会贡献损失。
这比删除特殊 token 或重复子词更安全:输入序列长度不变,attention mask、位置编码和标签张量仍可逐位置对应。
什么时候要给所有子词打标签
“只训练首个子词”适合标签本来定义在词级、希望每个词只贡献一次损失的任务。另一种做法是让一个词的所有子词都参与训练,例如把 B-LOC 的后续子词转换为相应的 I-LOC。这能增加监督信号,但必须维护 BIO 或 BIOES 标签之间的转换关系,不能简单复制所有 B- 标签。
无论选择哪种策略,都应保持训练、验证和推理后的聚合规则一致。最关键的验收条件是:input_ids 与 labels 等长,特殊位置使用 -100,每个非忽略标签都能追溯到正确的原始词。