
大模型原理与训练 / 系统课时
用 generate 完成文本生成
用 generate 完成文本生成
generate 把已经分词的输入序列继续向后扩展,是 Transformers 中最常用的生成入口。本篇从 input_ids 出发跑通一次可执行生成,并把 max_new_tokens、eos_token_id 与 pad_token_id 的职责分清,最终能稳定控制生成长度与停止行为。
学习目标
- 能用 tokenizer、模型与
generate完成一次因果语言模型推理 - 能解释
max_new_tokens、eos_token_id与pad_token_id对生成过程的影响 - 能从生成张量中分离输入部分与新增 token,并正确解码
看清 generate 的输入与输出
对因果语言模型来说,tokenizer 先把提示词转换为 input_ids,模型再依据这些 token 逐步预测下一个 token。generate 负责循环执行“前向计算 → 选出下一个 token → 追加到序列”,直到触发停止条件。
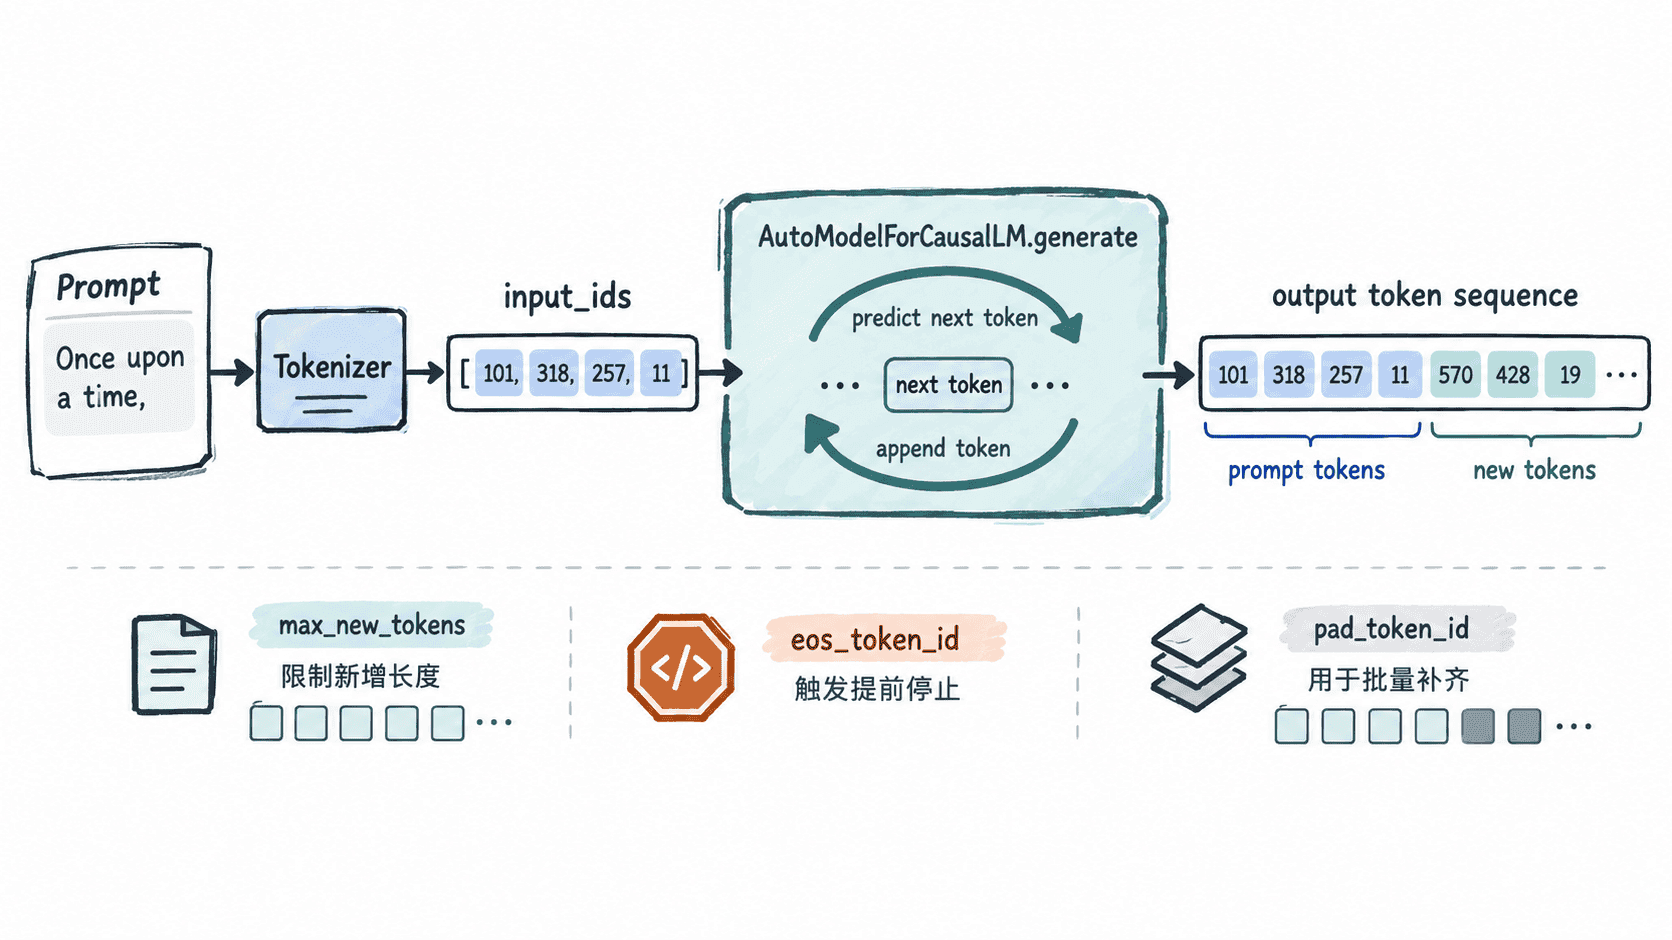
generate 返回的通常是完整序列,也就是输入 token 与新生成 token 拼接后的结果,而不是只返回新增部分。因此如果后续要统计新增长度或只展示模型续写,需要记住输入长度。
跑通最小生成示例
下面使用小型 GPT-2 模型完成一次确定性生成。首次运行会从 Hugging Face Hub 下载模型文件,因此需要可访问模型仓库的网络环境,并已安装 transformers 与 PyTorch。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "sshleifer/tiny-gpt2"
prompt = "Machine learning is"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id)

inputs = tokenizer(prompt, return_tensors="pt")
input_len = inputs["input_ids"].shape[1]

output_ids = model.generate(
    **inputs,
    max_new_tokens=20,
    do_sample=False,
    eos_token_id=tokenizer.eos_token_id,
    pad_token_id=tokenizer.eos_token_id,
)

# generate 返回“输入 + 新生成 token”,所以用输入长度切出新增部分。
new_token_ids = output_ids[0, input_len:]
generated_text = tokenizer.decode(new_token_ids, skip_special_tokens=True)

assert output_ids.shape[1] <= input_len + 20
print("generation_ok")
print(f"new_tokens={len(new_token_ids)}")
print(generated_text)
预期输出
generation_ok
new_tokens=<TOKEN_COUNT>
<GENERATED_TEXT>
<TOKEN_COUNT> 的实际值不超过 20;如果模型提前生成 eos_token_id,它可能小于 20。<GENERATED_TEXT> 会受模型文件版本与运行环境影响,因此不应把某一段具体续写当成接口契约。
三个参数分别控制什么
max_new_tokens 限制的是提示词之后最多新增多少 token。它比按总长度计算的 max_length 更直接,因为提示词长短变化时,生成预算仍然保持不变。
eos_token_id 是结束 token 的编号。当某一步选中的 token 命中它时,该序列可以提前结束。对于自回归模型,这是真正决定“模型自己认为已经说完”的停止信号之一。
pad_token_id 用于把不同长度的序列补成同一批次形状。GPT-2 这类模型默认没有独立 pad token;做纯生成且没有额外语义要求时,常把 pad_token_id 临时设成 eos_token_id,从而避免缺少 padding id 的警告。若模型本身定义了 pad token,应优先使用模型原有配置。
正确处理生成结果
如果要展示“完整回答”,可以直接解码 output_ids[0];如果只想得到模型新增的内容,就应像示例那样按 input_len 切片。批量生成时,每条输入长度可能不同,还要结合 attention mask 与 padding 方式计算各自的有效提示词范围。
generate 还支持采样、束搜索、重复惩罚和自定义停止规则,但这些都建立在同一个基本契约上:输入 token 先进入模型,生成策略逐步追加 token,长度上限与停止 token 决定何时结束。先把这一条链路验证清楚,后续调参才不会把“搜索策略”和“停止条件”混为一谈。