
大模型原理与训练 / 系统课时
用 DataCollator 动态组批
用 DataCollator 动态组批
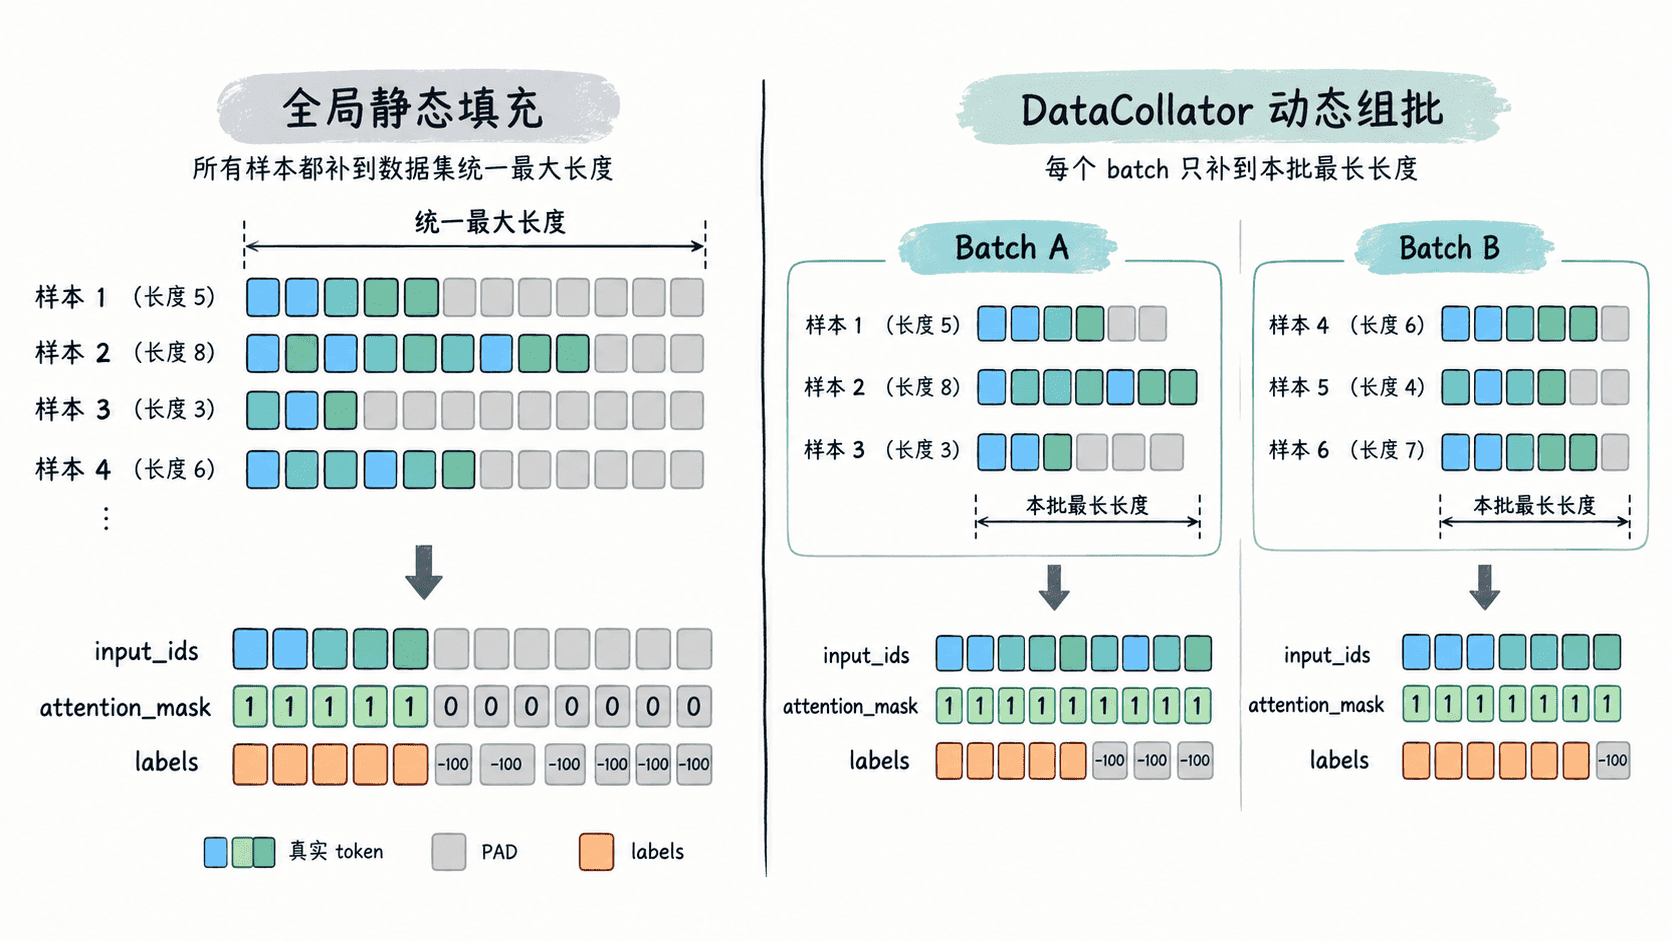
这节把已完成 tokenizer 编码的样本交给 DataCollator,在每个 batch 内按最长样本动态填充,而不是预先把全量数据补到统一长度。这样既能减少无效 token 计算,也能把 label 等字段整理成训练器期望的批张量。
学习目标
- 理解动态填充为什么应在组 batch 时执行
- 使用
DataCollatorWithPadding生成可直接训练的张量 - 根据分类、语言模型和 Seq2Seq 任务选择合适的 collator
动态填充发生在哪里
tokenizer 可以先只做截断而不做填充,让每条样本保留自己的长度。真正组 batch 时,collator 查看这一批样本中的最大长度,再只把本批较短样本补齐。下一个 batch 会重新计算自己的最大长度,因此不会被整个数据集中的极长样本拖累。
用 DataCollatorWithPadding 组一个分类 batch
下面示例先让 tokenizer 返回不同长度的特征,再把它们交给 DataCollatorWithPadding。示例中的模型文件首次运行时会从 Hugging Face Hub 下载;如果环境已经缓存,则直接使用本地缓存。
from transformers import AutoTokenizer, DataCollatorWithPadding

tokenizer = AutoTokenizer.from_pretrained("distilbert-base-uncased")
collator = DataCollatorWithPadding(
    tokenizer=tokenizer,
    return_tensors="pt",
)

texts = [
    "Short example.",
    "This sentence is a little longer.",
    "Dynamic padding only pads to the longest item in this batch.",
]
labels = [0, 1, 1]

features = []
for text, label in zip(texts, labels):
    encoded = tokenizer(text, truncation=True, padding=False)
    encoded["label"] = label
    features.append(encoded)

max_length_before_padding = max(len(item["input_ids"]) for item in features)
batch = collator(features)

print("batch size:", batch["input_ids"].shape[0])
print(
    "padded to batch max:",
    batch["input_ids"].shape[1] == max_length_before_padding,
)
print("has labels:", "labels" in batch)
print("labels:", batch["labels"].tolist())
预期输出
batch size: 3
padded to batch max: True
has labels: True
labels: [0, 1, 1]
DataCollatorWithPadding 会调用 tokenizer 的填充逻辑,并把常见的单样本 label 字段整理成批级 labels。实际 input_ids 的第二维取决于当前 batch 最长序列,所以不应把固定长度写死在训练代码里。
padding 参数怎么选
默认动态填充只补到本批最长样本。若使用支持 Tensor Core 的 GPU,可按模型与硬件需求考虑 pad_to_multiple_of=8,让序列长度向指定倍数对齐;这可能提升某些场景的吞吐,但也会增加少量 PAD。
如果你在预处理阶段已经使用 padding="max_length",collator 仍能组批,但“动态填充节省计算”的优势基本消失。通常更稳妥的组合是 tokenizer 阶段设置 truncation=True、不填充,DataLoader 或 Trainer 组批时再交给 collator。
不同任务不要混用 collator
序列分类通常使用 DataCollatorWithPadding 即可;掩码语言模型需要 DataCollatorForLanguageModeling 在组批时构造掩码与训练标签;Seq2Seq 任务常用 DataCollatorForSeq2Seq,它会分别处理输入与目标序列的填充,并通常用 -100 填充目标侧 labels,让损失函数忽略这些位置。
选择 collator 的原则很简单:先由 tokenizer 生成单样本特征,再由与任务匹配的 collator 负责批级填充和训练字段整理。这样预处理数据保持紧凑,批处理逻辑也能随任务独立调整。