
大模型原理与训练 / 系统课时
对比基线与微调模型
对比基线与微调模型
模型训练结束后,不能只看“微调后的指标更高”就决定上线。本节把基座模型、全量微调模型与 PEFT 模型放到同一评估集、同一推理配置和同一硬件上,统一测质量与延迟,再结合模型文件成本判断哪个版本值得进入部署阶段。
学习目标
- 用固定评估集对三个候选模型执行可复现的质量评估
- 在统一硬件和生成参数下测量推理延迟与模型规模
- 根据质量增益、成本与延迟做出可解释的部署选择
先固定所有不可变条件
公平比较的核心不是“跑三次 evaluate”,而是保证三次评估只改变模型本身。固定评估文本、tokenizer、最大输入长度、生成长度、batch size、设备、精度和随机种子;延迟测试还要先 warm-up,再重复多次取中位数,避免首次加载与 CUDA 初始化污染结果。
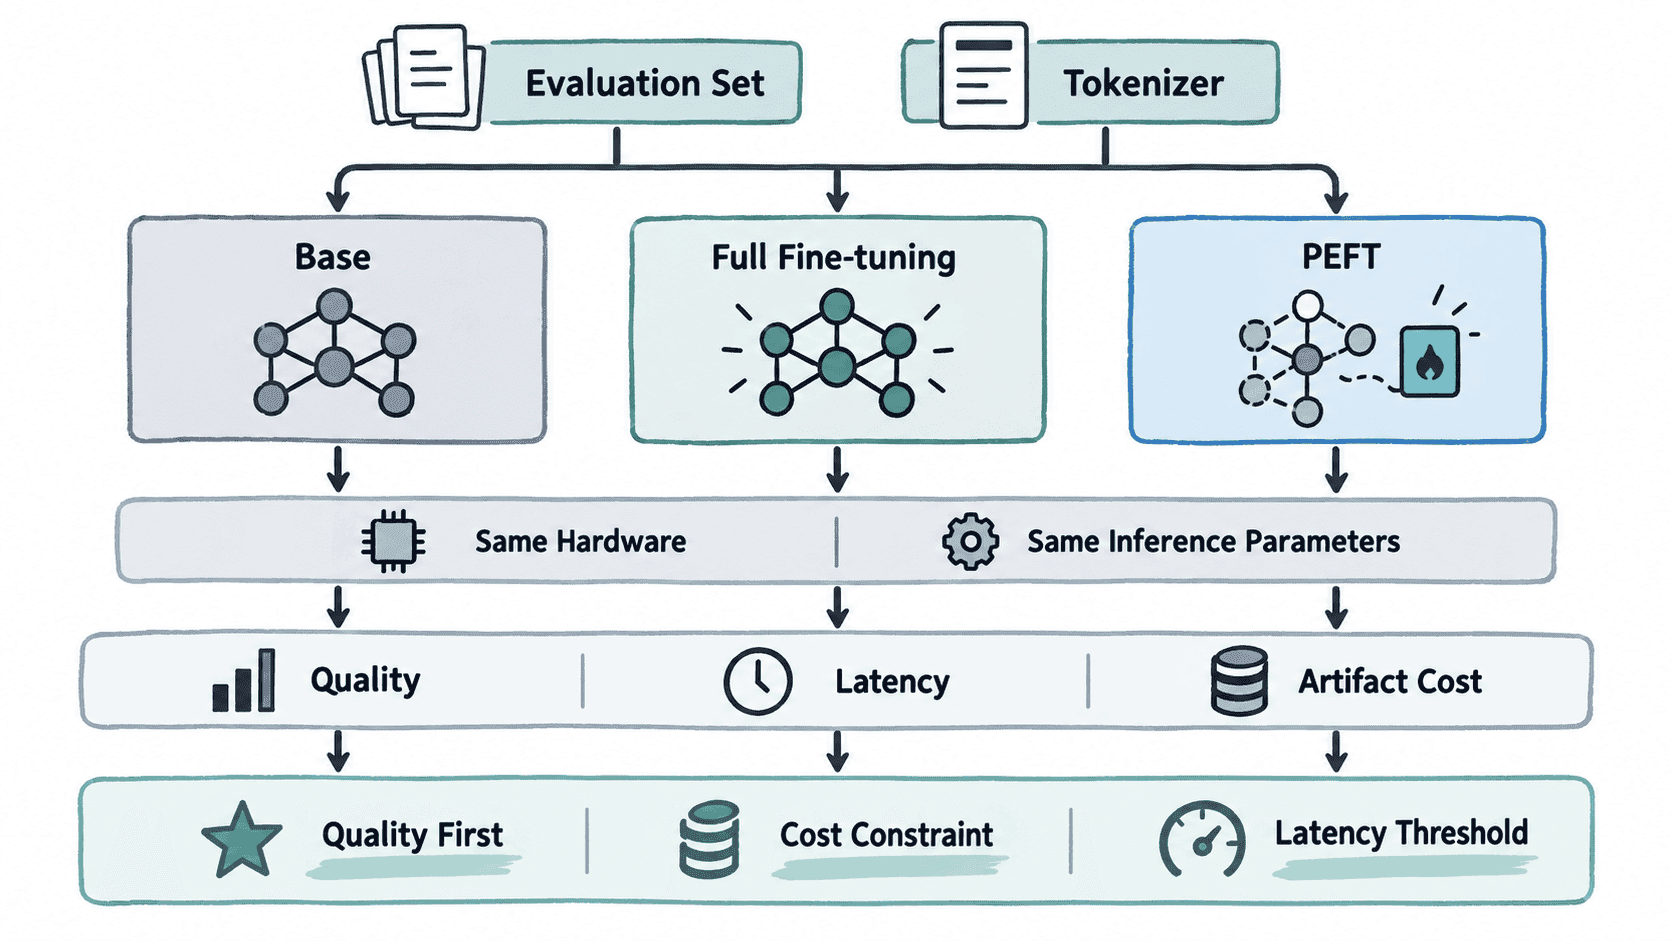
对于因果语言模型,可以先用同一批文本的 perplexity 做最低成本的质量对比;正式项目还应追加与业务目标一致的指标,例如准确率、F1、ROUGE、人工偏好或任务成功率。任何模型只在一个指标上领先,都不足以自动获得部署资格。
用同一脚本测质量与延迟
下面的脚本依次加载基座模型、全量微调 checkpoint 和 PEFT adapter。为了避免三个模型同时占满显存,它会逐个加载、评估并释放。示例使用固定文本计算 perplexity,并对固定 prompt 的生成延迟取 p50。
import argparse
import gc
import math
import statistics
import time
from pathlib import Path

import torch
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer

EVAL_TEXTS = [
    "Transformers can adapt pretrained representations to downstream tasks.",
    "A reproducible evaluation keeps data and inference settings unchanged.",
]
PROMPT = "A reliable model evaluation should"

def sync(device):
    if device.type == "cuda":
        torch.cuda.synchronize(device)

def artifact_mb(path):
    p = Path(path)
    if not p.exists():
        return None
    total = sum(f.stat().st_size for f in p.rglob("*") if f.is_file())
    return total / 1024 / 1024

@torch.inference_mode()
def perplexity(model, tokenizer, device):
    total_nll = 0.0
    total_tokens = 0
    for text in EVAL_TEXTS:
        batch = tokenizer(text, return_tensors="pt").to(device)
        out = model(**batch, labels=batch["input_ids"])
        tokens = max(batch["input_ids"].numel() - 1, 1)
        total_nll += out.loss.item() * tokens
        total_tokens += tokens
    return math.exp(total_nll / total_tokens)

@torch.inference_mode()
def p50_latency_ms(model, tokenizer, device):
    batch = tokenizer(PROMPT, return_tensors="pt").to(device)

    # 先 warm-up,避免首次 kernel 初始化影响正式测量。
    for _ in range(2):
        model.generate(**batch, max_new_tokens=24, do_sample=False)

    samples = []
    for _ in range(5):
        sync(device)
        start = time.perf_counter()
        model.generate(**batch, max_new_tokens=24, do_sample=False)
        sync(device)
        samples.append((time.perf_counter() - start) * 1000)
    return statistics.median(samples)

def evaluate(name, model, tokenizer, device, artifact_path=None):
    model.to(device).eval()
    params_m = sum(p.numel() for p in model.parameters()) / 1e6
    result = {
        "name": name,
        "ppl": perplexity(model, tokenizer, device),
        "p50_ms": p50_latency_ms(model, tokenizer, device),
        "params_m": params_m,
        "artifact_mb": artifact_mb(artifact_path) if artifact_path else None,
    }
    print(result)

def cleanup(device):
    gc.collect()
    if device.type == "cuda":
        torch.cuda.empty_cache()

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--base", required=True)
    parser.add_argument("--full", required=True)
    parser.add_argument("--adapter", required=True)
    args = parser.parse_args()

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    tokenizer = AutoTokenizer.from_pretrained(args.base)

    base = AutoModelForCausalLM.from_pretrained(args.base)
    evaluate("base", base, tokenizer, device)
    del base
    cleanup(device)

    full = AutoModelForCausalLM.from_pretrained(args.full)
    evaluate("full", full, tokenizer, device, args.full)
    del full
    cleanup(device)

    peft_base = AutoModelForCausalLM.from_pretrained(args.base)
    peft_model = PeftModel.from_pretrained(peft_base, args.adapter)
    evaluate("peft", peft_model, tokenizer, device, args.adapter)
    del peft_model
    cleanup(device)

if __name__ == "__main__":
    main()
运行时把 <PATH> 替换成实际 checkpoint 与 adapter 目录:
python compare_models.py --base distilgpt2 --full <PATH>/full-checkpoint --adapter <PATH>/peft-adapter预期输出形态:
{'name': 'base', 'ppl': <PPL>, 'p50_ms': <MS>, 'params_m': <PARAMS_M>, 'artifact_mb': None}
{'name': 'full', 'ppl': <PPL>, 'p50_ms': <MS>, 'params_m': <PARAMS_M>, 'artifact_mb': <ARTIFACT_MB>}
{'name': 'peft', 'ppl': <PPL>, 'p50_ms': <MS>, 'params_m': <PARAMS_M>, 'artifact_mb': <ARTIFACT_MB>}<PPL>、<MS>、<PARAMS_M> 和 <ARTIFACT_MB> 都由实际模型、硬件与文件格式决定。这里不预填数字,是为了避免把示例环境的结果误当成你的基准。
把指标变成部署判断
先看质量门槛,而不是先看成本。如果全量微调明显优于 PEFT,并且这部分提升会直接影响业务结果,那么更大的训练和存储成本可能值得承担;如果两者在固定评估集上处于同一波动区间,PEFT 往往更有吸引力,因为训练产物更小、版本迭代更轻。
再看延迟。PEFT adapter 在推理时仍需要基座模型,adapter 文件小并不等于部署时只需要这一小份参数;如果运行框架支持合并 adapter,可额外评估合并前后的延迟与产物大小。全量微调模型通常参数量与基座相同,但需要保存一整份独立权重。
最后保留基座结果作为真正的参照线。若微调模型只得到极小质量增益,却显著增加延迟、显存或维护成本,说明微调不一定值得进入部署阶段;相反,若 PEFT 已跨过质量门槛且延迟满足 SLA,就没有必要仅因为“全量微调更彻底”而默认选择它。
让比较结果可复现
评估记录至少要绑定评估集版本、模型或 adapter 版本、代码提交、Transformers 与 PyTorch 版本、硬件型号、精度模式和随机种子。数据集一变、生成参数一变或硬件一换,都应视为新的 benchmark,而不是和旧结果直接混排。
真正可复现的模型比较不是一张“最高分榜单”,而是一组可以重新运行、重新解释的证据:相同输入条件下,质量是否提升、延迟是否过线、额外成本是否值得。只有这三类证据同时成立,候选模型才有充分理由进入部署阶段。