
大模型原理与训练 / 系统课时
用 FastAPI 部署文本服务
用 FastAPI 部署文本服务
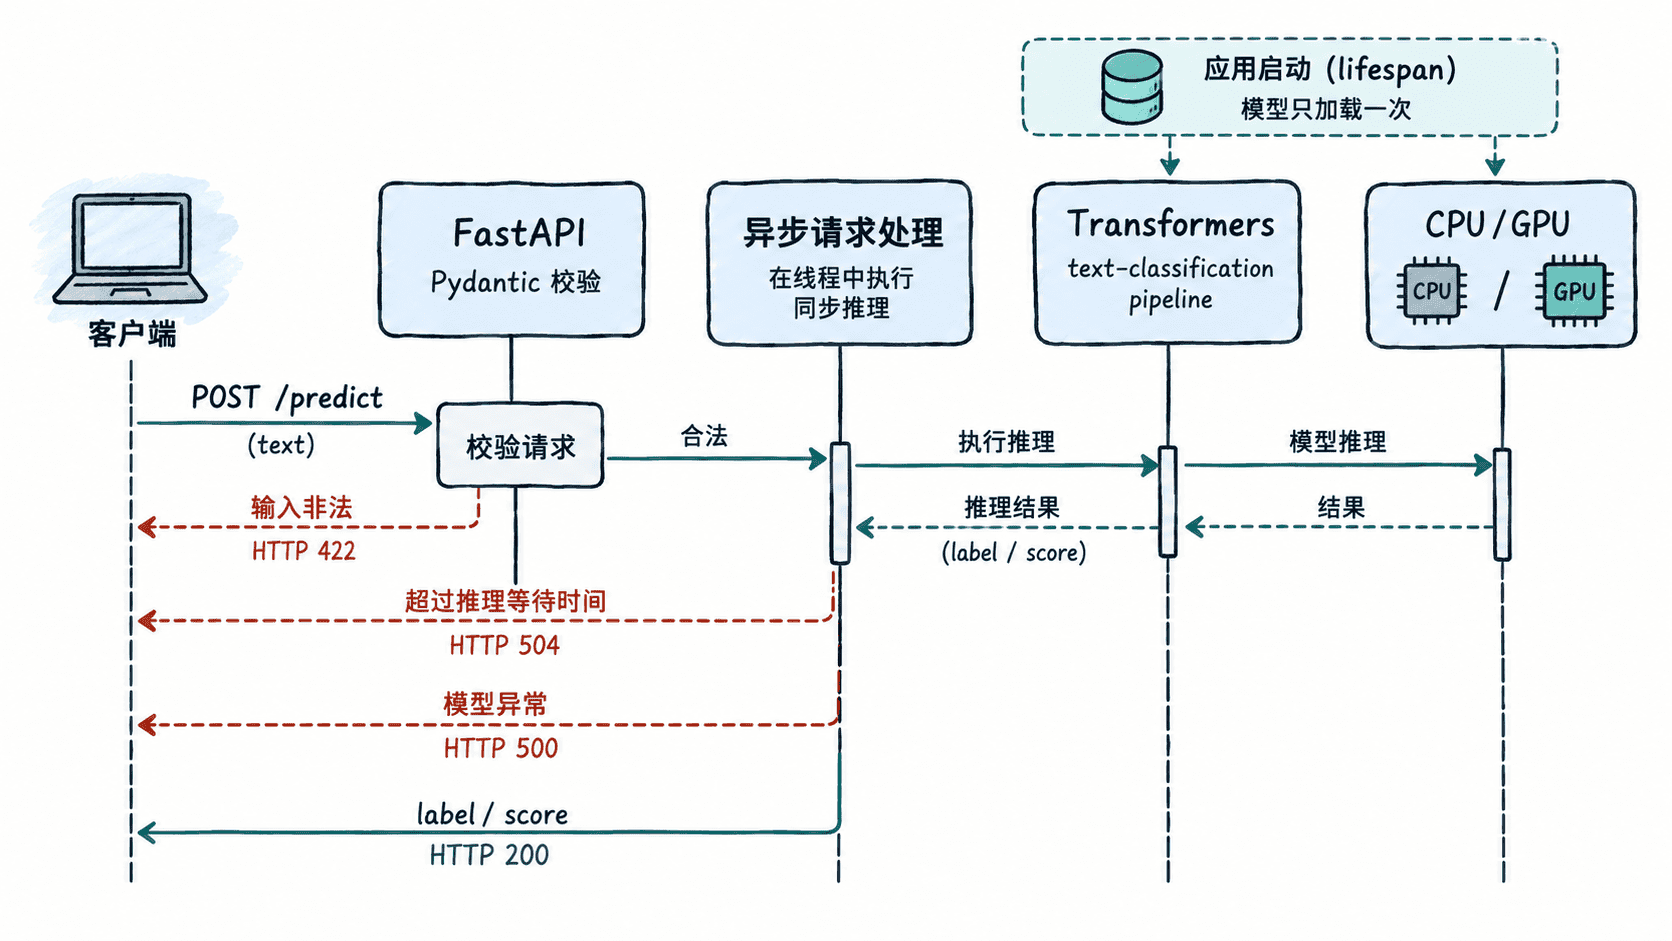
这一节把 Hugging Face 文本分类模型包装成可调用的 HTTP 服务:模型只在应用启动时加载一次,请求先经过输入校验,再执行带超时控制的推理,并把成功、校验失败和推理异常转换成稳定的 HTTP 返回。
学习目标
- 用 FastAPI 的输入输出模型约束推理接口
- 为同步模型推理增加超时与错误映射
- 启动服务并用真实 HTTP 请求验证返回结果
设计服务边界
服务只暴露两个端点:/healthz 用于确认模型已就绪,/predict 接收一段文本并返回最高分标签。模型加载放在应用 lifespan 中,而不是每次请求时重新创建,这样请求路径只承担校验和推理。
输入长度需要显式限制。它既能尽早拒绝明显异常的请求,也避免调用方用超长文本把 tokenizer、CPU/GPU 时间和内存消耗推到不可控区间。输出则固定为 label 与 score,让客户端不依赖 Transformers pipeline 的内部对象结构。
实现推理端点
下面的 app.py 是完整示例。asyncio.to_thread 避免同步 pipeline 直接阻塞事件循环,asyncio.wait_for 给 HTTP 等待设置上限;异常信息不直接返回给客户端,避免泄露服务内部细节。
import asyncio
import os
from contextlib import asynccontextmanager
from typing import Any

import torch
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from transformers import pipeline

MODEL_ID = "distilbert/distilbert-base-uncased-finetuned-sst-2-english"
TIMEOUT_SECONDS = float(os.getenv("INFERENCE_TIMEOUT_SECONDS", "3.0"))
models: dict[str, Any] = {}

class PredictRequest(BaseModel):
    text: str = Field(min_length=1, max_length=1000)

class PredictResponse(BaseModel):
    label: str
    score: float

@asynccontextmanager
async def lifespan(app: FastAPI):
    # 模型在服务启动阶段加载一次,后续请求复用同一实例。
    device = 0 if torch.cuda.is_available() else -1
    models["classifier"] = pipeline(
        "text-classification",
        model=MODEL_ID,
        device=device,
    )
    yield
    models.clear()

app = FastAPI(lifespan=lifespan)

@app.get("/healthz")
async def healthz():
    if "classifier" not in models:
        raise HTTPException(status_code=503, detail="model not ready")
    return {"status": "ok"}

@app.post("/predict", response_model=PredictResponse)
async def predict(req: PredictRequest):
    classifier = models.get("classifier")
    if classifier is None:
        raise HTTPException(status_code=503, detail="model not ready")

    try:
        # pipeline 是同步调用,放到工作线程后再给本次 HTTP 等待设置上限。
        result = await asyncio.wait_for(
            asyncio.to_thread(classifier, req.text),
            timeout=TIMEOUT_SECONDS,
        )
    except TimeoutError as exc:
        raise HTTPException(status_code=504, detail="inference timeout") from exc
    except Exception as exc:
        raise HTTPException(status_code=500, detail="inference failed") from exc

    top = result[0]
    return PredictResponse(label=top["label"], score=float(top["score"]))
预期结果
保存为 app.py 后,Uvicorn 可以导入 app:app;应用启动时加载一次模型,/predict 对合法文本返回 label 与 score。这里的超时是 HTTP 等待上限,不是 GPU 任务的硬中断。线程中的同步推理已经开始后,即使客户端收到 504,底层计算仍可能继续执行;生产环境还需要配合并发上限、队列或进程级隔离,防止超时请求继续占用计算资源。
启动并验证真实调用
先确保环境中已经安装 fastapi、uvicorn[standard]、transformers 和 torch,再启动服务。首次运行如果本地没有模型权重,加载阶段还会发生模型下载。
uvicorn app:app --host 127.0.0.1 --port 8000预期输出
INFO:     Application startup complete.
INFO:     Uvicorn running on http://127.0.0.1:8000
模型下载日志与进程号可能不同;关键验收点是出现启动完成,并且进程持续监听 8000 端口。随后在另一个终端发送真实请求:
curl -sS -X POST http://127.0.0.1:8000/predict \
  -H 'Content-Type: application/json' \
  -d '{"text":"I love this course."}'
预期输出
{"label":"POSITIVE","score":<SCORE>}<SCORE> 是 0 到 1 之间的实际模型得分,具体数值可能随模型与运行版本略有差异。若 text 为空或超过 1000 个字符,FastAPI 会在进入推理前返回 422;若推理等待超过 INFERENCE_TIMEOUT_SECONDS,接口返回 504 和 {"detail":"inference timeout"}。
交付时应守住的边界
开发环境直接用单个 Uvicorn 进程就能验证接口,但不要把“能返回 200”当成已经具备生产容量。GPU 模型通常还需要限制同时进入推理区的请求数,并把排队时间、推理时间和总延迟分开监控;否则并发升高后,504 只会把压力从客户端隐藏起来,而不会让计算自动消失。
这个最小服务已经形成可验收的闭环:输入有边界、输出有模式、启动阶段加载模型、推理有 HTTP 超时、异常有稳定状态码,并且可以通过真实 curl 请求确认端到端路径。