
大模型原理与训练 / 系统课时
做并发压测与容量估算
做并发压测与容量估算
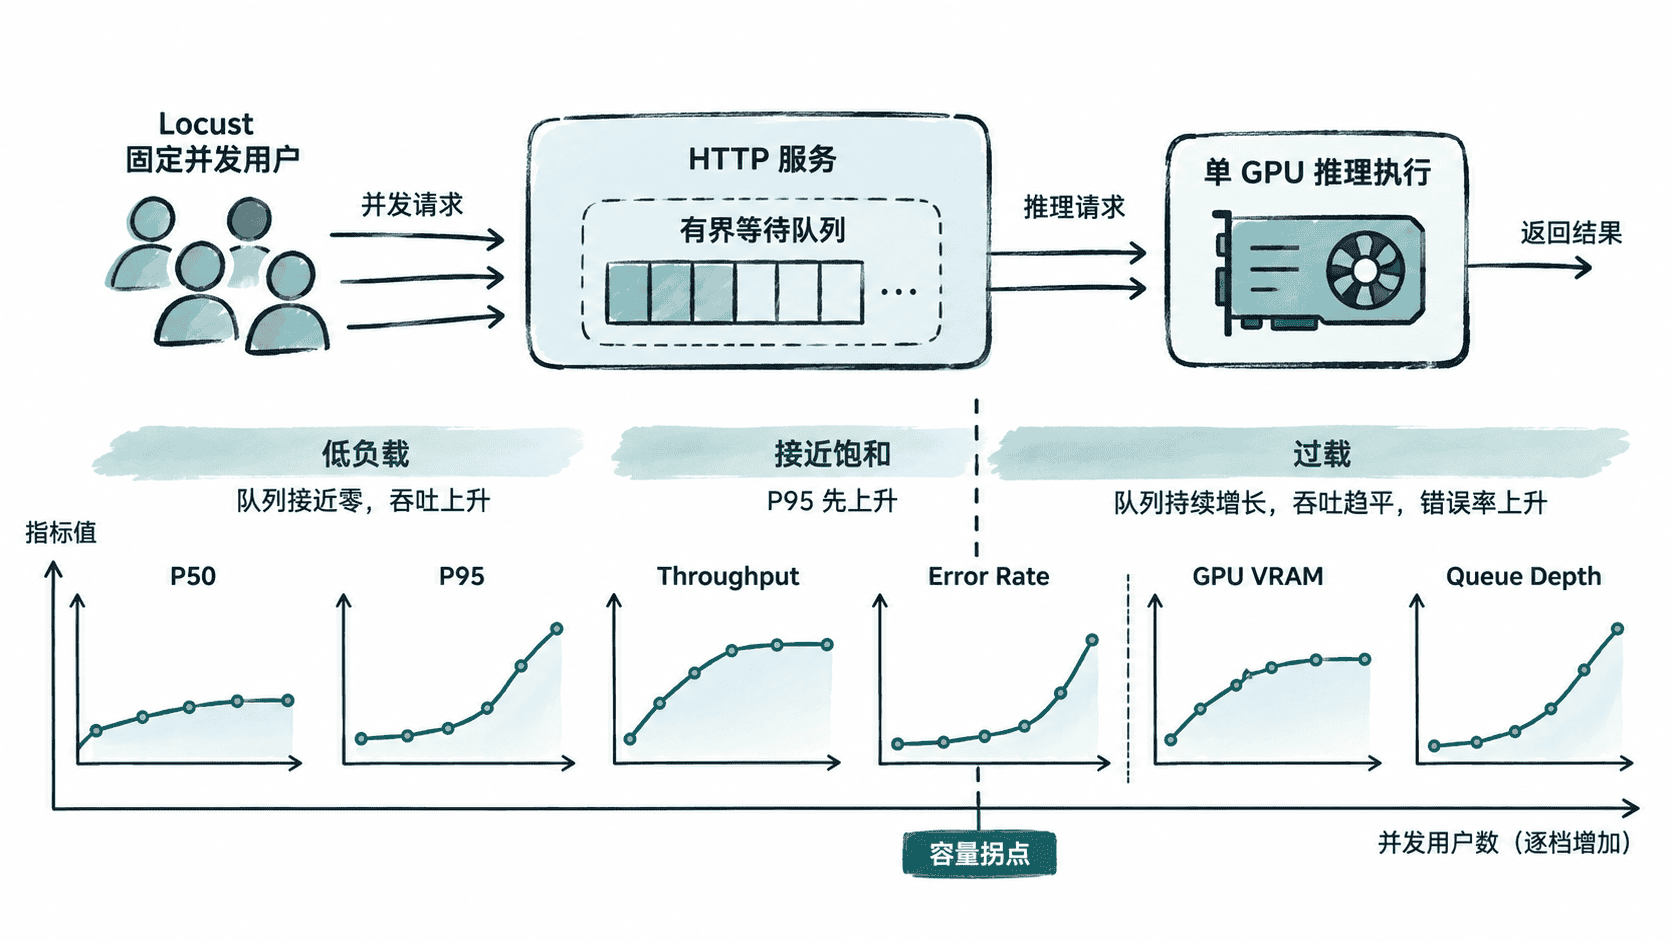
这一节不追求一次“跑出很高的 QPS”,而是用固定并发重复压测同一个推理端点,同时记录 P50、P95、吞吐和错误率,再结合显存占用与服务端队列是否持续增长,确定单实例真正可长期承载的安全并发。
学习目标
- 用固定并发生成可重复的 HTTP 推理负载
- 从 P50、P95、吞吐和错误率识别容量拐点
- 结合 GPU 显存与队列长度给出单实例并发上限
固定测试条件
容量测试最怕变量一起变化。每一轮只改变并发用户数,模型、输入文本、请求超时、实例规格、批处理参数和测试时长都保持不变;先预热模型,再正式采样,避免把权重加载、CUDA 初始化或缓存冷启动混进稳态结果。
P50 表示一半请求能在该延迟内完成,P95 用来观察长尾;吞吐看单位时间完成多少请求,错误率看过载是否已经转化为失败。单看平均延迟会掩盖排队,一次测试也不能证明容量稳定。
写一个固定并发压测脚本
下面使用 Locust 模拟持续调用 /predict 的用户。constant(0) 表示一个用户完成请求后立即发起下一次,因此 -u 8 会形成最多 8 个持续闭环用户;这更适合寻找服务在固定并发下的稳态吞吐,而不是模拟真实到达分布。
from locust import HttpUser, constant, task

PAYLOAD = {"text": "I love this course."}

class PredictUser(HttpUser):
    wait_time = constant(0)

    @task
    def predict(self):
        # catch_response 让协议成功但业务结构异常也计入失败。
        with self.client.post(
            "/predict",
            json=PAYLOAD,
            timeout=10,
            catch_response=True,
            name="POST /predict",
        ) as response:
            if response.status_code != 200:
                response.failure(f"HTTP {response.status_code}")
                return

            data = response.json()
            if "label" not in data or "score" not in data:
                response.failure("invalid response schema")
预期结果
脚本会把所有推理请求聚合到 POST /predict,并将非 200 或缺少 label/score 的响应计为失败。在模型已经预热、服务端没有其他流量时执行一轮 8 并发、持续 2 分钟的测试,并把统计写入 CSV:
locust -f locustfile.py --headless \
  --host http://127.0.0.1:8000 \
  -u 8 -r 8 -t 2m \
  --csv load
预期结果
P50 = <P50_MS> ms
P95 = <P95_MS> ms
Throughput = <RPS> req/s
Failures = <FAILURES>/<REQUESTS>
这些占位符必须用本机实测值替换。Locust 终端统计和 load_stats.csv 可提供请求数、失败数、吞吐与延迟分布;不同版本的表头可能略有差异,因此容量结论应基于指标含义,而不是依赖某一版终端排版。
找到容量拐点
固定每轮时长后,按 1、2、4、8、12、16 等并发逐档重复测试。每档至少记录 P50、P95、RPS、错误率、GPU 已用显存和服务端 queue_depth。如果服务没有队列指标,应先从应用并发控制器、任务队列或反向代理导出它;只有客户端延迟时,很难区分“真正计算变慢”和“请求在等空位”。
容量拐点通常不是“GPU 显存刚好用满”。更可靠的判据是:并发继续增加后,吞吐增长明显变缓,而 P95 或队列长度快速上升。此时新增请求主要在排队,继续提高并发只会扩大长尾,甚至触发 504、连接超时或显存不足。
错误率可直接按 $failures / requests$ 计算。对于稳定运行区间,还可以用 $L = RPS * W_{avg}$ 交叉检查平均在途请求数,其中 W_{avg} 必须使用平均端到端延迟,不能把 P95 直接代入这个关系。
用显存与队列给并发设上限
显存给出的是硬资源上界。先测模型空闲时的常驻显存 M_model,再测并发从 1 增加时每个额外在途请求带来的近似显存增量 M_request,并预留框架缓存、碎片和临时张量空间 M_reserve。粗略上界可写成 $C_{mem} = (M_{total} - M_{model} - M_{reserve}) / M_{request}$,最后向下取整。
这个公式只能作为上界,因为激活大小会随序列长度、batch、dtype 和模型结构变化。真正可上线的并发 C_safe 应取满足业务 SLO 的最大测试档位:P95 不超过目标、错误率低于阈值、队列长度在整轮测试中不持续增长,并且显存始终保留安全余量。
例如 8 并发时吞吐仍随负载增长、P95 平稳、队列接近零,而 12 并发时吞吐几乎不再增长且队列持续累积,那么单实例容量应先定在 8 或更低,而不是因为 12 并发“还能返回部分请求”就把 12 当作容量。
形成可复现的容量结论
最终记录不要只写“单卡约 10 QPS”。至少保留模型版本、输入长度、batch 策略、硬件型号、并发档位、测试时长、P50、P95、RPS、错误率、峰值显存和最大队列长度。只有这些条件一起保存,后续换模型、量化、batch 或 GPU 后才有可比较的基线。
容量估算的核心是找到 持续稳定区间:吞吐还能随并发增加而增长,P95 没有失控,错误率可接受,队列不会越积越多,显存也留有余量。超过这个区间后,再提高客户端并发不等于服务能力变强,只是在把等待和失败推迟到更后面。