
大模型原理与训练 / 系统课时
登录 Hub 并管理模型缓存
登录 Hub 并管理模型缓存
本节要把“能下载模型”变成可控流程:明确令牌用于什么、缓存实际落在哪里、重复下载为什么发生,以及断网后如何验证本地缓存是否足够。完成后,你能区分权限错误、缓存问题和真正的网络问题。
学习目标
- 使用
hf auth login完成 Hub 登录,并理解公开、受限与私有仓库的访问边界。 - 通过
HF_HOME与HF_HUB_CACHE固定缓存位置,避免多个环境各存一份。 - 验证已缓存文件可以离线读取,并定位磁盘占用与重复下载问题。
先分清认证与仓库权限
公开仓库通常可以匿名下载;私有仓库需要有权限的账号,受限模型还要求账号先获得对应仓库的访问资格。登录只能证明“你是谁”,不能自动绕过仓库的授权条件。
本机交互环境优先使用 hf auth login 保存凭据。CI 或容器中可以通过秘密管理系统注入 HF_TOKEN,但不要把令牌写进脚本、Git 仓库或镜像层。下载用途通常只需要满足读取范围的令牌。
固定缓存根目录
HF_HOME 是 Hugging Face 本地数据的总根目录,HF_HUB_CACHE 专门指定 Hub 仓库缓存。团队项目最好在运行前统一它们,否则系统默认目录、项目目录和容器卷可能分别保存同一模型。
| 设置 | 作用 | 常见用途 |
|---|---|---|
HF_HOME |
令牌与缓存等本地数据的根目录 | 统一项目或容器中的 Hugging Face 数据位置 |
HF_HUB_CACHE |
模型、数据集与 Space 的 Hub 缓存目录 | 把大文件放到指定磁盘或持久卷 |
HF_HUB_OFFLINE |
禁止 Hub 网络访问 | 验证离线环境是否已具备所需文件 |
缓存内部按仓库和 revision 组织,并通过快照引用实际文件。重复调用同一 revision 的同一文件通常会复用已有缓存;切换缓存根目录、下载新的 revision 或强制重新下载,则可能继续增加磁盘占用。
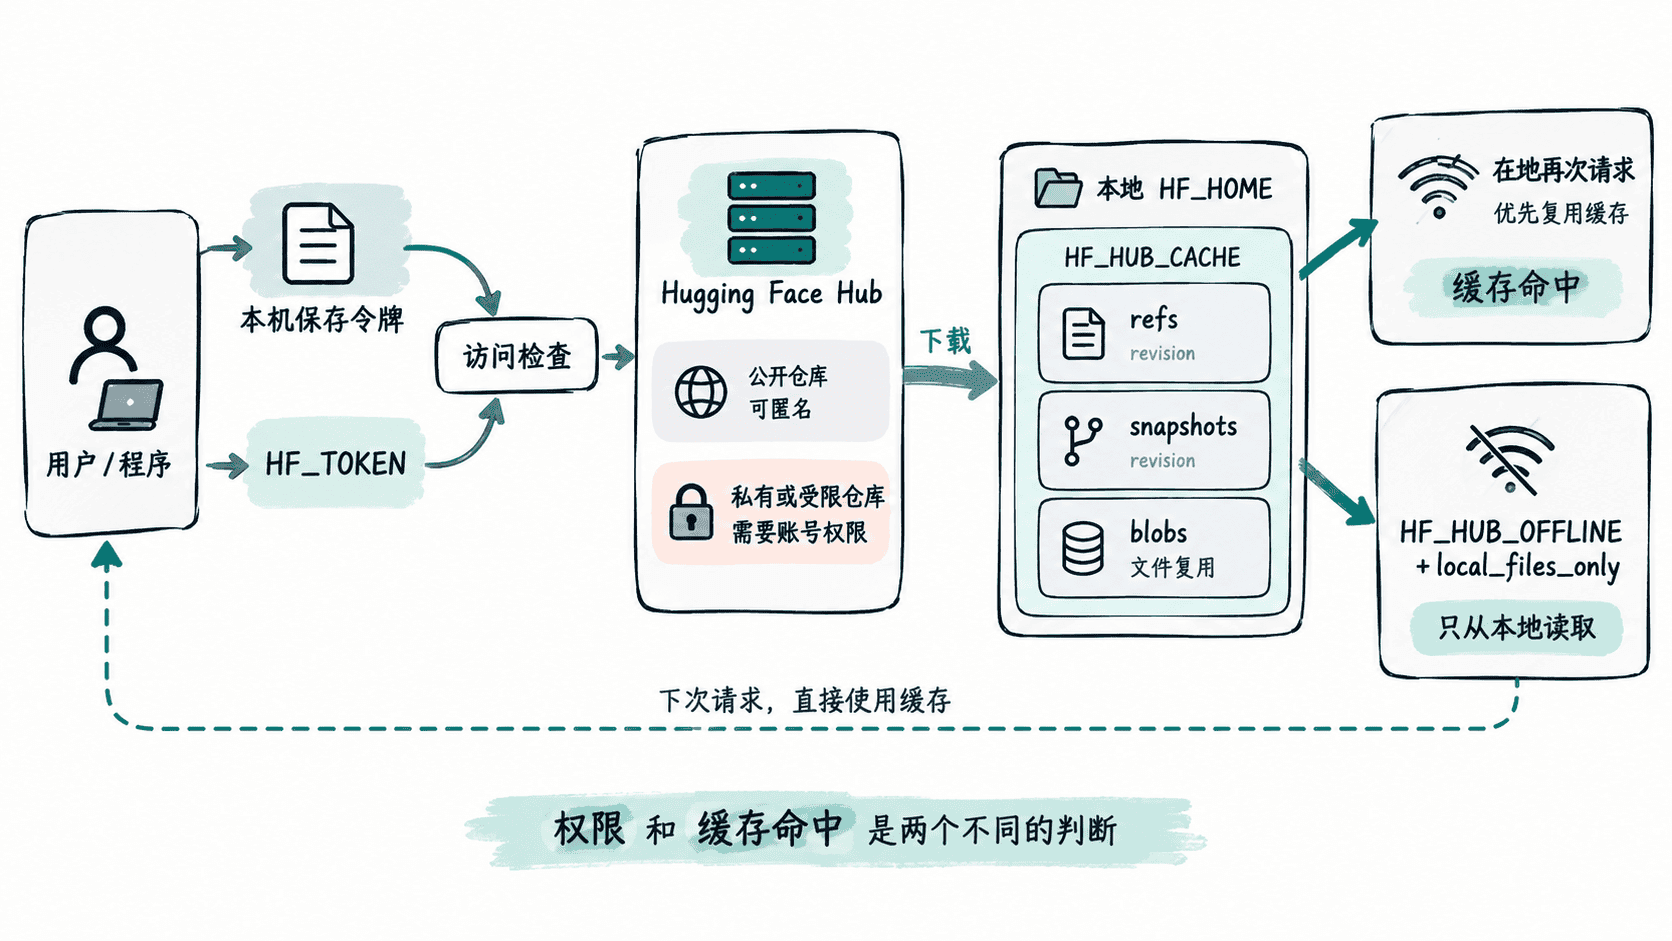
完成登录、下载和离线验证
下面的 Bash 示例把缓存固定在当前项目的 .hf 目录,只下载公开 gpt2 仓库中的 config.json,因此不会拉取完整模型权重。
python -m pip install -U huggingface_hub
export HF_HOME="$PWD/.hf"
export HF_HUB_CACHE="$HF_HOME/hub"

hf auth login
hf auth whoami
hf download gpt2 config.json --quiet
du -sh "$HF_HOME"

HF_HUB_OFFLINE=1 python - <<'PY'
from huggingface_hub import hf_hub_download

# local_files_only=True 保证这一步不会用网络补文件。
path = hf_hub_download("gpt2", "config.json", local_files_only=True)
print(path)
PY
预期输出:终端在登录阶段会显示交互提示,其余关键结果类似下面的形式,具体账号、路径、revision ID 与目录大小会不同。
<ACCOUNT_INFO>
<PATH>/.hf/hub/models--gpt2/snapshots/<ID>/config.json
<SIZE> <PATH>/.hf
<PATH>/.hf/hub/models--gpt2/snapshots/<ID>/config.json
最后一行能在 HF_HUB_OFFLINE=1 下出现,说明 config.json 已经可以完全从本地缓存读取。
处理重复下载、空间与离线失败
看到“每次都下载”时,先比较不同进程的 HF_HOME 和 HF_HUB_CACHE 是否一致,再检查是否切换了 revision、容器是否每次创建临时文件系统,以及是否显式要求强制下载。只清理 snapshots 或 blobs 中的单个文件容易破坏引用关系,清理时应按完整仓库或明确不再需要的 revision 管理。
如果在线访问返回未授权或禁止访问,优先检查账号是否已获得受限仓库权限、当前登录账号是否正确,以及令牌是否有读取能力;这类问题不是删除缓存就能解决。
如果设置 HF_HUB_OFFLINE=1 后仍能读取,说明当前任务所需文件已经在本地。若离线模式直接报缺失文件,则应在有网络的环境中先下载完整依赖,并保持相同缓存目录或把缓存持久化到目标机器。这样才能把“下载成功一次”真正转化为可重复、可审计的模型运行环境。