
大模型原理与训练 / 系统课时
固定随机性与保存实验配置
固定随机性与保存实验配置
同一份训练代码,如果随机种子、模型提交、数据版本或依赖环境发生变化,指标就可能失去可比性。本节把这些变量收进一份实验清单,让一次 Hugging Face 训练能够被定位、复核和尽量重现。
学习目标
- 固定训练与数据采样相关的随机性,并理解随机种子的边界
- 记录模型 revision、数据 revision、训练参数、运行环境和代码状态
- 用一份机器可读清单为每次实验建立可追踪身份
随机种子只是复现链条的一环
Transformers 的 seed 影响模型初始化及训练中的随机过程,data_seed 可单独控制数据采样。两次实验如果这两个值不同,即使其他参数一致,也不应直接比较最终指标。
但“种子相同”不等于“位级结果必然相同”。GPU 算子、CUDA/cuDNN 版本、分布式执行顺序和混合精度都可能引入非确定性。TrainingArguments 的 full_determinism=True 会启用更严格的确定性路径,适合复现排查,但通常会牺牲训练性能。
真正可复现的实验身份至少要同时固定随机性、输入模型、输入数据、训练参数、代码和运行环境。
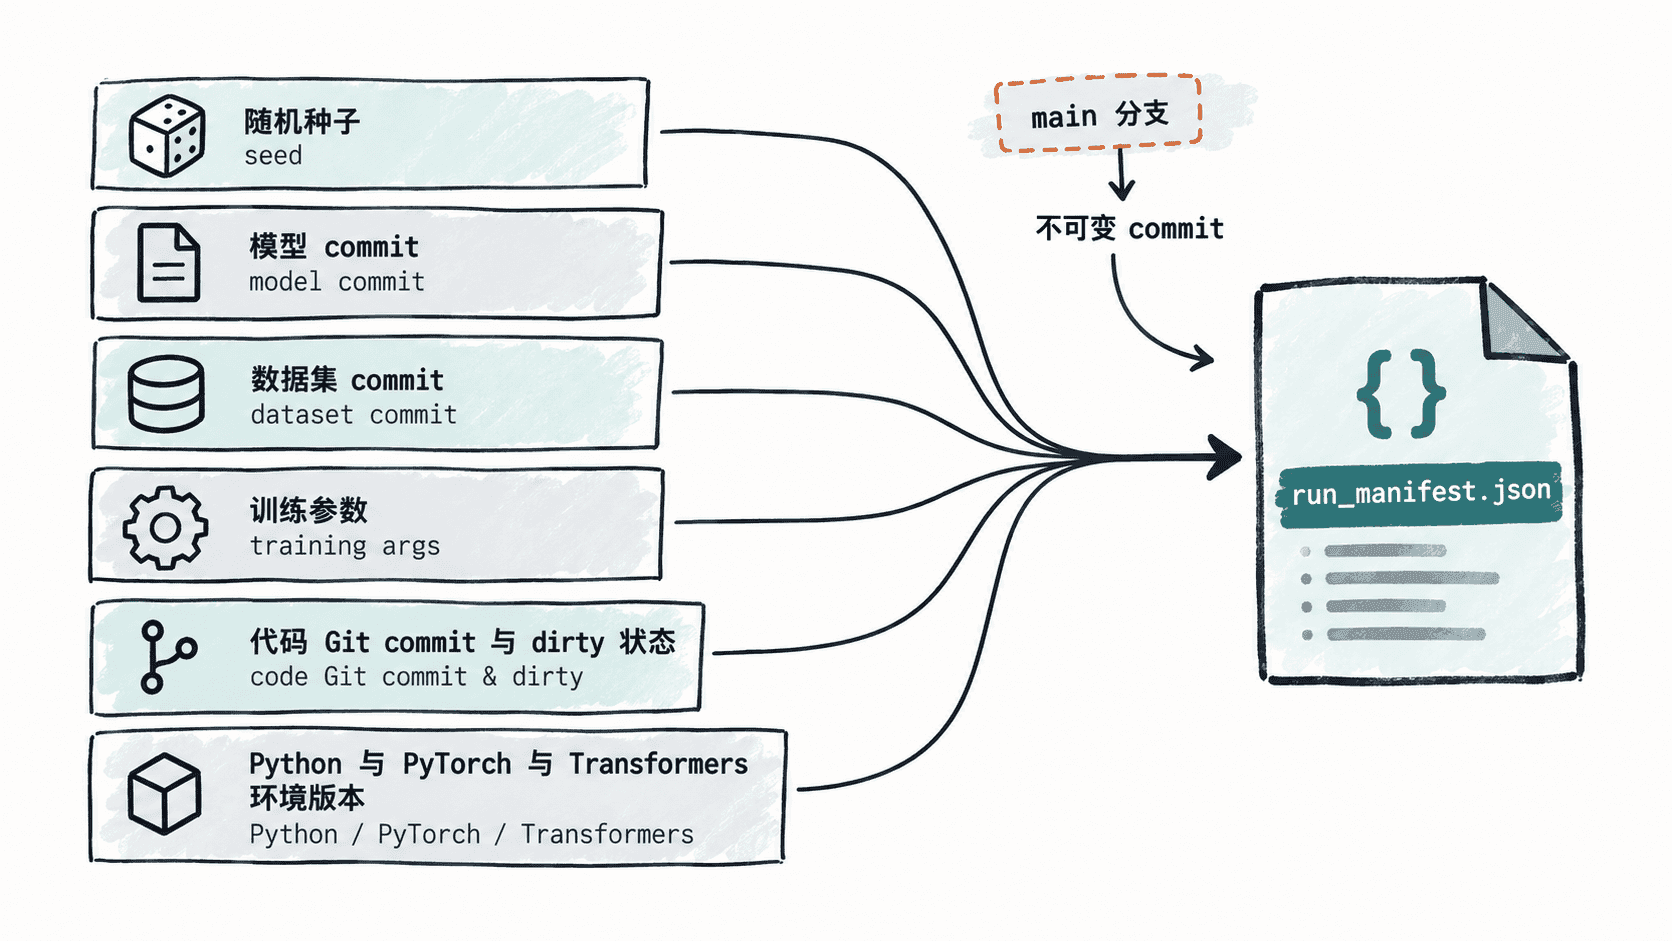
生成一份运行清单
下面的脚本先设置种子,再把 Hub 上可变的 main 解析成当前不可变提交,并保存核心训练参数、包版本和 Git 状态。需要安装 transformers、torch 与 huggingface_hub,并在联网环境中运行。
import json
import platform
import subprocess
from pathlib import Path

import torch
import transformers
from huggingface_hub import HfApi
from transformers import set_seed

SEED = 42
MODEL_ID = "distilbert/distilbert-base-uncased"
DATASET_ID = "stanfordnlp/imdb"

def git_value(*args):
    try:
        return subprocess.check_output(
            ["git", *args],
            text=True,
            stderr=subprocess.DEVNULL,
        ).strip()
    except (FileNotFoundError, subprocess.CalledProcessError):
        return "unavailable"

# 在创建模型、DataLoader 或其他随机对象之前固定随机状态。
set_seed(SEED)
api = HfApi()

# 把可移动的 main 解析为本次实际读取到的不可变提交。
model_revision = api.model_info(MODEL_ID, revision="main").sha
dataset_revision = api.dataset_info(DATASET_ID, revision="main").sha

training_args = {
    "learning_rate": 2e-5,
    "num_train_epochs": 3,
    "per_device_train_batch_size": 16,
    "seed": SEED,
    "data_seed": SEED,
    "full_determinism": True,
}

status = git_value("status", "--porcelain")
manifest = {
    "model": {"id": MODEL_ID, "revision": model_revision},
    "dataset": {"id": DATASET_ID, "revision": dataset_revision},
    "training_args": training_args,
    "code": {
        "git_commit": git_value("rev-parse", "HEAD"),
        "dirty": None if status == "unavailable" else bool(status),
    },
    "environment": {
        "python": platform.python_version(),
        "platform": platform.platform(),
        "torch": torch.__version__,
        "transformers": transformers.__version__,
        "cuda": torch.version.cuda,
    },
}

Path("run_manifest.json").write_text(
    json.dumps(manifest, ensure_ascii=False, indent=2),
    encoding="utf-8",
)

print(f"seed={SEED}")
print(f"model_revision={model_revision}")
print(f"dataset_revision={dataset_revision}")
print("manifest=run_manifest.json")
预期输出
seed=42
model_revision=<ID>
dataset_revision=<ID>
manifest=run_manifest.json
<ID> 是运行时解析出的完整提交哈希,仓库后续更新后可能不同。生成的 run_manifest.json 才是这次实验的事实记录;不要只在文档里写“使用 main 分支”,因为 main 会移动。
用清单驱动下一次复现实验
记录版本的目的不是存档,而是让下一次运行真正使用相同输入。重新加载模型和数据时,应把清单中的 commit 传给对应的 revision;训练时把同一组参数传给 TrainingArguments,而不是重新手填一份“差不多”的配置。
如果数据还经过 map、过滤、重采样或自定义切分,仅保存 Hub 数据集 revision 仍然不够,还要保存这些处理参数和代码提交。代码仓库处于 dirty 状态时也要谨慎:未提交修改意味着仅凭 Git commit 无法恢复当时源码。
一个实验只有在“输入版本 + 参数 + 代码 + 环境”都能被还原时,才真正具备可比较性。这样即使数周后重跑,也能先判断差异来自模型本身,还是来自环境漂移。