
大模型原理与训练 / 系统课时
划分训练验证测试数据
划分训练验证测试数据
这节要把一份带标签的数据稳定拆成 train、validation 和 test,同时控制随机性、类别比例与数据泄漏。完成后你会得到可直接交给 Hugging Face 训练流程的 DatasetDict,并知道哪些数据必须在最终评估前保持“不可见”。
学习目标
- 用固定随机种子创建训练、验证、测试三份数据
- 在分类任务中使用分层划分保持类别比例
- 识别重复样本、未来信息和预处理拟合造成的数据泄漏
三份数据各自承担什么职责
train 用来拟合模型参数;validation 用来选超参数、决定早停和比较实验;test 只用于最后一次独立评估。最常见的错误不是比例设成 8:1:1 还是 7:2:1,而是反复查看测试集结果再继续调参,这会让测试集事实上变成验证集。
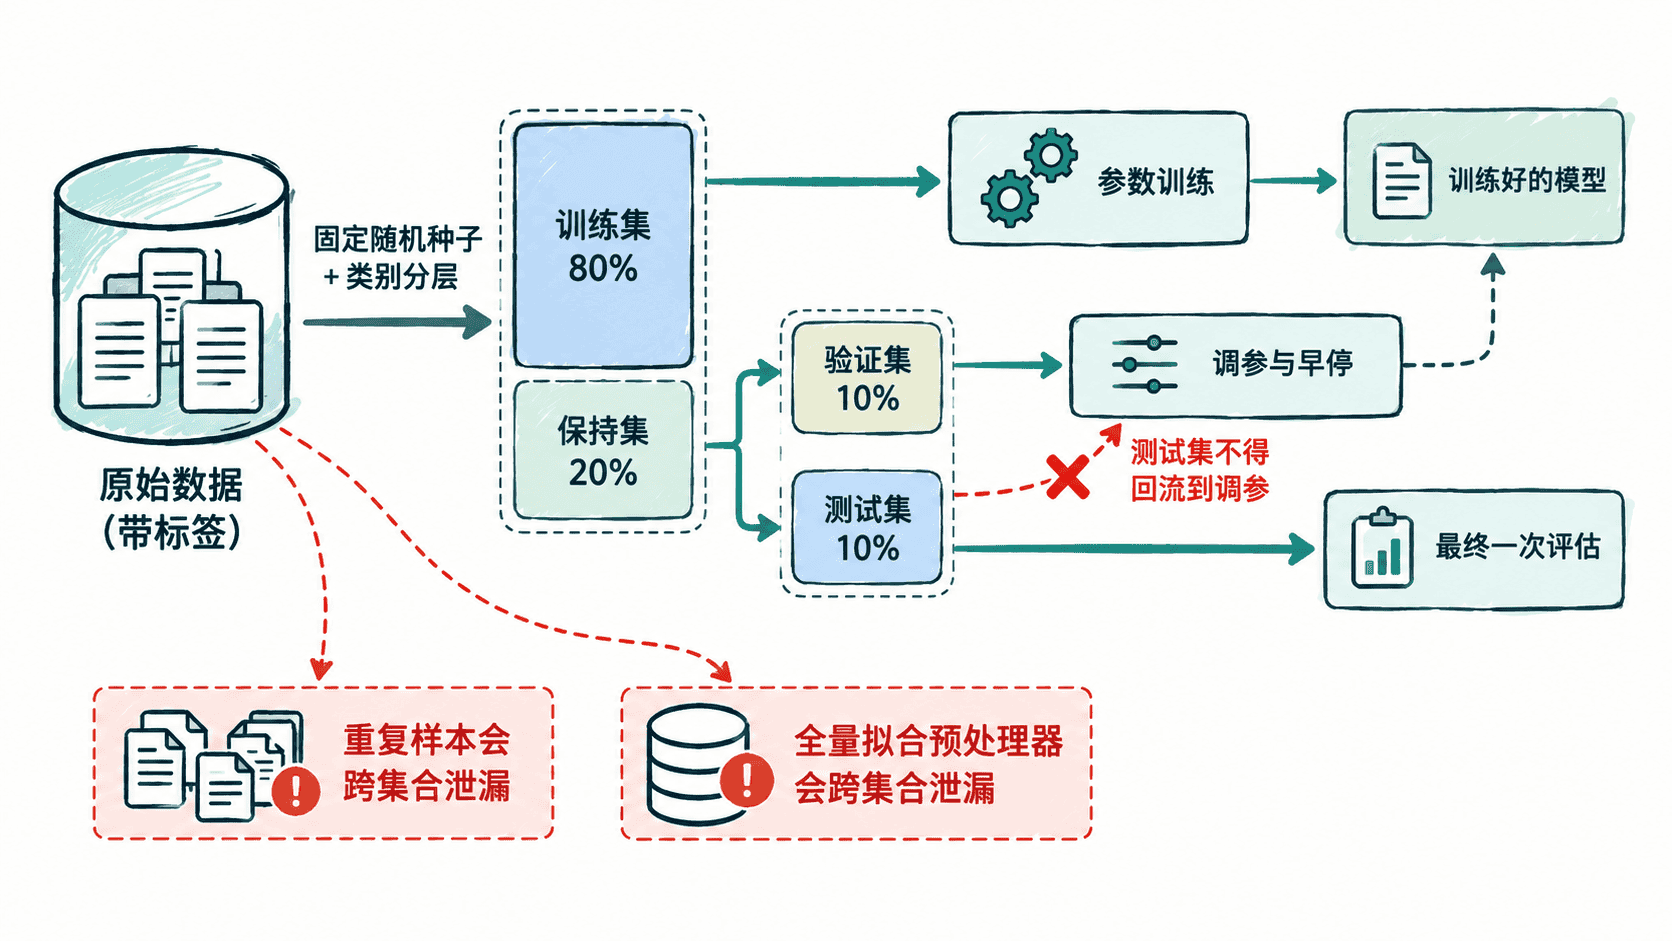
用分层划分构造 DatasetDict
分类数据不均衡时,纯随机切分可能让小类别在验证集或测试集中太少。datasets.Dataset.train_test_split() 支持 stratify_by_column,但该列需要是 ClassLabel,因此下面先编码标签,再做两次分层划分。
from datasets import Dataset, DatasetDict

data = Dataset.from_dict(
    {
        "text": [f"sample-{i}" for i in range(20)],
        "label": [0, 1] * 10,
    }
).class_encode_column("label")

# 第一次切出 20% 留出集,固定 seed 让实验可复现。
first_split = data.train_test_split(
    test_size=0.2,
    seed=42,
    stratify_by_column="label",
)

# 第二次把留出集等分为 validation 与 test。
second_split = first_split["test"].train_test_split(
    test_size=0.5,
    seed=42,
    stratify_by_column="label",
)

datasets = DatasetDict(
    {
        "train": first_split["train"],
        "validation": second_split["train"],
        "test": second_split["test"],
    }
)

for name, ds in datasets.items():
    counts = {label: ds["label"].count(label) for label in (0, 1)}
    print(name, len(ds), counts)
预期输出
train 16 {0: 8, 1: 8}
validation 2 {0: 1, 1: 1}
test 2 {0: 1, 1: 1}
这里的两次 seed=42 只负责复现划分结果,不代表训练阶段也已经完全可复现;模型初始化、数据加载器和底层算子仍可能需要单独设置随机种子。
先分组,再随机
如果同一用户、设备、文档或原始样本能产生多条记录,逐行随机划分可能把高度相似的数据分到不同集合。例如同一篇文章切出的两个段落分别进入训练集和测试集,模型就可能凭近似文本“认出”测试样本。
这类数据应先确定不可跨集合的分组键,再按组切分。时间序列或预测未来的任务则通常按时间切分:训练数据早于验证数据,验证数据早于测试数据。此时不应为了保持类别比例而打乱时间顺序。
划分后的验收
真正开始训练前,至少确认三件事:三个集合的样本数符合预期;分类任务的标签比例没有异常漂移;按业务主键检查后不存在跨集合重复或近重复样本。之后把测试集冻结起来,训练和调参阶段只读取 train 与 validation,最终报告指标时再使用 test,评估结果才有独立性。