
自动控制 / 系统课时
对比PID和状态反馈的控制效果
对比PID和状态反馈的控制效果
把两种控制器接到同一个质量弹簧阻尼模型上,固定参考、采样和限幅,再比较位置响应、控制指令与实际作用力。本篇用可运行仿真得到量化结果,并说明速度测量、积分抗扰和模型误差怎样影响控制器选择。
学习目标
- 在参考位移0.1 m、采样周期0.01 s、作用力限幅±1 N的条件下复现实验。
- 读出超调率、2%调节时间、指令峰值和饱和持续时间,判断是否满足要求。
- 区分位置测量PID与全状态反馈的输入信息,说明前置增益与积分的不同作用。
固定对象与验收条件
取质量 kg、阻尼 N·s/m、弹簧刚度 N/m。位置为,速度为,实际执行器作用力为;模型写成:
两组实验分别从零状态启动,不能让第二个控制器沿用第一个实验的末状态。控制器增益是两套示范整定,并不代表各方法的最优参数。
| 项目 | 两组共同设置 |
|---|---|
| 参考与初态 | 从0跳到0.1 m;位置、速度均为0 |
| 采样与记录 | 每0.01 s计算一次,记录12 s |
| 执行器 | 限于−1~1 N,每拍内保持不变 |
| 环境 | 无外力扰动、无测量噪声、无额外计算延迟 |
| 验收目标 | 超调率不超过5%,2%调节时间不超过3 s,实际力不超过1 N |
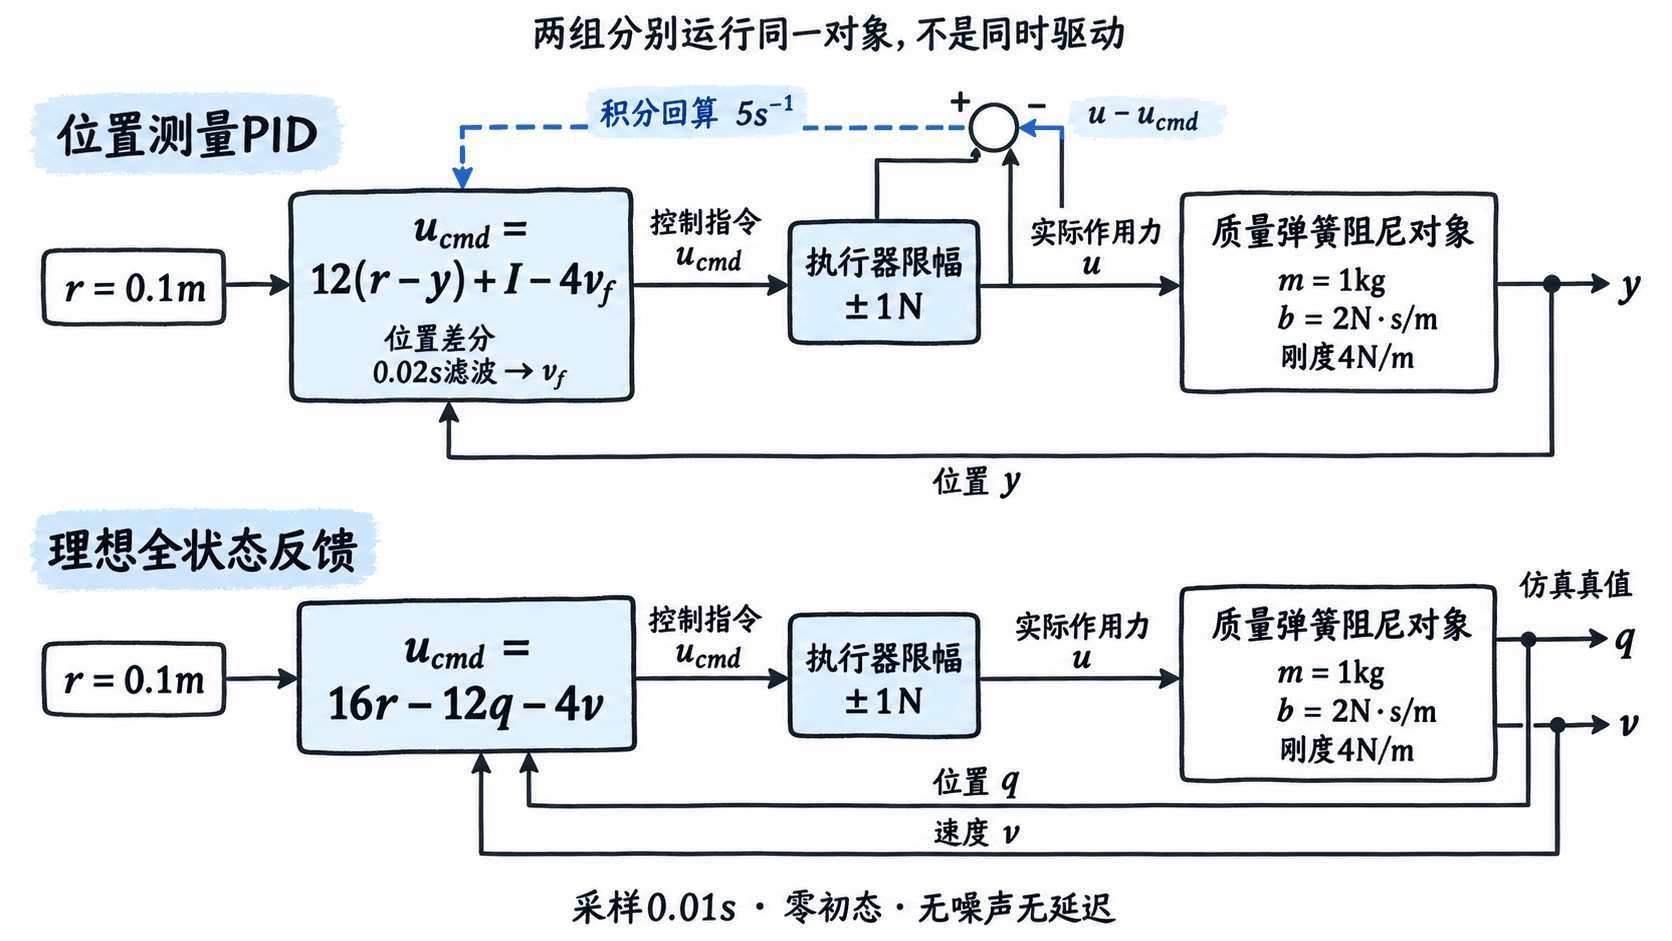
测量信息暂不强行相同:PID只读取位置,状态反馈读取理想的位置和速度。后者的额外信息必须在最后的实现比较中计入。
写出两种控制律
PID取 N/m、 N/(m·s)、 N·s/m。微分作用于位置测量,参考阶跃不会直接触发微分冲击。用 s的一阶滤波计算速度近似值:
以表示单位为N的积分输出,控制指令为。先将指令限幅得到,再以回算增益 s⁻¹更新下一拍积分:
积分输出、滤波速度及上一拍位置均从0开始。饱和差回算可抑制限幅时积分继续向错误方向累积;这里固定采用先输出、后更新积分的顺序,保证正文与代码使用同一离散算法。
状态反馈采用,并给参考配置前置增益:
标称稳态满足、,因此才能使。未限幅的连续闭环特征多项式为;采样和饱和后的实际指标仍由仿真核对。
运行同一套采样仿真
下例已在Python 3.12、NumPy 2.3.5、SciPy 1.17.0环境核对,依赖为NumPy与SciPy。cont2discrete的method="zoh"按零阶保持离散化对象;每拍使用限幅后的力更新对象状态。API说明。genui{"citation":{"ref":"turn1search0"}}
import numpy as np
from scipy.signal import cont2discrete

DT, T_END, REF, LIMIT = 0.01, 12.0, 0.1, 1.0
A = np.array([[0.0, 1.0], [-4.0, -2.0]])
B = np.array([[0.0], [1.0]])
C, D = np.array([[1.0, 0.0]]), np.zeros((1, 1))
Ad, Bd, _, _, _ = cont2discrete((A, B, C, D), DT, method="zoh")
KP, KI, KD, TAU, KAW = 12.0, 8.0, 4.0, 0.02, 5.0
K, N = np.array([12.0, 4.0]), 16.0
steps = round(T_END / DT)
time = np.arange(steps + 1) * DT

def simulate(kind):
    # 两组实验各自重置对象与控制器,不能串接上一次的末状态。
    x = np.zeros(2)
    integral_force = filtered_velocity = previous_y = 0.0
    y = np.zeros(steps + 1)
    command, force = np.zeros(steps), np.zeros(steps)
    for i in range(steps):
        y[i] = x[0]
        error = REF - y[i]
        if kind == "PID":
            # 只用位置差分;滤波微分不读取真实速度 x[1]。
            filtered_velocity = (TAU * filtered_velocity + y[i] - previous_y) / (TAU + DT)
            command[i] = KP * error + integral_force - KD * filtered_velocity
        else:
            command[i] = N * REF - K @ x
        force[i] = np.clip(command[i], -LIMIT, LIMIT)
        if kind == "PID":
            # 先限幅,再回算积分;本次更新供下一拍使用。
            integral_force += DT * (KI * error + KAW * (force[i] - command[i]))
            previous_y = y[i]
        x = Ad @ x + Bd[:, 0] * force[i]
    y[-1] = x[0]
    return y, command, force

def report(kind, y, command, force):
    # 搜索最后一个越界点,避免把首次穿越误差带当作调节完成。
    outside = np.flatnonzero(np.abs(y - REF) > 0.02 * REF)
    settling = (0.0 if outside.size == 0 else
                np.nan if outside[-1] == steps else time[outside[-1] + 1])
    ts_text = f"{settling:.2f}s" if np.isfinite(settling) else "unsettled"
    overshoot = max(0.0, (y.max() / REF - 1.0) * 100.0)
    saturated = np.count_nonzero(np.abs(command) > LIMIT) * DT
    print(f"{kind}: overshoot={overshoot:.2f}%, ts={ts_text}, y_end={y[-1]:.6f}m")
    print(f"  peak_cmd={np.max(np.abs(command)):.3f}N, "
          f"peak_u={np.max(np.abs(force)):.3f}N, sat={saturated:.2f}s")

if __name__ == "__main__":
    for name in ("PID", "SF"):
        report(name, *simulate(name))
预期输出:
PID: overshoot=0.00%, ts=2.48s, y_end=0.099996m
  peak_cmd=1.200N, peak_u=1.000N, sat=0.08s
SF: overshoot=2.79%, ts=1.45s, y_end=0.100000m
peak_cmd=1.600N, peak_u=1.000N, sat=0.15speak_cmd是未限幅指令峰值,peak_u是实际施加力峰值,sat是12 s内发生限幅的累计时长。y_end只是末时刻位置,不能直接当成无限时间的精确稳态值。
结合响应与作用力判断代价
指标按0.01 s采样点统计,0.1 m参考的2%误差带是0.098~0.102 m。代码从最后一次越界后寻找调节时刻,要求余下记录都留在带内;若末采样仍越界则输出unsettled。有限时窗内的调节时间不等于长期稳定性的证明。
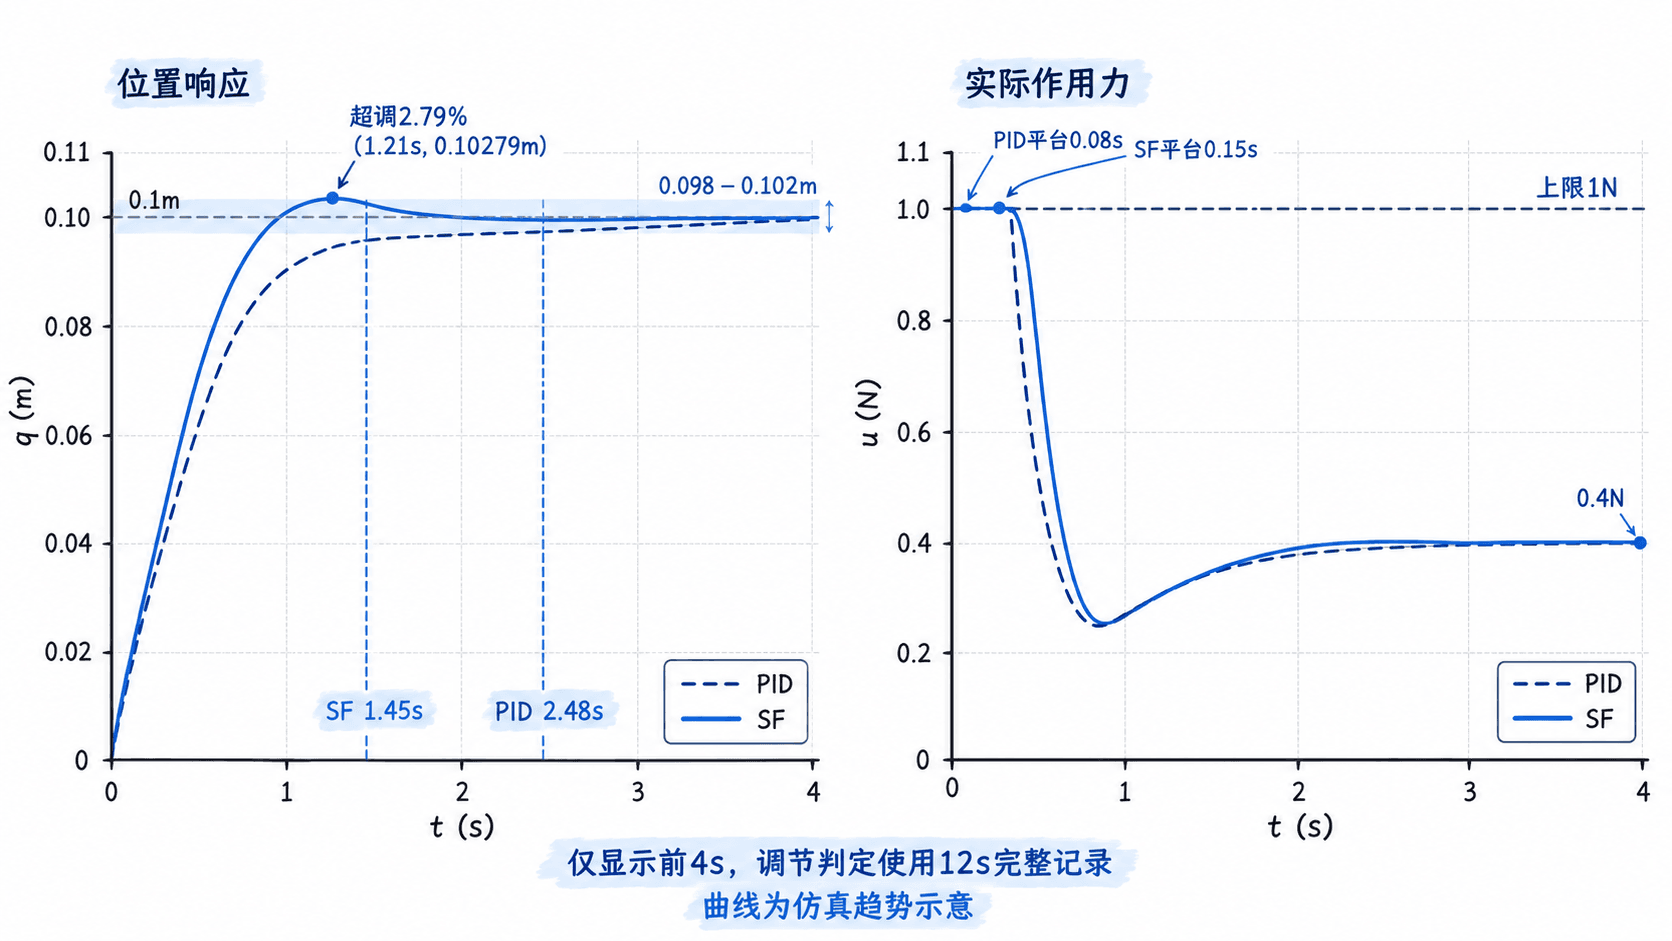
两组均通过本例验收。当前状态反馈用1.45 s进入并保持在误差带内,伴随2.79%超调;当前PID无超调,但需要2.48 s。这里比较的是给定整定和测量条件,不能据此断言状态反馈总比PID快。
两组实际峰值都是1 N,因为执行器都碰到了上限。状态反馈请求过1.6 N,PID请求过1.2 N;前者饱和0.15 s,后者0.08 s。因此,仅凭实际峰值相同,不能判断两者对执行器的需求相同。
把测量与恒定负载纳入选择
| 实际可用信息 | 可采用的实现与检查项 |
|---|---|
| 只有位置 | 本例PID可直接使用;保留0.02 s微分滤波,并用实际噪声检验控制量抖动 |
| 位置和速度均可测 | 可实现本例状态反馈;检查两路采样是否同步、速度噪声是否可接受 |
| 只有位置但要采用状态反馈 | 增加观测器,用位置和实际施加力估计速度;重新测量调节时间与控制峰值 |
本例状态反馈读取仿真真值,不含观测误差。实际只能测位置时,不能把x[1]继续视为免费可用的速度;观测器应接收限幅后的,否则其内部模型使用的力与对象受到的力不一致。
再考虑持续外力 N,即模型右侧变成。这组无积分状态反馈的稳态位置为 m。恢复0.1 m需要执行器提供 N,尚在±1 N范围内。
当滤波速度等于真实速度时,本例PID可写成,同样包含状态反馈与积分。PID的积分可在闭环稳定且执行器余量足够时消除这种恒定偏差;状态反馈增广积分状态也能做到。前置增益依赖标称模型,不会自动补偿未知恒定负载。CTMS说明。genui{"citation":{"ref":"turn0search0"}}
若项目把调节时间收紧到2 s,当前状态反馈参数通过,当前PID需要重新整定;若项目只有位置传感器,则还须把速度估计的误差与延迟加入这套测试,再决定是否采用状态反馈。