
自动控制 / 系统课时
用极点配置计算状态反馈增益
用极点配置计算状态反馈增益
本篇用一个二阶机械系统,把“超调不超过 5%、2% 调节时间不超过 2.2 秒”转换为闭环极点,算出状态反馈增益,并用仿真核对输出和控制力。完成后,你能判断增益是否算对、跟踪是否达标以及执行器是否够用。
学习目标
- 根据可控矩阵的秩,判断两个闭环极点能否任意配置。
- 由期望极点 手算并编程求出状态反馈增益 。
- 同时检查闭环特征值、阶跃响应和控制力,区分稳定性与跟踪性能。
明确状态、反馈符号和可控性
考虑质量 kg、阻尼 N·s/m、弹簧刚度 N/m 的系统。取位移 、速度 为状态,输入 是力,输出 是位移:
采用状态反馈 ,其中 是 矩阵。代回状态方程,闭环矩阵为 。要任意配置全部两个极点,先检查可控矩阵:
秩等于状态数,说明本例两个极点都可配置。若秩小于 2,改变 也不能任意移动全部极点,应先检查模型和执行器作用位置;不能把求解器返回一个数值矩阵当成配置成功。
从响应指标选择目标极点
本例验收目标为:零初态下跟踪 1 m 阶跃,超调不超过 5%,进入 m 后不再越界的时间不超过 2.2 s。连续系统的稳定极点应位于左半平面,非实极点须共轭成对,才能保持实数增益。
对无零点、直流增益为 1 的标准二阶系统,写极点为 ,其中 控制衰减速度, 是阻尼振荡角频率。超调和常用调节时间估算为:
取 、,得到目标极点 。此时自然频率 rad/s,阻尼比 ,预计超调 4.32%、调节时间约 2 s。
2 s 是初选估算,并非严格保证。 后面必须用最后一次越出误差带的时间验收;高阶系统或带零点的系统,也不能仅凭这组二阶公式宣称满足指标。
比较特征多项式求出增益
将 代入闭环矩阵,其第二行为 。实际与目标特征多项式分别为:
比较系数:、,得到 ,即 。这一控制律用于把状态拉回原点;跟踪非零常值参考还需明确参考怎样进入系统。
本例使用 ,其中 是参考前置增益。令稳态导数为零,可得 。为了使标称模型满足 ,取:
这个 公式适用于 、闭环稳定且 的单输入单输出系统。若只写 ,本例单位参考的稳态输出只有 0.125 m;改变 不改变闭环极点。
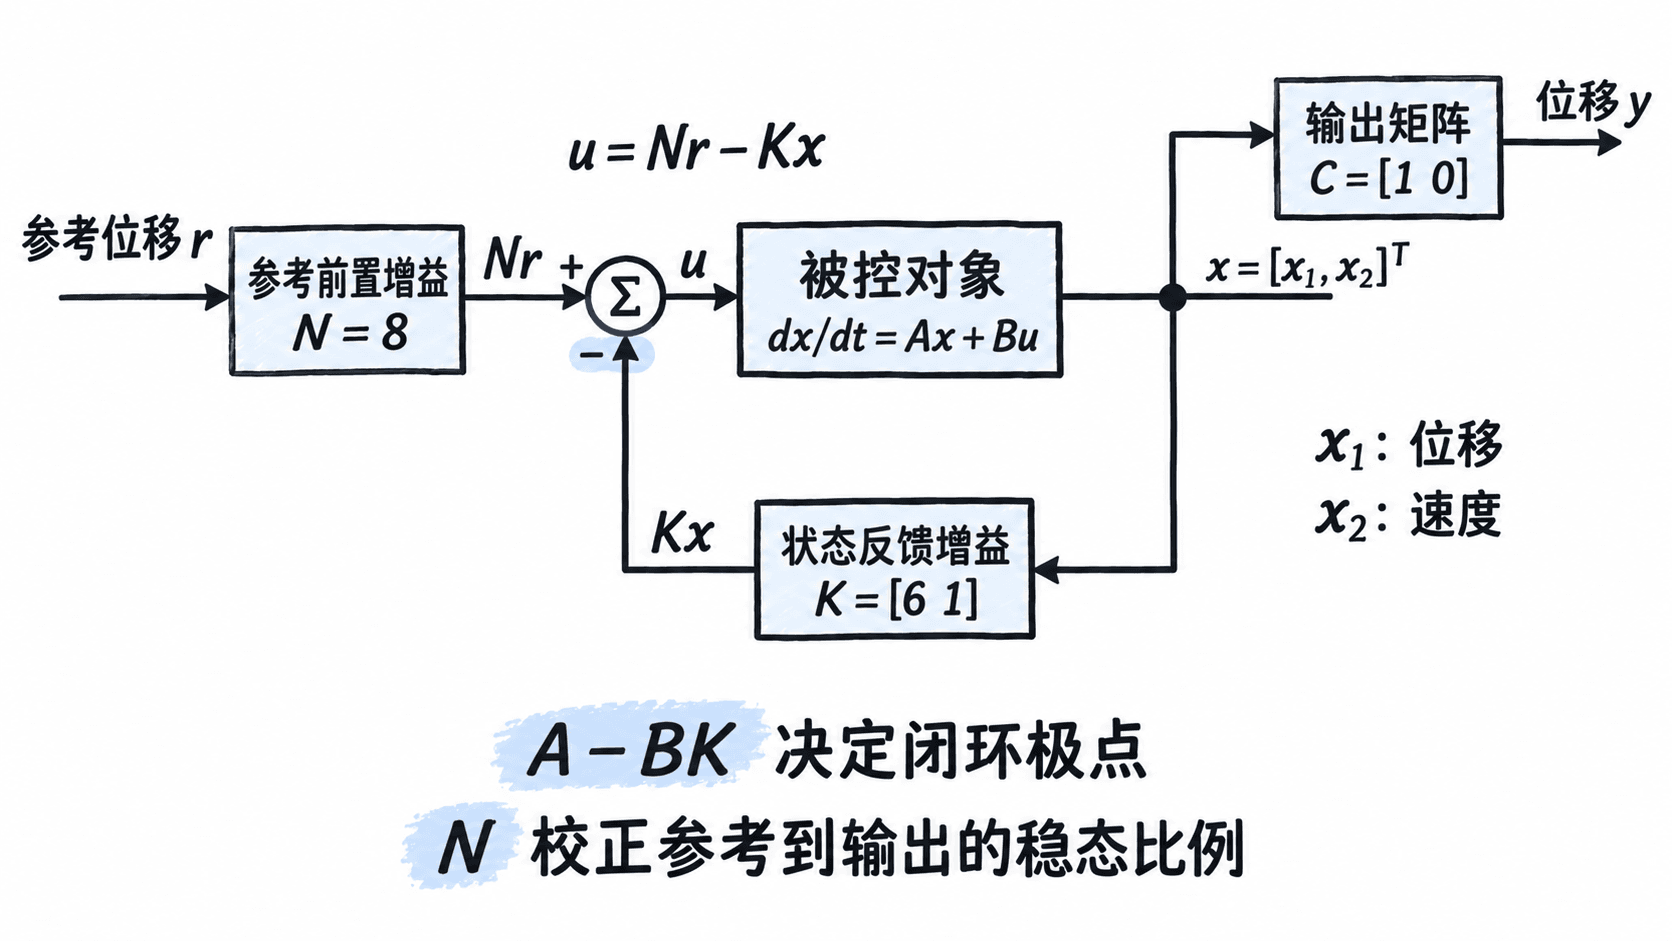
用代码验证极点、响应与控制力
示例在 Python 3.12、NumPy 2.3.5、SciPy 1.17.0 下核验,运行环境需已安装 NumPy 和 SciPy。将代码保存为 pole_placement.py,执行 python pole_placement.py。
place_poles 返回的增益对应 ,复极点使用 method="YT";lsim 要求时间数组非负、递增且等间隔,并返回输出及状态轨迹。接口依据 place_poles 文档 与 lsim 文档。genui{"citation":{"refs":["turn1view0","turn2view1"]}}
import numpy as np
from scipy.signal import StateSpace, lsim, place_poles

A = np.array([[0., 1.], [-2., -3.]])
B = np.array([[0.], [1.]])
C = np.array([[1., 0.]])
# 可控性不足时,不能靠重复调用求解器解决。
rank = np.linalg.matrix_rank(np.hstack((B, A @ B)))
assert rank == A.shape[0], "系统不可控,不能任意配置全部极点"

# 复极点使用 YT,反馈符号固定为 u = -Kx + Nr。
poles = np.array([-2. + 2.j, -2. - 2.j])
K = place_poles(A, B, poles, method="YT").gain_matrix
Acl = A - B @ K
eigs = np.sort_complex(np.linalg.eigvals(Acl))
assert np.allclose(eigs, np.sort_complex(poles))

# 求解线性方程得到 N,避免显式求逆。
N = -1. / (C @ np.linalg.solve(Acl, B)).item()
system = StateSpace(Acl, B * N, C, np.zeros((1, 1)))
t = np.linspace(0., 8., 8001)
r = np.ones_like(t)
_, y, x = lsim(system, U=r, T=t, X0=[0., 0.])
u = N * r - (x @ K.T).ravel()

# 取最后一次越界后的采样点;末端仍越界则延长仿真。
bad = np.flatnonzero(np.abs(y - 1.) > 0.02)
if bad.size and bad[-1] == len(t) - 1:
    raise RuntimeError("末端仍在误差带外,请延长仿真时间")
ts = t[bad[-1] + 1] if bad.size else 0.

print(f"rank = {rank}")
print(f"K = [{K[0, 0]:.3f}, {K[0, 1]:.3f}], N = {N:.3f}")
print("poles =", ", ".join(f"{z.real:.3f}{z.imag:+.3f}j" for z in eigs))
print(f"y(8s) = {y[-1]:.4f}, overshoot = {(y.max() - 1.) * 100:.2f}%")
print(f"settling_2pct = {ts:.3f}s, peak_abs_u = {np.max(np.abs(u)):.3f}")
预期输出:
rank = 2
K = [6.000, 1.000], N = 8.000
poles = -2.000-2.000j, -2.000+2.000j
y(8s) = 1.0000, overshoot = 4.32%
settling_2pct = 2.109s, peak_abs_u = 8.000
特征值与目标一致,超调 4.32% 小于 5%,调节时间 2.109 s 小于 2.2 s,因此本例通过响应验收。控制力绝对值峰值为 8 N;y(8s) 显示 1.0000 是四舍五入结果,不代表有限时刻误差严格为零。
这里以 1 ms 间隔检查 0~8 s 内的响应,2.109 s 是最后越界后的第一个采样点。首次进入误差带不能算调节时间;一般系统还需确认仿真时长足以覆盖慢模态,避免把尚未出现的再次越界漏掉。
把执行器和模型误差纳入验收
把极点改成 ,按相同方法重算 和 。阻尼比未变,理想超调仍为 4.32%,响应时间缩短一半,但零初态下的阶跃初始控制力明显增加:
| 目标极点 | 状态反馈增益 | 前置增益 | 1 m 阶跃的初始控制力 |
|---|---|---|---|
| 8 | 8 N | ||
| 32 | 32 N |
若执行器限制为 N,第一组在本次测试中未触发限幅,第二组起步就会饱和。出现限幅后,不能继续用固定矩阵 代表整段真实运动;应放慢目标极点或调整参考轨迹,再做含限幅的仿真。
实现时必须取得位移和速度两个状态。若只有位移传感器,需要增加速度测量或设计状态观测器;不能把单个输出 当作完整状态 ,也不能交换状态顺序后继续原样使用 。
前置增益也不等于积分抗扰:若在对象输入端额外叠加恒定 1 N 扰动力,第一组控制器的稳态位移将变成 m。需要消除这类常值误差时,应增广误差积分状态并重新设计反馈,不能只调整 。