
大模型原理与训练 / 系统课时
部署量化模型并验证显存收益
部署量化模型并验证显存收益
量化 checkpoint 能加载成功,只说明模型格式被引擎接受,并不代表显存压缩已经转化为更高服务容量。本篇用固定负载做 A/B 基准,分别记录峰值显存、TTFT、TPOT 与吞吐,再判断量化是否值得上线。
学习目标
- 在相同服务参数下分别启动高精度与量化模型
- 用固定上下文、并发和输出长度采集峰值显存、TTFT、TPOT 与吞吐
- 判断权重压缩是否真正换来了更高并发或更低延迟
先固定唯一变量
A/B 测试时只允许模型权重精度变化。GPU 型号、驱动、推理引擎版本、最大上下文、并发数、输入文本、最大输出 token、采样参数和预热次数都应保持一致,否则显存或延迟差异无法归因给量化。
| 维度 | 基线组 | 量化组 |
|---|---|---|
| 模型 | BF16/FP16 checkpoint | 同一基座模型的量化 checkpoint |
| 最大上下文 | 相同 | 相同 |
| 并发 | 相同 | 相同 |
| 最大输出长度 | 相同 | 相同 |
| 推理引擎与启动参数 | 相同 | 除量化识别参数外保持相同 |
| 预热 | 相同请求数 | 相同请求数 |
以支持 OpenAI 兼容接口的 vLLM 为例,分别把 <MODEL> 替换成高精度和量化 checkpoint,且两次启动使用同一个 <PORT> 和相同的 --max-model-len。如果 checkpoint 没有可识别的量化元数据,再按引擎要求显式指定量化类型,不要顺手修改其他调度参数。
vllm serve <MODEL> --host 127.0.0.1 --port <PORT> --max-model-len 4096预期结果:
服务进程持续运行,并在 http://127.0.0.1:<PORT> 提供 OpenAI 兼容接口;模型名、初始化耗时和日志内容会随实际环境变化。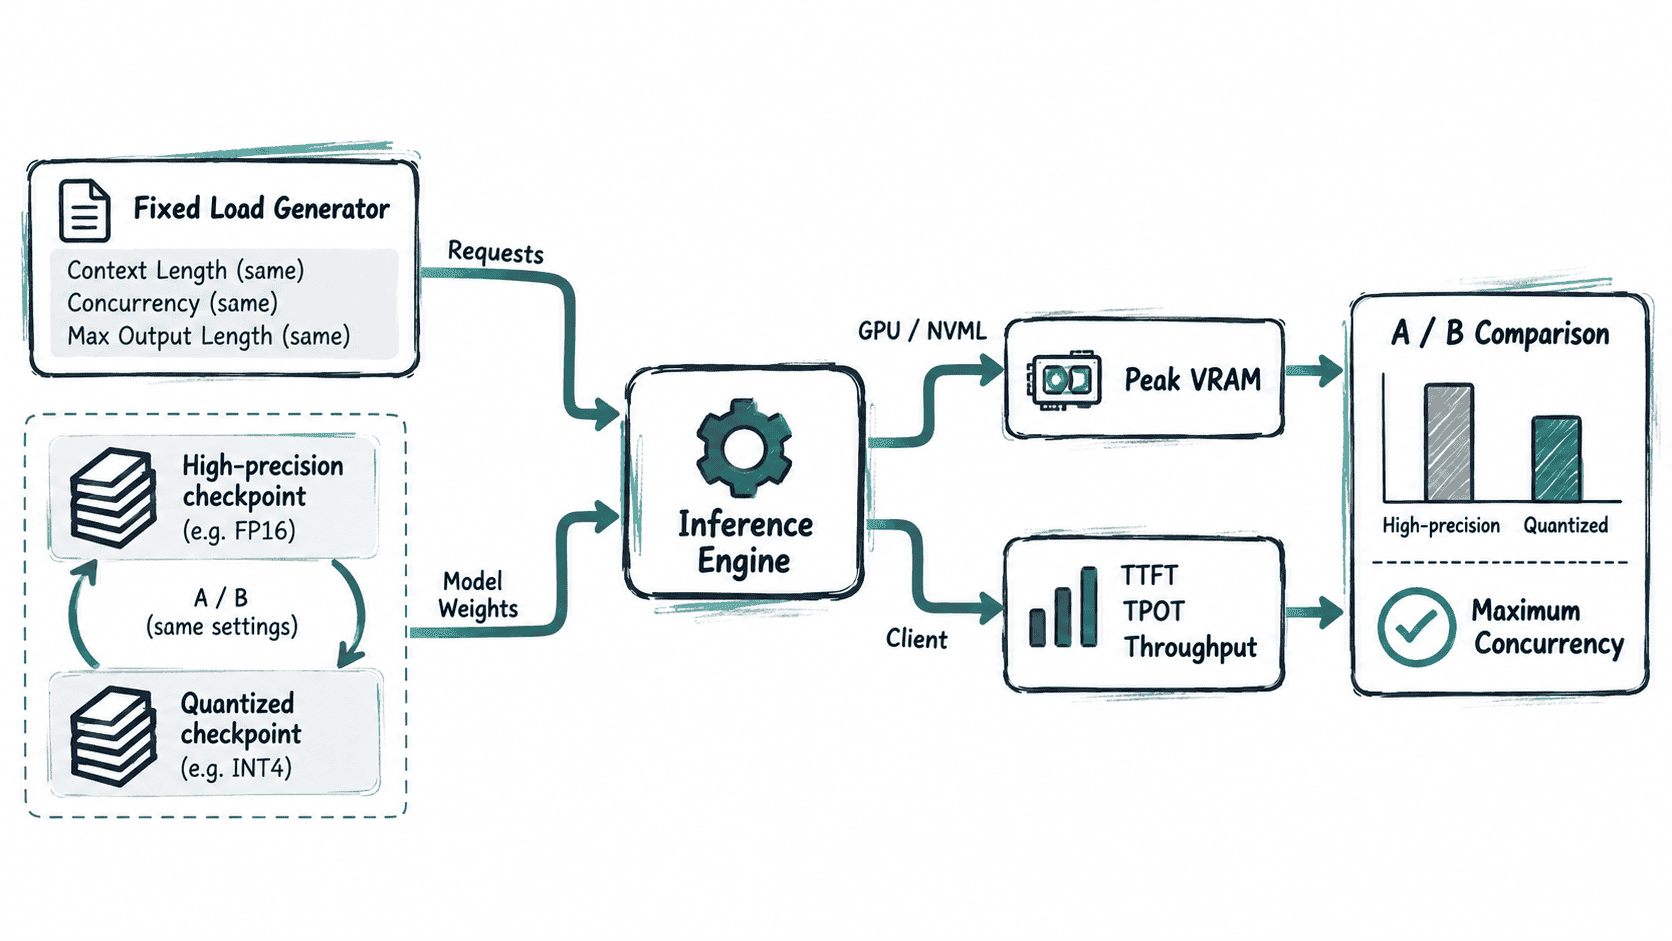
用同一脚本采集四个指标
下面脚本假设服务已启动,并且本机安装了 aiohttp、nvidia-ml-py 与 transformers。把 <PORT>、<MODEL> 和 <TOKENIZER_PATH> 替换为实际值;prompt.txt 在两轮测试中必须完全相同。脚本通过流式响应记录首个 token 到达时间,并用 NVML 采样进程运行期间的设备显存占用。
import asyncio
import json
import time
from pathlib import Path
from statistics import mean

import aiohttp
from pynvml import nvmlDeviceGetHandleByIndex, nvmlDeviceGetMemoryInfo, nvmlInit
from transformers import AutoTokenizer

BASE_URL = "http://127.0.0.1:<PORT>"
MODEL = "<MODEL>"
TOKENIZER_PATH = "<TOKENIZER_PATH>"
CONCURRENCY = 8
MAX_TOKENS = 128
PROMPT = Path("prompt.txt").read_text(encoding="utf-8")
TOKENIZER = AutoTokenizer.from_pretrained(TOKENIZER_PATH)

async def run_one(session):
    payload = {
        "model": MODEL,
        "prompt": PROMPT,
        "max_tokens": MAX_TOKENS,
        "temperature": 0,
        "stream": True,
    }
    started = time.perf_counter()
    first_token_at = None
    pieces = []

    async with session.post(f"{BASE_URL}/v1/completions", json=payload) as resp:
        resp.raise_for_status()
        async for raw_line in resp.content:
            line = raw_line.decode("utf-8").strip()
            if not line.startswith("data: "):
                continue
            data = line[6:]
            if data == "[DONE]":
                break
            chunk = json.loads(data)
            text = chunk["choices"][0].get("text", "")
            if text and first_token_at is None:
                first_token_at = time.perf_counter()
            pieces.append(text)

    finished = time.perf_counter()
    output = "".join(pieces)
    output_tokens = len(TOKENIZER.encode(output, add_special_tokens=False))
    ttft_ms = (first_token_at - started) * 1000
    tpot_ms = (finished - first_token_at) * 1000 / max(output_tokens - 1, 1)
    return ttft_ms, tpot_ms, output_tokens

async def sample_peak_vram(done):
    nvmlInit()
    handle = nvmlDeviceGetHandleByIndex(0)
    peak = 0
    while not done.is_set():
        peak = max(peak, nvmlDeviceGetMemoryInfo(handle).used)
        await asyncio.sleep(0.05)
    return peak / 1024**2

async def main():
    done = asyncio.Event()
    monitor = asyncio.create_task(sample_peak_vram(done))
    timeout = aiohttp.ClientTimeout(total=600)

    async with aiohttp.ClientSession(timeout=timeout) as session:
        wall_start = time.perf_counter()
        results = await asyncio.gather(
            *(run_one(session) for _ in range(CONCURRENCY))
        )
        wall_seconds = time.perf_counter() - wall_start

    done.set()
    peak_mib = await monitor
    ttfts, tpots, token_counts = zip(*results)
    throughput = sum(token_counts) / wall_seconds

    print(f"requests={CONCURRENCY}")
    print(f"peak_vram_mib={peak_mib:.0f}")
    print(f"mean_ttft_ms={mean(ttfts):.1f}")
    print(f"mean_tpot_ms={mean(tpots):.1f}")
    print(f"output_tokens_per_s={throughput:.1f}")

asyncio.run(main())
预期输出:
requests=8
peak_vram_mib=<PEAK_MIB>
mean_ttft_ms=<TTFT_MS>
mean_tpot_ms=<TPOT_MS>
output_tokens_per_s=<TOKENS_PER_SECOND>
其中 <PEAK_MIB>、<TTFT_MS>、<TPOT_MS> 与 <TOKENS_PER_SECOND> 都是运行时测量值,硬件、模型和负载不同会得到不同数字。比较时应分别预热高精度与量化模型后再采样,避免把首次 kernel 编译、权重分页或缓存建立算进一组而漏掉另一组。
从显存数字推到服务容量
峰值显存下降只是第一层结果。若量化模型从权重中释放了显存,应继续在相同上下文与输出长度下逐步提高并发,直到达到延迟 SLO 或显存上限,再比较两组的最大稳定并发。这样才能确认节省出来的空间是否真正被 KV Cache 和批处理利用。
如果显存明显下降而 TTFT、TPOT 或吞吐变差,通常要检查量化 kernel 是否被正确启用;若长上下文下显存差距迅速缩小,则说明 KV Cache 正在吞掉权重压缩带来的空间。量化只压权重时,不能期待 KV Cache 也按同样比例缩小。
避免四种常见误判
不要用模型文件大小代替 GPU 峰值显存;文件小并不代表运行时工作区也小。不要在一组启用更大的最大上下文或更激进的批处理配置,否则对照失效。不要只看平均延迟,服务验收还应关注稳定并发下的尾延迟。也不要只做性能测试,关键业务任务仍需与高精度模型做质量回归。
最终可上线的量化方案应同时满足三个条件:峰值显存确实降低,关键任务质量没有不可接受的回退,并且在同一服务约束下获得更高稳定并发、更低延迟或更高吞吐中的至少一项实际收益。