
大模型原理与训练 / 系统课时
配置限流鉴权与请求配额
配置限流鉴权与请求配额
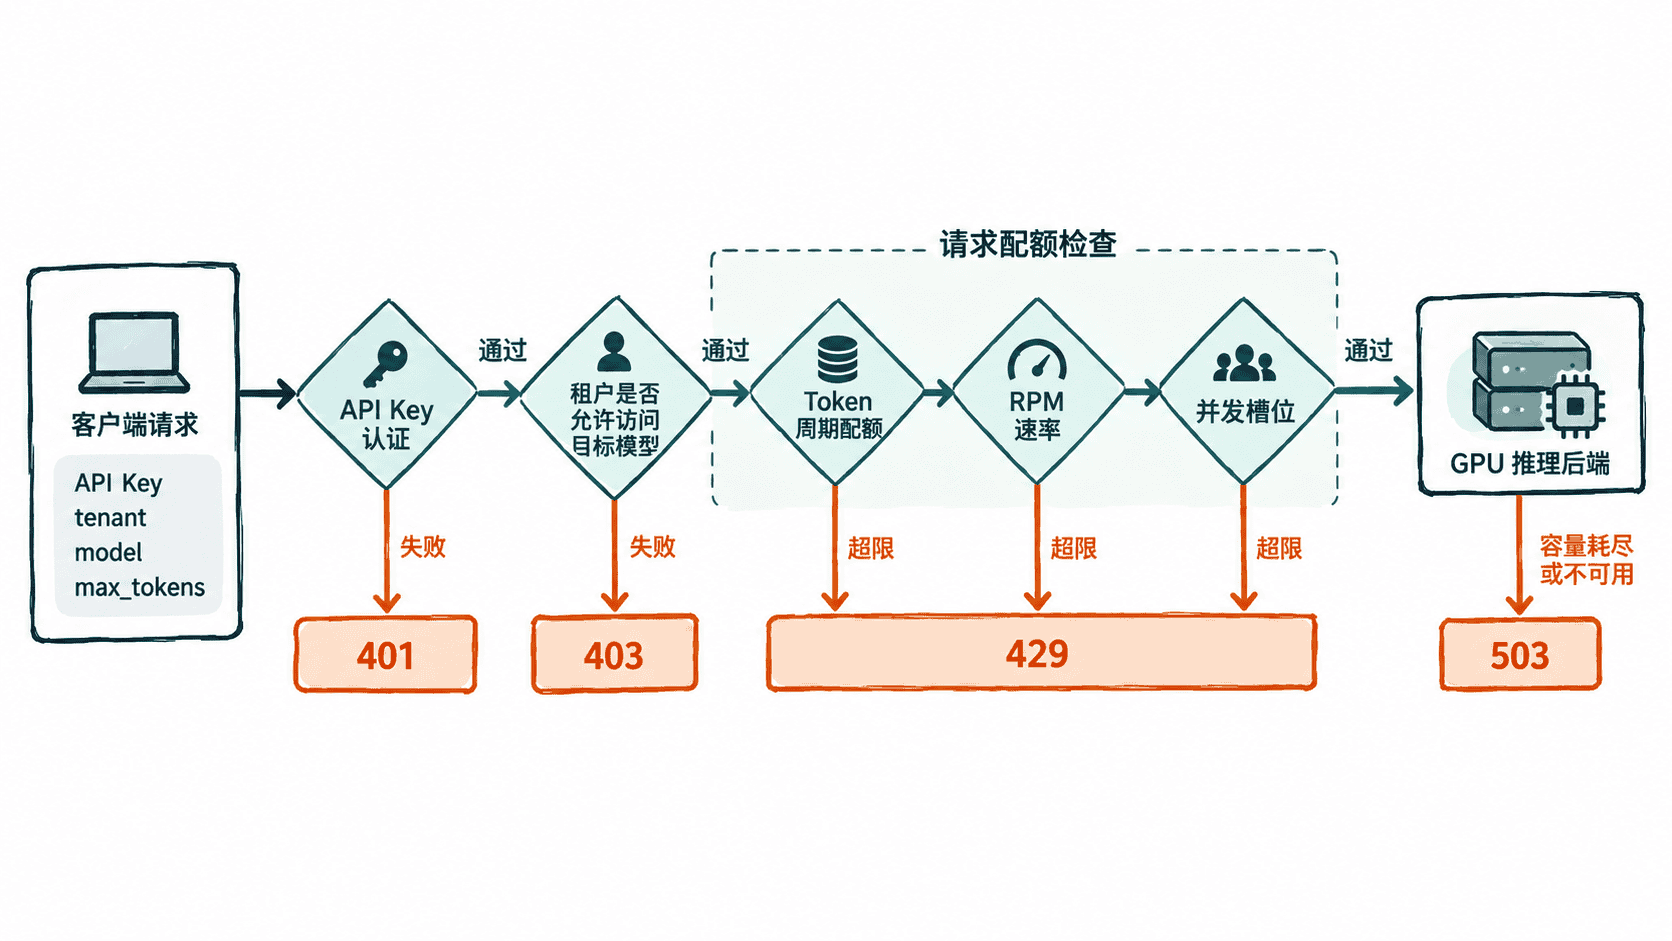
共享 GPU 推理服务最怕“一个租户把所有并发和 Token 吃完”。本节给出一套服务层配额模型:先认证,再按 API Key、租户和模型执行速率、并发与 Token 预算控制,并用不同状态码区分权限、配额和后端容量问题。
学习目标
- 设计 API Key、租户和模型三级限流与配额维度
- 正确区分
401、403、429与503,让客户端采取正确动作 - 用可运行的服务层示例验证速率、并发和 Token 预算控制
先把限制拆成三个维度
速率限制回答“单位时间能发多少次”,并发限制回答“同一时刻允许占多少个生成槽位”,Token 配额回答“一个周期内允许消耗多少生成预算”。三者不能互相替代:只有 RPM 而没有并发上限,长请求仍可能占满 GPU;只有并发上限而没有 Token 配额,大上下文或高 max_tokens 请求仍会挤占共享容量。
推荐判定顺序是:校验 API Key,解析租户与目标模型,再检查 Token 周期预算、请求速率和当前并发,最后才把请求送入推理后端。生产实现可把策略索引设计为 API Key 映射身份、tenant + model 映射额度,避免同一租户借不同 Key 绕过总配额。
用服务层实现最小可验证策略
下面示例使用 FastAPI,在单进程内维护每个 API Key 的分钟请求数、并发数与分钟 Token 预算。运行前需要 Python 3.10+,并已安装 fastapi 与 uvicorn。生产环境多副本部署时,应把计数器放到 Redis 等共享存储,或交给独立网关与配额服务。
将下面内容保存为 app.py:
import asyncio
import time
from collections import defaultdict

import uvicorn
from fastapi import FastAPI, Header, HTTPException
from pydantic import BaseModel

app = FastAPI()
POLICIES = {
    "key-a": {
        "tenant": "team-a",
        "model": "demo-model",
        "rpm": 3,
        "concurrency": 1,
        "tokens_per_min": 20,
    }
}
WINDOW = 60
requests = defaultdict(list)
inflight = defaultdict(int)
token_usage = defaultdict(list)
lock = asyncio.Lock()

class GenerateRequest(BaseModel):
    model: str
    max_tokens: int = 8

def trim(events, now):
    return [item for item in events if now - item[0] < WINDOW]

@app.post("/generate")
async def generate(body: GenerateRequest, x_api_key: str | None = Header(default=None)):
    if x_api_key not in POLICIES:
        raise HTTPException(status_code=401, detail="invalid_api_key")

    policy = POLICIES[x_api_key]
    if body.model != policy["model"]:
        raise HTTPException(status_code=403, detail="model_not_allowed")

    now = time.monotonic()
    async with lock:
        requests[x_api_key] = trim(requests[x_api_key], now)
        token_usage[x_api_key] = trim(token_usage[x_api_key], now)
        used_tokens = sum(value for _, value in token_usage[x_api_key])

        if used_tokens + body.max_tokens > policy["tokens_per_min"]:
            raise HTTPException(status_code=429, detail="token_quota_exceeded")
        if len(requests[x_api_key]) >= policy["rpm"]:
            raise HTTPException(status_code=429, detail="rate_limit_exceeded")
        if inflight[x_api_key] >= policy["concurrency"]:
            raise HTTPException(status_code=429, detail="concurrency_limit_exceeded")

        requests[x_api_key].append((now, 1))
        token_usage[x_api_key].append((now, body.max_tokens))
        inflight[x_api_key] += 1

    try:
        # 用短暂等待模拟模型生成;真实服务在这里调用推理后端。
        await asyncio.sleep(0.2)
        return {
            "tenant": policy["tenant"],
            "model": body.model,
            "reserved_tokens": body.max_tokens,
        }
    finally:
        async with lock:
            inflight[x_api_key] -= 1

if __name__ == "__main__":
    uvicorn.run(app, host="127.0.0.1", port=8000)
预期结果:运行 python app.py 后服务监听本机 8000 端口,控制台会出现类似输出:
INFO: Uvicorn running on http://127.0.0.1:8000日志中的进程 ID、时间等动态值可能不同。
验证状态码和配额语义
先验证认证失败:
curl -s -o /dev/null -w '%{http_code}\n' -X POST http://127.0.0.1:8000/generate -H 'Content-Type: application/json' -d '{"model":"demo-model","max_tokens":8}'预期输出:
401再带上合法 Key 请求:
curl -s -X POST http://127.0.0.1:8000/generate -H 'Content-Type: application/json' -H 'X-API-Key: key-a' -d '{"model":"demo-model","max_tokens":8}'预期输出:
{"tenant":"team-a","model":"demo-model","reserved_tokens":8}前两次合法请求各预留 8 个 Token 后,第三次相同请求会使预算从 16 尝试增加到 24,超过每分钟 20 的上限,因此返回 429 token_quota_exceeded。真实推理服务通常在请求前按上限预留,结束后再按实际 usage 结算差额。
不要把后端过载伪装成租户超限
429 Too Many Requests 表示调用方在某个配额维度超限;503 Service Unavailable 表示服务当前没有足够容量或依赖不可用。GPU worker 全忙、模型副本不足或调度器拒绝新任务时,应返回 503,并可附带 Retry-After,不要消耗新的租户额度。
认证失败使用 401;已经认证但无权访问目标模型使用 403。稳定的错误码应放在响应体中,让客户端能区分“换凭证”“降低速率”“等待配额窗口”和“等待后端恢复”。
上线时补齐分布式一致性
单实例内存计数只适合演示。多副本网关应使用原子计数、带过期时间的滑动窗口或令牌桶,并保证同一租户的所有请求看到同一份配额状态。并发槽位也要跨副本统一统计,否则每个副本都允许 N 个并发时,总并发会被副本数放大。
最终策略应保证:认证失败不进入配额系统,配额失败不进入 GPU,后端过载不消耗新的租户额度;这样才能把安全边界、租户公平性和共享 GPU 的容量保护分开治理。