
大模型原理与训练 / 系统课时
在 Kubernetes 调度 GPU
在 Kubernetes 调度 GPU
GPU Pod 能否稳定落到正确节点,不只取决于 nvidia.com/gpu。本节把设备资源、节点标签、污点容忍与拓扑约束组合成一套可验证的调度配置,并说明多卡任务如何避免跨错故障域或争抢不可共享的设备。
学习目标
- 为 Pod 声明 GPU 资源,并把工作负载限制到符合型号或用途的节点。
- 正确组合节点选择、污点容忍和拓扑分布约束。
- 用调度事件与
nvidia-smi验证 Pod 实际获得的 GPU,并识别多卡布局风险。
先确认 GPU 已成为可调度资源
Kubernetes 本身不会直接发现 NVIDIA GPU。节点上需要可工作的驱动与设备插件,插件会把设备数量注册成扩展资源,例如 nvidia.com/gpu。调度器只依据节点上可分配的资源数量做放置,不会替你判断显存是否够用,也不会把一张独占 GPU 自动切给多个 Pod。
先查看 GPU 节点的可分配资源。下面命令中的 <NODE> 替换为实际节点名。
kubectl get node <NODE> -o jsonpath='{.status.allocatable.nvidia\.com/gpu}{"\n"}'预期输出
4如果输出为空或为 0,先检查驱动、容器运行时与 GPU device plugin;此时继续写 Pod 资源声明也不会得到 GPU。
组合资源、节点与污点
生产集群通常会给 GPU 节点加稳定标签,并用污点阻止普通 Pod 占用。以下示例假设节点已经带有 accelerator=nvidia-a100 标签和 dedicated=gpu:NoSchedule 污点。Pod 请求 1 张 GPU,只允许调度到目标型号节点,并显式容忍该污点。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-smoke
  labels:
    app: gpu-smoke
spec:
  restartPolicy: Never
  nodeSelector:
    accelerator: nvidia-a100
  tolerations:
    - key: dedicated
      operator: Equal
      value: gpu
      effect: NoSchedule
  containers:
    - name: cuda
      image: nvidia/cuda:12.4.1-base-ubuntu22.04
      command: ["bash", "-lc", "nvidia-smi -L && sleep 3600"]
      resources:
        limits:
          nvidia.com/gpu: 1
配置生效后,调度器会同时检查 GPU 可分配数量、nodeSelector 和污点容忍;任一条件不满足,Pod 都会保持 Pending。GPU 这类扩展资源通常在 limits 中声明,不能依赖 CPU、内存那样的超卖方式。
将上面的内容保存为 gpu-smoke.yaml 后执行:
kubectl apply -f gpu-smoke.yaml
kubectl wait --for=condition=Ready pod/gpu-smoke --timeout=120s
kubectl exec gpu-smoke -- nvidia-smi -L
预期输出
pod/gpu-smoke created
pod/gpu-smoke condition met
GPU 0: <GPU-NAME> (UUID: GPU-<ID>)
<GPU-NAME> 与 <ID> 会随设备而变化。若 kubectl wait 超时,用 kubectl describe pod gpu-smoke 查看 Events,优先检查资源不足、标签不匹配和未容忍污点。
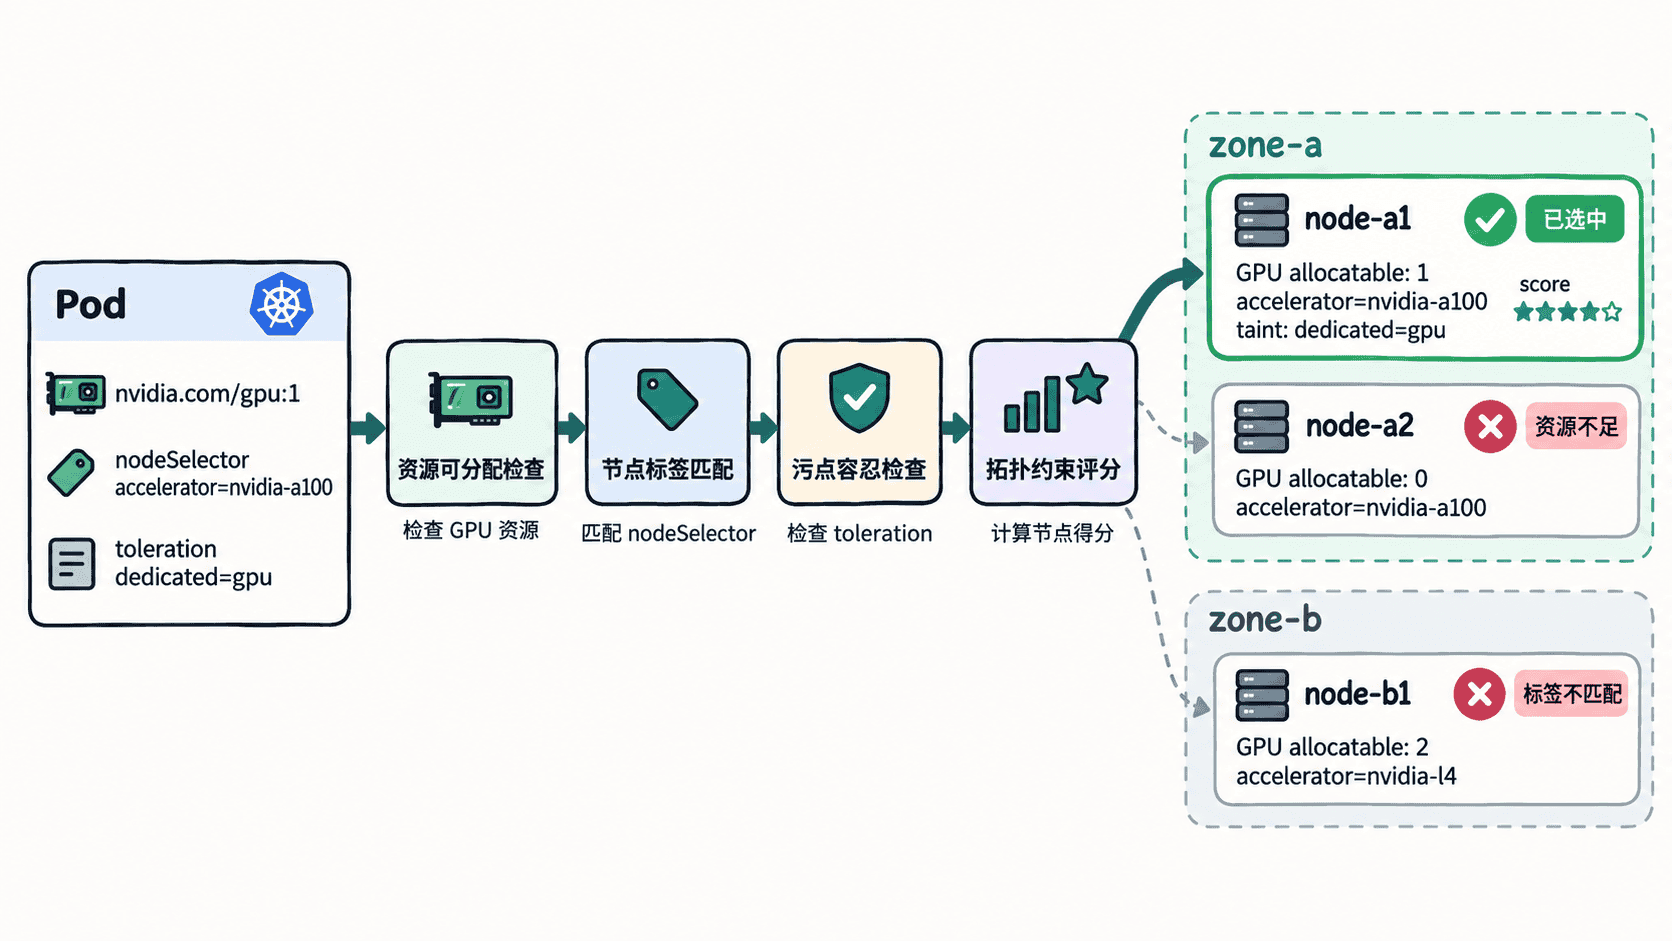
为多卡任务约束布局
单个 Pod 请求 nvidia.com/gpu: 2 时,两张设备必须来自同一节点,因为 Pod 不会跨节点分配资源。真正的多节点推理或训练一般由多个 Pod 组成,这时需要同时考虑节点内 GPU 数量、机型一致性和故障域。
topologySpreadConstraints 适合控制多个副本在 zone 或 hostname 上的分布。下面是 Deployment 中的片段示例,依赖上面的 app: llm-worker 标签,并假设集群节点具有标准的 topology.kubernetes.io/zone 标签。
topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: topology.kubernetes.io/zone
    whenUnsatisfiable: DoNotSchedule
    labelSelector:
      matchLabels:
        app: llm-worker
这段配置要求同一工作负载尽量均匀跨 zone,并在无法满足时拒绝继续调度。它适合提高副本级容灾,但不等于“让一次张量并行跨 zone”。对强通信的多卡推理,应优先把同一并行组放在高速互联可达的节点范围内,再把不同副本分散到不同故障域。
共享策略与故障域边界
默认 device plugin 语义更接近“整卡分配”:Pod 获得设备后,其他 Pod 不会自动共享同一张物理卡。若集群启用了 MIG、time-slicing 或其他共享方案,资源名称、隔离强度和故障影响范围都可能不同,应用必须按集群实际暴露的资源类型申请,不能只看 nvidia.com/gpu 这个名字推断隔离级别。
调度设计可以按两层处理:先保证单个推理副本内部满足 GPU 数量、型号和高速互联要求,再用拓扑约束处理多个副本之间的容灾分布。这样能避免为了“跨故障域”把一个强通信并行组拆散,也能避免所有副本集中在同一节点或同一 zone。