
大模型原理与训练 / 系统课时
调节调度参数平衡时延吞吐
调节调度参数平衡时延吞吐
推理服务的调度参数彼此耦合:放大批次通常能提高吞吐,却可能拉长排队和首 Token 等待。本篇把最大批次 Token、最大序列数、显存利用率和上下文上限放进同一套固定压测中,用 TTFT、TPOT 与吞吐共同确定配置区间。
学习目标
- 解释四个核心调度参数分别限制哪类资源以及常见副作用。
- 使用固定工作负载比较配置,避免靠单次峰值吞吐做决定。
- 根据 TTFT、TPOT、吞吐和显存余量反推下一轮调参方向。
四个旋钮分别控制什么
调度器需要在等待队列、Prefill、Decode 和 KV Cache 之间分配有限的 GPU 资源。四个常见参数并不是彼此独立的开关,而是在共同限制一轮调度能接纳多少请求、多少 Token 以及最多保留多长上下文。
| 参数 | 调高后的常见收益 | 主要风险 |
|---|---|---|
| 最大批次 Token | 提高 Prefill 合批规模,通常有利于总体吞吐 | 大批 Prefill 可能延长其他请求的 TTFT 或 Decode 等待 |
| 最大序列数 | 允许更多请求同时处于活跃状态 | KV Cache 占用增加,并发过高时 TPOT 可能恶化 |
| 显存利用率目标 | 给 KV Cache 和执行空间留下更多可用显存 | 余量过小会增加 OOM 或运行期抖动风险 |
| 上下文上限 | 接纳更长的请求 | 单请求最坏 KV Cache 预算增大,可并发序列数下降 |
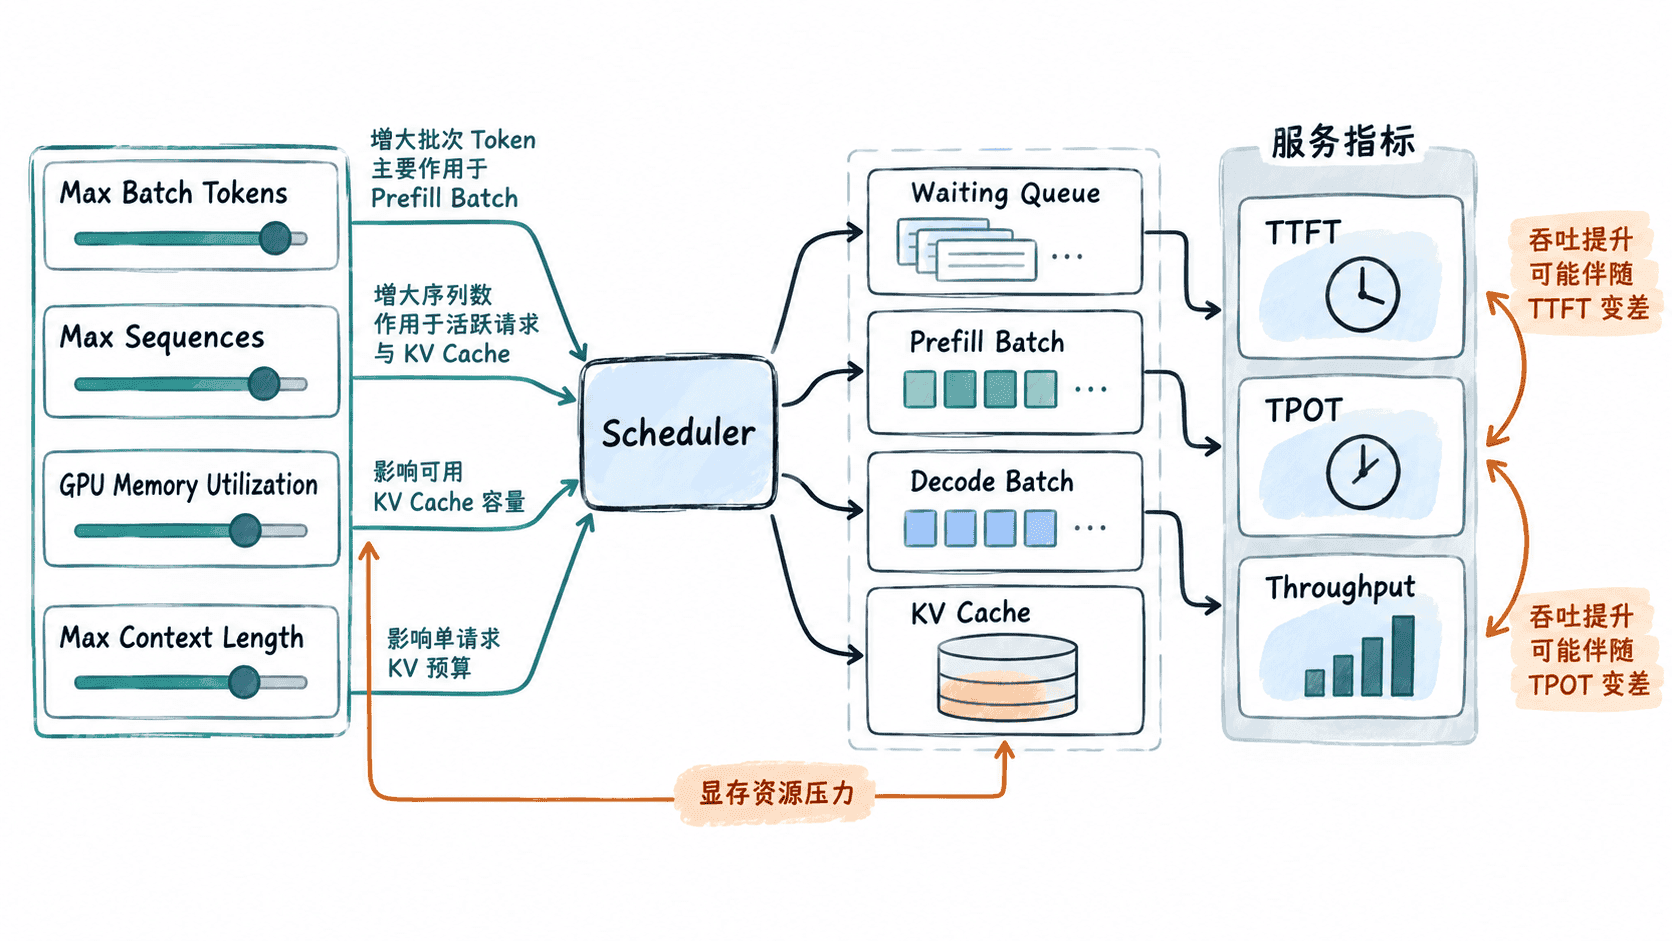
因此不存在脱离负载的最佳数字。相同配置在短提示词、高并发聊天请求上可能表现很好,换成长上下文、低并发生成任务后,瓶颈可能完全转移。
用固定压测做联合调参
先固定模型、量化方式、硬件、采样参数、提示词长度分布、输出长度分布和并发度,再修改调度参数。每组配置都应经历相同预热和压测窗口,否则缓存预热、请求随机性或后台任务足以掩盖真实差异。
一个稳定的调参顺序是:先根据真实业务长度分布确定上下文上限,再设置保守的显存利用率以留下运行余量,然后调整最大序列数,最后逐步提高最大批次 Token。每一步都只扩大到收益开始变平或关键 SLO 明显恶化的位置。
下面的完整 Python 示例将四组固定压测结果与服务目标比较。示例要求 TTFT 不超过 120 ms、TPOT 不超过 26 ms,同时吞吐至少达到 550 Token/s,然后从满足约束的配置中选择吞吐最高的一组。实际使用时替换为自己的测量数据即可。
configs = [
    {"name": "A", "batch_tokens": 4096, "max_seqs": 64, "gpu_mem": 0.85, "max_context": 8192,
     "ttft_ms": 72, "tpot_ms": 27, "throughput": 480},
    {"name": "B", "batch_tokens": 8192, "max_seqs": 96, "gpu_mem": 0.90, "max_context": 8192,
     "ttft_ms": 91, "tpot_ms": 24, "throughput": 620},
    {"name": "C", "batch_tokens": 16384, "max_seqs": 128, "gpu_mem": 0.92, "max_context": 16384,
     "ttft_ms": 165, "tpot_ms": 29, "throughput": 700},
    {"name": "D", "batch_tokens": 8192, "max_seqs": 64, "gpu_mem": 0.88, "max_context": 16384,
     "ttft_ms": 110, "tpot_ms": 26, "throughput": 560},
]

TTFT_LIMIT = 120
TPOT_LIMIT = 26
MIN_THROUGHPUT = 550

# 先按服务目标过滤,而不是直接选择吞吐最高的配置。
eligible = [
    c for c in configs
    if c["ttft_ms"] <= TTFT_LIMIT
    and c["tpot_ms"] <= TPOT_LIMIT
    and c["throughput"] >= MIN_THROUGHPUT
]

print("eligible=" + ",".join(c["name"] for c in eligible))

if eligible:
    best = max(eligible, key=lambda c: c["throughput"])
    print(
        f"best={best['name']} "
        f"ttft={best['ttft_ms']}ms "
        f"tpot={best['tpot_ms']}ms "
        f"throughput={best['throughput']} tok/s"
    )
else:
    print("best=none")
预期输出
eligible=B,D
best=B ttft=91ms tpot=24ms throughput=620 tok/s
配置 C 的吞吐最高,但 TTFT 和 TPOT 都越过了目标,因此不能因为峰值吞吐漂亮就采用。配置 B 的吞吐略低,却同时满足三个服务指标,这才是当前 SLO 下更合理的候选。
从指标反推下一次调整
如果吞吐还有提升空间而 TTFT、TPOT 与显存都很宽松,可以先小幅增加最大批次 Token 或最大序列数,再重复同一压测。不要一次同时大幅修改多个参数,否则即使结果变好,也难以解释究竟是哪一个变化起作用。
如果 TTFT 明显上升而 TPOT 基本稳定,常见原因是请求排队或大 Prefill 批次占用过久,此时应优先检查批次 Token 上限和 Prefill 调度。若 TTFT 正常但 TPOT 随并发增长持续恶化,则要检查活跃序列是否过多,以及 Decode 批次是否已经接近计算或内存带宽瓶颈。
显存接近满载时不要继续用提高利用率来换吞吐。上下文长度和序列并发都会扩大 KV Cache 压力,还需要给执行临时张量、通信缓冲区以及不同请求长度造成的波动留出空间。显存利用率目标应被视为容量预算,而不是越接近 100% 越好。
确定可解释配置区间
调优完成后不要只保存一个数字组合,而应保存一个可解释区间。例如记录在当前模型、GPU 和请求分布下,批次 Token 从某个范围继续增加后吞吐收益已趋平,同时 TTFT 开始快速上升;最大序列数超过某一范围后 TPOT 恶化;显存利用率超过某一水平后稳定性余量不足。
这样的配置区间比单点最优更适合生产环境,因为流量和请求长度会波动。上线前再用目标并发的低位、常态和高位分别验证一次,只要 TTFT、TPOT、吞吐和显存余量都落在预期范围内,就能把调度参数从一次压测结果变成可维护的容量策略。