
大模型原理与训练 / 系统课时
估算模型权重与显存占用
估算模型权重与显存占用
模型参数量只能告诉你权重有多大,不能直接代表推理时真实显存。要判断模型能否单卡加载,需要把权重、KV Cache、运行时缓冲区和框架开销分开估算,再为量化、并发与最大上下文长度预留安全余量。
学习目标
- 根据参数量和数据类型估算模型权重占用。
- 估算 KV Cache 如何随层数、上下文长度和并发数增长。
- 建立单卡装载前的显存预算,并识别必须量化或多卡的场景。
先算最稳定的权重部分
权重占用的第一近似非常直接:
其中 是参数数量, 是每个参数占用的字节数。常见近似为 FP32 每参数 4 字节,FP16/BF16 每参数 2 字节,INT8 每参数约 1 字节,INT4 每参数约 0.5 字节。
例如一个 7B 参数模型,如果权重以 FP16 保存,仅权重就约为 字节,也就是约 14 GB。这个数字只能作为下限,因为推理进程还需要保存 KV Cache、临时张量、CUDA 上下文和框架自身的数据结构。
把显存拆成四个预算桶
做容量规划时,可以先用下面的结构化近似:
包括激活临时缓冲区、算子 workspace、CUDA Graph 或编译缓存等; 则用于避免碎片化和流量波动把显存推到 OOM 边缘。二者很难仅靠参数量精确计算,工程上通常通过实际启动后的基线测量校正。
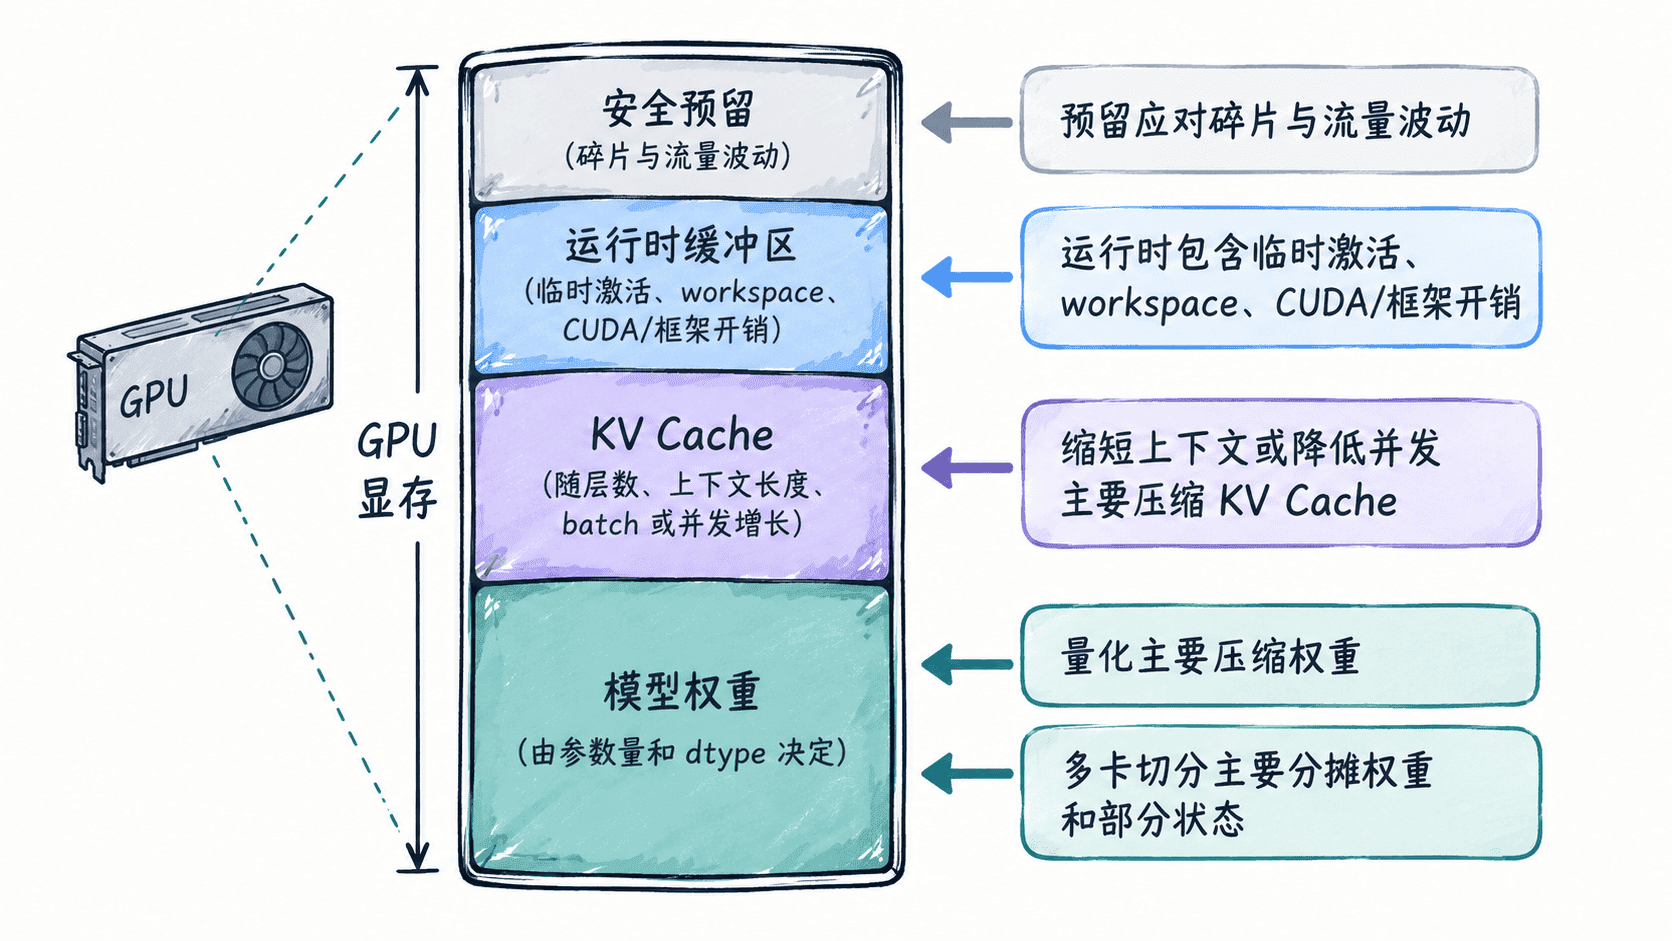
KV Cache 决定上下文和并发上限
KV Cache 与权重不同,它会随着实际请求增长。对常见 Transformer,可把每个 Token 的 KV Cache 近似写成:
其中 是层数, 是 KV Head 数, 是每个 Head 的维度,前面的 2 表示同时保存 Key 和 Value, 是每个缓存元素的字节数。总 KV Cache 再乘上下文 Token 数和同时驻留的序列数。
这也解释了为什么 GQA 或 MQA 能显著减小 KV Cache:它们降低的是 ,而不是模型隐藏维度本身。对于长上下文服务,KV Cache 很可能比运行时临时缓冲更早成为并发瓶颈。
用一个计算器先做装载判断
下面的最小脚本只估算“权重 + KV Cache”,适合在选卡前快速做数量级判断。它没有包含框架和算子额外开销,因此结果必须再加安全余量。
def gib(x: float) -> float:
    return x / (1024 ** 3)

params = 7_000_000_000
weight_bytes = 2          # FP16/BF16
layers = 32
kv_heads = 8
head_dim = 128
kv_bytes = 2              # FP16 KV Cache
context_tokens = 4096
sequences = 4

weights = params * weight_bytes
kv_per_token = 2 * layers * kv_heads * head_dim * kv_bytes
kv_total = kv_per_token * context_tokens * sequences

print(f"weights={gib(weights):.2f} GiB")
print(f"kv_cache={gib(kv_total):.2f} GiB")
print(f"subtotal={gib(weights + kv_total):.2f} GiB")
预期输出
weights=13.04 GiB
kv_cache=2.00 GiB
subtotal=15.04 GiB
实际模型的层数、KV Head 数和缓存精度必须以模型配置与推理引擎为准;运行时显存还会高于这个 subtotal。
从预算结果决定下一步
如果“权重 + 目标 KV Cache”已经接近显卡物理显存,就不应期待通过零碎参数调整解决问题。优先级通常是先降低权重精度,再根据业务需求降低最大上下文或并发,仍然放不下时再考虑张量并行、流水并行或其他多卡切分。
单卡能“勉强加载”也不等于可以稳定服务。生产基线应在模型启动后记录空闲显存,再用目标上下文和并发做压力验证,观察峰值分配与碎片化。只有预算值和实测峰值都留有余量,后续性能测试才有意义。