
大模型原理与训练 / 系统课时
定位 NCCL 通信与拓扑瓶颈
定位 NCCL 通信与拓扑瓶颈
多卡推理变慢时,先不要假定“GPU 不够”。本节用 NCCL 基准、GPU 拓扑和运行日志把问题拆成链路带宽、Rank 绑卡与集合通信等待三类,并给出可复现的定位顺序,最终判断该扩容、改映射还是修网络。
学习目标
- 用
nccl-tests建立可重复的集合通信基线,并正确理解algbw与busbw - 从 NVLink、PCIe、NUMA 与 NIC 拓扑判断通信是否走了昂贵路径
- 区分链路带宽不足、Rank 绑卡错误和集合通信等待,并验证修复是否有效
先建立通信基线
端到端吞吐下降可能来自计算、调度或通信。第一步应把模型服务移出变量,只测集合通信本身。同一台机器上先记录拓扑,再用 AllReduce 覆盖中大消息;如果单机基线已经异常,就没有必要先追查跨机网络。
下面假设 <PATH>/nccl-tests 已经完成编译。<PATH> 需要替换成实际目录,GPU 数量由命令自动读取。
cd <PATH>/nccl-tests
NGPUS="$(nvidia-smi -L | wc -l)"
echo "GPUS=${NGPUS}"
nvidia-smi topo -m
./build/all_reduce_perf -b 8M -e 1G -f 2 -g "${NGPUS}"
预期输出会先出现 GPU 拓扑矩阵,随后是不同消息大小的 AllReduce 结果。拓扑标签和带宽数值随机器而变,重点确认测试完成且结果中存在 algbw、busbw 等列。
GPUS=<GPU_COUNT>
        GPU0    GPU1    GPU2    ...
GPU0    X       <LINK>  <LINK>  ...
GPU1    <LINK>  X       <LINK>  ...
...
#       size         count      type  redop  root     time   algbw   busbw
      <BYTES>      <COUNT>     float    sum    -1   <TIME>  <ALGBW> <BUSBW>
algbw 表示按操作数据量和耗时计算出的算法带宽;busbw 对不同集合通信做了归一化,更适合观察底层互连是否被充分利用。排障时优先与同型号、同拓扑、同消息大小、同 Rank 数的健康节点基线比较,不要把单个 busbw 数字机械地等同于某条链路的标称峰值。
读懂 GPU 到 GPU、GPU 到 NIC 的实际路径
nvidia-smi topo -m 不只是“看有没有 NVLink”。同一节点内,NV# 表示 GPU 间存在 NVLink 路径,而 PIX、PXB、PHB、NODE、SYS 代表逐步更远的 PCIe、NUMA 或跨 CPU 路径。若本应频繁交换数据的 Rank 被放在需要跨 NUMA 或跨 CPU 的 GPU 对上,带宽和延迟都会受影响。
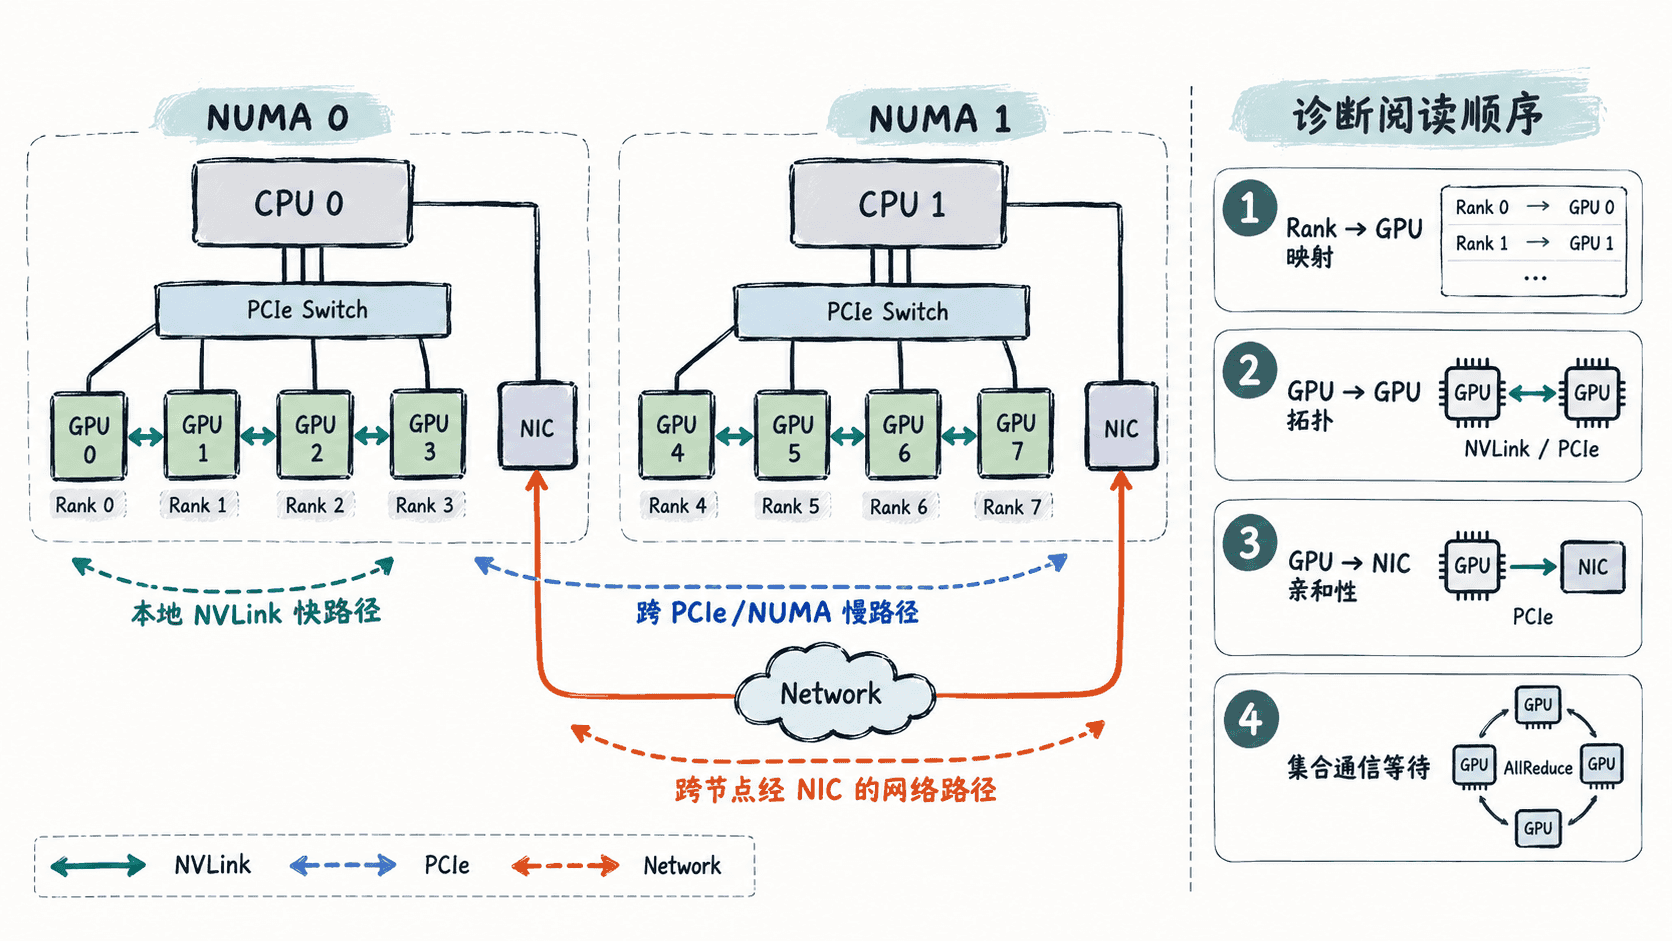
多机问题还要把 NIC 放进拓扑。单机 busbw 正常而跨机明显下降时,优先检查 GPU 是否靠近实际使用的 NIC、网卡链路是否达到预期速率、错误与重传是否增加,以及不同节点是否选择了不一致的网络接口。此时“再加 GPU”通常只会增加参与通信的 Rank 数,不能修复坏链路。
把慢分成三类
| 现象 | 更像什么问题 | 关键证据 |
|---|---|---|
大消息 busbw 持续低于健康节点,单机或跨机都能稳定复现 |
链路带宽不足或拓扑路径过远 | 拓扑落在 PHB、SYS 等远路径,或跨机 NIC 吞吐封顶、错误计数异常 |
| 某些 Rank 明显更慢,进程看到的 GPU 与预期不一致 | Rank 绑卡或可见设备映射错误 | 多进程重复占同一 GPU,或 Rank 到 GPU、GPU 到 NIC 的亲和性不符合设计 |
nccl-tests 基线正常,但真实推理中 Collective 前出现长时间空洞 |
集合通信等待,未必是链路本身慢 | 不同 Rank 到达 Collective 的时间差很大,慢 Rank 在通信开始前已经落后 |
第三类最容易误判。集合通信必须等待参与者到齐;某个 Rank 因计算负载、请求批次、内存压力或上游调度更慢,其他 Rank 就会在 Collective 处表现为“等待 NCCL”。这时换网卡或提高 NCCL 并行度通常治标不治本。
用日志确认 Rank、拓扑和网络选择
需要进一步确认时,可在原有启动命令前临时设置 NCCL_DEBUG=INFO,并用 NCCL_DEBUG_SUBSYS=INIT,GRAPH,NET 聚焦初始化、拓扑与网络信息。重点核对每个 Rank 绑定的设备、选中的网络接口以及 NCCL 构造出的通信图是否符合部署设计。
如果日志显示映射正确、拓扑也合理,但跨机吞吐仍低,应把问题下沉到交换机、RoCE/InfiniBand 或 TCP 层;如果 nccl-tests 健康而模型服务慢,则回到服务侧检查 Rank 到达时间、批处理不均和同步点。
修复后用同一把尺子复测
修复只看“服务好像快了”不够。保持 GPU 数、Rank 数、消息范围和进程放置一致,重新运行相同的 AllReduce 基线,再对照端到端吞吐与延迟。链路问题应反映为大消息 busbw 恢复;绑卡问题应表现为慢 Rank 消失;集合等待问题则应看到各 Rank 到达同步点的偏差缩小。
只有通信基线和服务指标同时改善,才能把收益归因到这次修复。若基线没有变化却端到端变快,真正的瓶颈很可能在调度、批处理或计算侧,而不是 NCCL。