
大模型原理与训练 / 系统课时
选择高效 Attention 内核
选择高效 Attention 内核
高效 Attention 内核的关键不是“换一个算子名”,而是让矩阵分块、Softmax 与乘法尽量在片上完成,减少中间张量写回 HBM。本篇会建立判断标准,并用强制后端的方式验证 Flash Attention 是否真的被执行。
学习目标
- 解释融合 Attention 为什么能减少 HBM 读写和中间张量
- 根据 GPU、数据类型、张量形状与上下文长度判断内核适配性
- 用可执行脚本阻止静默回退并验证 Flash Attention 是否可用
为什么融合内核能减少 HBM 往返
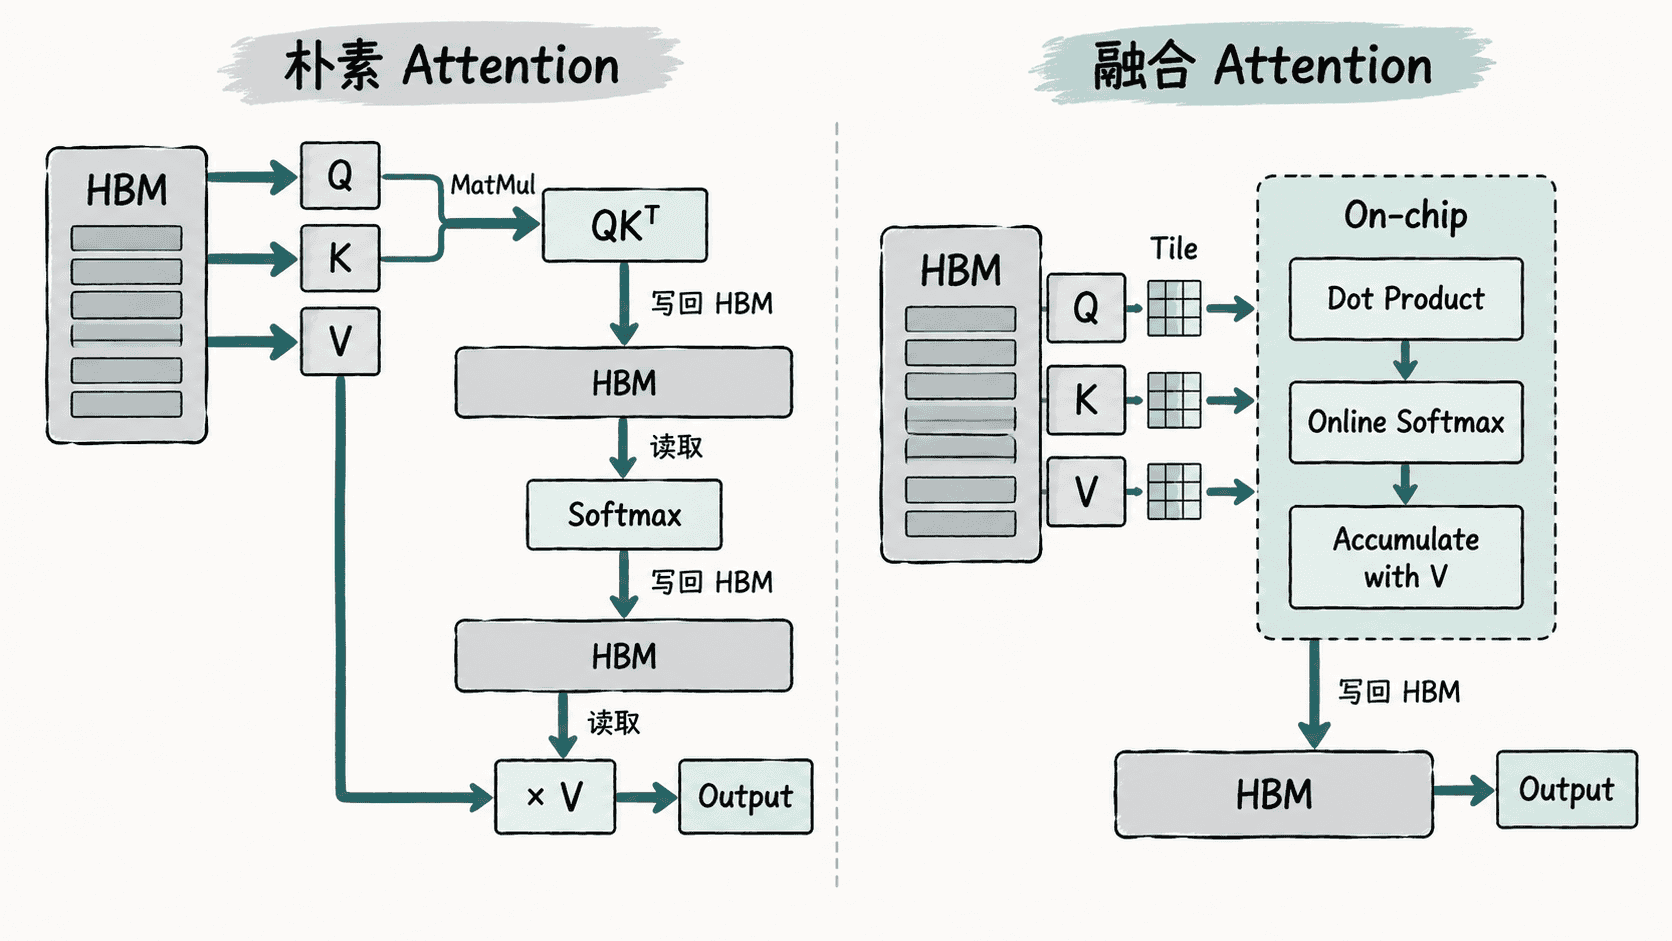
朴素 Attention 往往把 、Softmax 结果等大张量阶段性写回显存,再由下一阶段读出。上下文越长,中间矩阵越大,瓶颈越容易从算力转向 HBM 带宽与显存占用。
FlashAttention 一类 IO-aware 融合内核把查询、键和值按块搬入片上存储,在块内完成点积、在线 Softmax 与后续乘法,只把必要结果写回 HBM。核心收益不是改变 Attention 的数学定义,而是减少昂贵的数据搬运和中间结果物化。
选择内核先看调用是否满足约束
“GPU 支持 FlashAttention”不等于“任意一次 Attention 都会命中 Flash 内核”。内核选择通常同时受硬件架构、PyTorch 与 CUDA 版本、数据类型、head dimension、mask 形式、dropout、序列长度以及张量布局影响。
实际调优时应把判断单位缩小到一次具体调用:固定模型、batch、上下文长度和 dtype,再验证该 shape 是否可执行。一个 shape 成功,不代表模型中所有层、所有请求长度都会走同一后端。
强制后端验证是否真的可用
下面示例需要安装支持 CUDA 的 PyTorch,并在 NVIDIA GPU 上运行。它只允许 FLASH_ATTENTION 后端;如果当前硬件、dtype 或张量形状不满足条件,调用会直接报错,而不是悄悄回退到其他 SDPA 实现。
import torch
import torch.nn.functional as F
from torch.nn.attention import SDPBackend, sdpa_kernel

if not torch.cuda.is_available():
    raise SystemExit("需要 CUDA GPU 才能验证 Flash Attention")

device = "cuda"
dtype = torch.float16

q = torch.randn(1, 8, 1024, 64, device=device, dtype=dtype)
k = torch.randn(1, 8, 1024, 64, device=device, dtype=dtype)
v = torch.randn(1, 8, 1024, 64, device=device, dtype=dtype)

with sdpa_kernel(SDPBackend.FLASH_ATTENTION):
    out = F.scaled_dot_product_attention(
        q, k, v, dropout_p=0.0, is_causal=True
    )

torch.cuda.synchronize()
print(out.shape)
print(out.dtype)
print(out.device)
预期输出
torch.Size([1, 8, 1024, 64])
torch.float16
cuda:0
如果脚本成功,说明这组输入可以使用 Flash Attention;如果抛出“不存在可用内核”一类错误,应把它视为兼容性证据,再逐项缩小 dtype、shape、mask 或软件栈差异,而不是立即改回允许自动回退。
回退时按输入形状定位
先保留真实服务中失败的 batch、序列长度、head 数和 head dimension,再用最小脚本复现。随后一次只改一个变量:例如把 dtype 从 float32 改为 float16,或去掉自定义 mask,观察强制 Flash 后端是否恢复。
生产验证还应同时看吞吐、单 token 延迟和峰值显存。高效内核的价值来自减少 IO 与中间张量,而不是“内核名字正确”本身;只有在真实请求形状上持续命中,并且性能指标同步改善,优化才算生效。