
大模型原理与训练 / 系统课时
用分位数读懂时延抖动
用分位数读懂时延抖动
平均时延只能描述整体中心,无法告诉你最慢的那批请求发生了什么。本节把 TTFT、TPOT 和端到端时延拆开,并用 P50、P95、P99 结合并发与队列长度,定位调度等待、长提示词和长输出造成的尾延迟。
学习目标
- 区分 TTFT、TPOT 与端到端时延各自覆盖的执行阶段
- 使用 P50、P95、P99 识别平均值掩盖的尾延迟
- 结合并发、队列时间和请求长度判断抖动来源
先分清三个时延指标
TTFT 是从请求开始到收到首个输出 token 的时间。客户端测量时,它通常同时受到网络传输、排队、调度、Prefill 和首 token 返回路径影响,因此 TTFT 高并不等价于模型计算本身慢。
TPOT 描述进入 Decode 后生成输出 token 的平均耗时,更适合观察持续生成阶段是否因显存带宽、KV Cache 访问或批处理竞争而变慢。端到端时延则从请求开始一直计算到响应结束,还会显著受到输出 token 数量影响。
分位数为什么能看到平均值遗漏的问题
P50 是中位位置,代表一半请求不超过该值;P95 和 P99 逐渐逼近分布尾部。平均值会把所有样本压缩成一个数字,而高分位数能直接暴露少数异常慢请求对用户体验的影响。
例如大量请求都在 150 ms 左右完成首 token,但少量请求因等待长批次而超过 2 s。平均 TTFT 可能只升到几百毫秒,看起来尚可,P99 却会立刻把这批尾部请求暴露出来。P99 也不是最坏值,它表示约 99% 样本位于该阈值以内,因此样本量过小时不要过度解读高分位数。
把分位数与并发、队列放在一起
只看到 P99 变高还不能确定根因。需要在同一压测时间窗口记录并发数、请求队列长度或排队时间,再比较 TTFT、TPOT 和端到端时延的分位数变化。
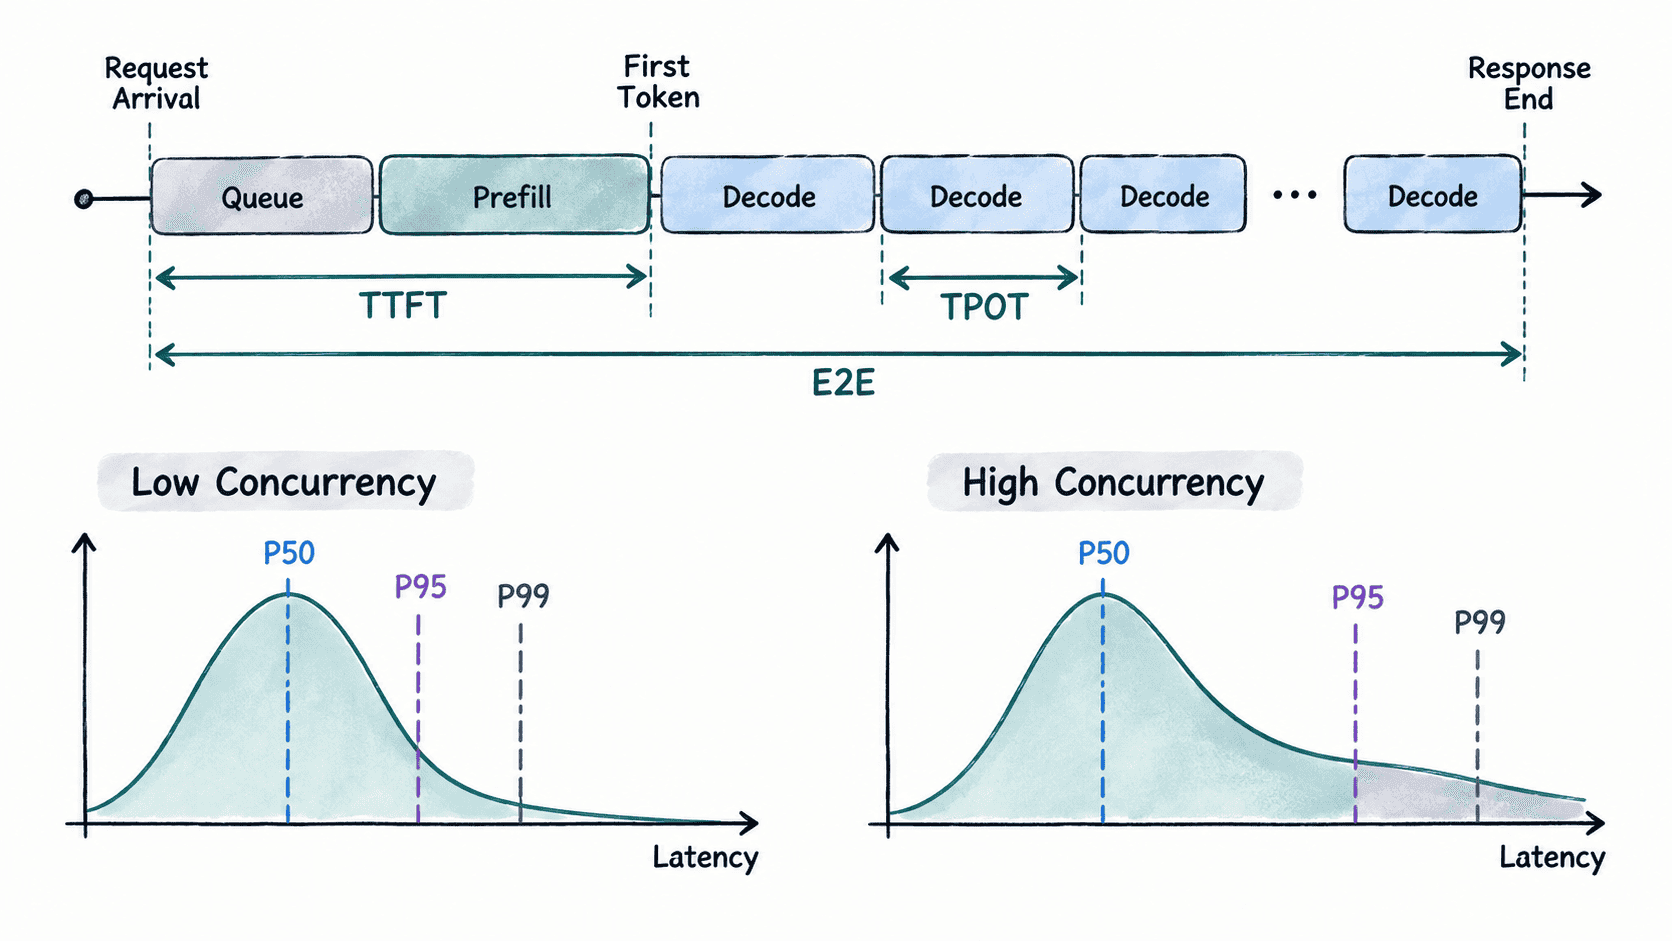
如果 TTFT 的 P95、P99 明显上升,而 TPOT 基本稳定,同时队列时间持续增长,优先怀疑排队、批处理调度或 Prefill 压力。如果 TPOT 的高分位数也同步恶化,则问题已经进入持续 Decode 阶段,应该继续检查 GPU、HBM 和 KV Cache 指标。
端到端时延尾部变长,但 TTFT 与 TPOT 都稳定时,应先检查输出长度分布。少量生成数千 token 的长请求即使每个 token 都不慢,也会自然形成很长的端到端尾部。
用脚本计算一组分位数
下面的 Python 示例使用最近邻秩方法计算一组毫秒级样本的平均值、P50、P95 和 P99。数据故意保留少量慢请求,可以直观看到平均值与尾部分位数之间的差异。
from math import ceil
from statistics import mean

samples = {
    'TTFT': [120, 125, 130, 135, 140, 145, 150, 155, 160, 165,
             170, 180, 190, 200, 220, 240, 260, 300, 900, 2500],
    'TPOT': [34, 35, 34, 36, 35, 35, 37, 36, 35, 34,
             36, 35, 37, 36, 38, 37, 39, 40, 45, 60],
    'E2E': [1200, 1250, 1300, 1280, 1350, 1400, 1380, 1450, 1500, 1520,
            1550, 1600, 1650, 1700, 1750, 1800, 1900, 2100, 3500, 6200],
}

def percentile(values, p):
    ordered = sorted(values)
    index = ceil(p * len(ordered)) - 1
    return ordered[index]

for name, values in samples.items():
    print(
        f'{name}: mean={mean(values):.2f}ms '
        f'p50={percentile(values, 0.50)}ms '
        f'p95={percentile(values, 0.95)}ms '
        f'p99={percentile(values, 0.99)}ms'
    )
预期输出
TTFT: mean=329.25ms p50=165ms p95=900ms p99=2500ms
TPOT: mean=37.70ms p50=36ms p95=45ms p99=60ms
E2E: mean=1869.00ms p50=1520ms p95=3500ms p99=6200ms
这里 TTFT 的 P50 只有 165 ms,但 P99 已达到 2500 ms,说明少量请求遭遇了明显额外等待。TPOT 的分布相对集中,不能据此直接断言 GPU Decode 是主要问题。生产基准应使用更多请求,并与线上监控或基准工具采用相同的分位数估算方法。
用组合模式判断尾延迟来源
| 观测组合 | 更值得优先检查的方向 |
|---|---|
| TTFT P99 上升,TPOT 稳定,队列时间上升 | 排队、Admission、批处理调度或 Prefill |
| TTFT 稳定,TPOT P95/P99 上升 | Decode 竞争、HBM、KV Cache 或批大小 |
| TTFT、TPOT 稳定,E2E P99 上升 | 输出长度分布中的长请求 |
| 三类时延高分位数同时恶化,队列持续增长 | 服务接近或超过饱和点 |
做并发爬坡时,应固定输入和输出长度分布,并按每个并发档位同时记录吞吐、队列时间以及三类时延的 P50、P95、P99。这样才能区分正常的长请求与真正由负载、调度或执行阶段竞争造成的尾延迟。