
大模型原理与训练 / 系统课时
用分页注意力管理 KV Cache
用分页注意力管理 KV Cache
KV Cache 会随每个请求的生成长度持续增长,若按请求预留大块连续显存,短请求、提前结束和长度差异都会留下难以利用的空洞。本篇用分页模型解释 PagedAttention 如何把逻辑连续的 KV 映射到离散物理块,并用最小模拟量化碎片差异。
学习目标
- 解释连续 KV Cache 分配产生内部碎片和外部碎片的原因
- 描述逻辑块表如何把请求 token 映射到离散的物理 KV 块
- 用简单模型比较连续预留与按需分页的容量浪费
连续分配为什么容易浪费显存
自回归生成每前进一步,就会为新 token 增加一组 K/V。请求长度未知且差异很大时,如果每个请求预留固定的最大连续空间,提前结束的请求会留下内部碎片;频繁创建和释放不同大小区域,还可能形成外部碎片,使总空闲显存很多却找不到足够大的连续区。
分页管理把 KV Cache 切成固定大小的物理块,请求只在需要时申请新块。请求的逻辑 token 序列仍然连续,但物理块可以散落在显存中,由块表记录映射关系。
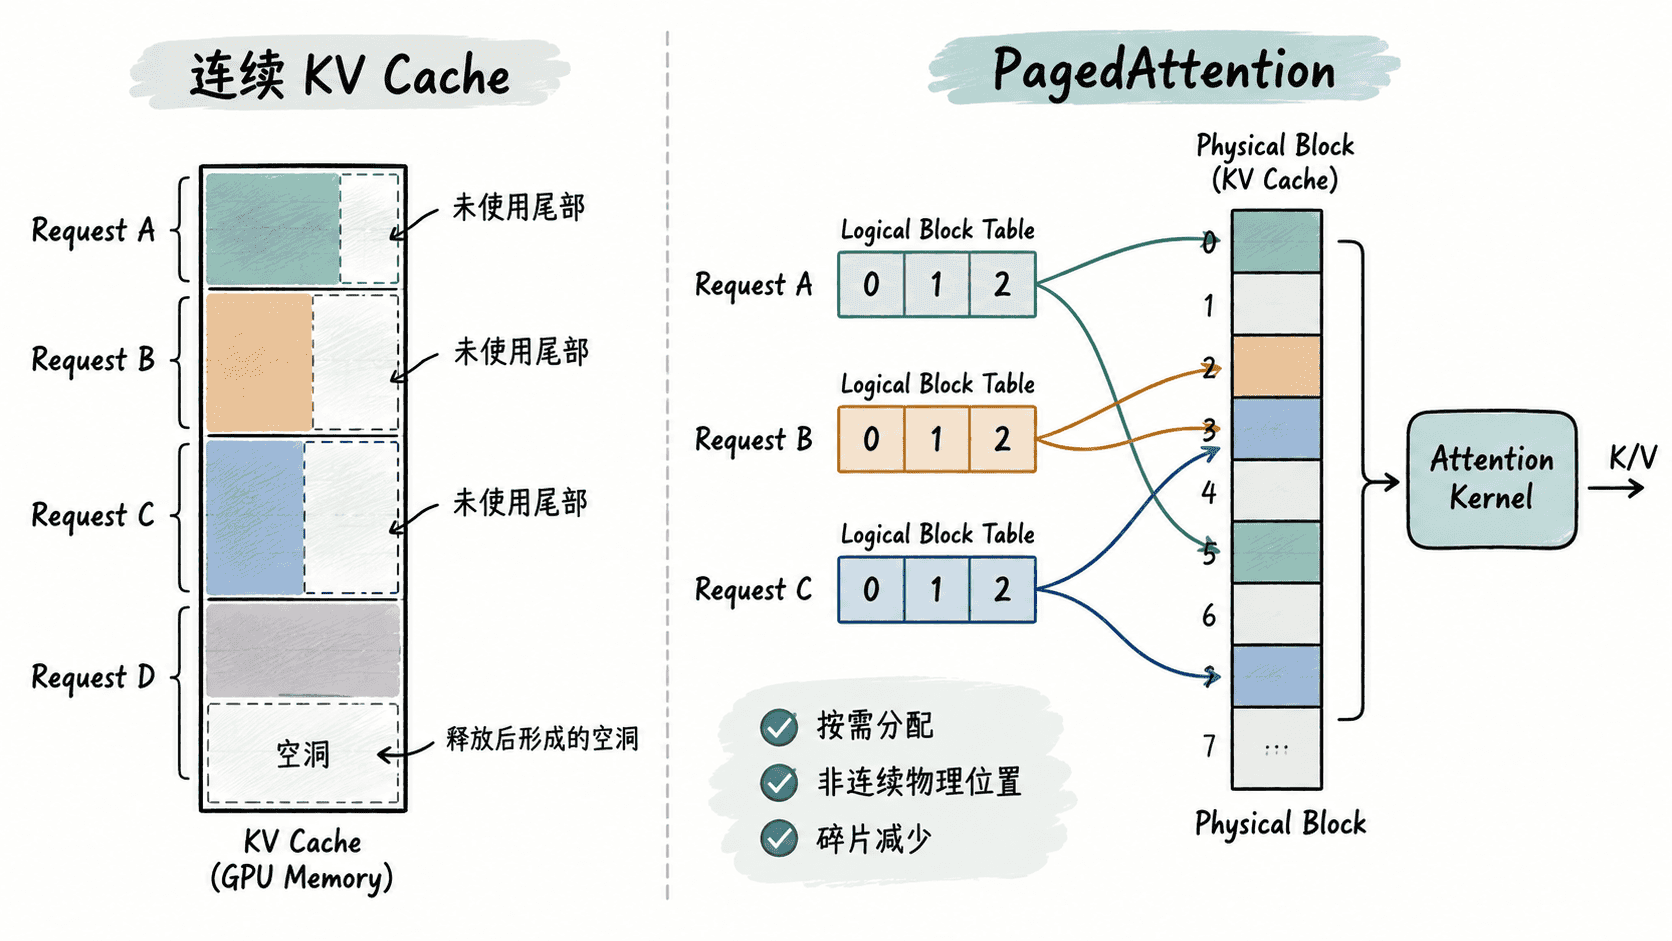
块表把逻辑连续与物理连续解耦
对某个请求来说,第 个 token 属于哪个逻辑块,只取决于块大小。调度器为逻辑块分配一个空闲物理块,并把物理块编号写入该请求的 block table;Attention 内核根据表项找到对应 K/V 数据。
因此,增长中的请求不必搬迁整个 KV Cache 来获得更大的连续空间。请求结束后,它占用的物理块也可以逐块归还。分页并不会消除所有浪费,因为最后一个块仍可能未填满,但浪费上界被限制在少量块尾空间,而不是整段最大长度预留。
用最小模拟比较碎片
下面的纯 Python 模拟只比较“容量槽位”,不代表具体引擎的字节布局。假设 4 个请求最多可生成 64 个 token;连续方案一开始就各自预留 64 个槽位,分页方案按 16-token 块按需申请。
from math import ceil

block_size = 16
max_tokens_per_request = 64
request_lengths = [5, 17, 31, 33]

used = sum(request_lengths)
contiguous_reserved = len(request_lengths) * max_tokens_per_request
paged_reserved = sum(
    ceil(length / block_size) * block_size
    for length in request_lengths
)

print("used =", used)
print("contiguous_reserved =", contiguous_reserved)
print("paged_reserved =", paged_reserved)
print("contiguous_waste =", contiguous_reserved - used)
print("paged_waste =", paged_reserved - used)
预期输出
used = 86
contiguous_reserved = 256
paged_reserved = 128
contiguous_waste = 170
paged_waste = 42
这个结果展示的是分页管理最重要的直觉:请求只为已增长到的逻辑块付费。真实系统还会受到 K/V 数据类型、层数、head 数、块元数据和调度策略影响,因此不要把这里的槽位数量直接换算为某个模型的显存字节数。
块大小需要在碎片与管理开销间取舍
块太大时,最后一个未填满块会放大内部碎片;块太小时,block table 更长,分配和地址解析更频繁,内核访问也需要处理更多块边界。合适的块大小因此既是内存问题,也是调度和 kernel 设计问题。
很多推理引擎会把分页 KV Cache 与 continuous batching、请求抢占、prefix reuse 等机制结合。评估时应保持同一模型和请求轨迹,比较 KV Cache 利用率、并发请求数、吞吐、抢占或换出次数以及尾延迟,避免只看“还能分配多少显存”这一项。
分页注意力真正解决的是“逻辑上连续增长、物理上无需连续”的矛盾。理解这层映射后,就能把显存利用率变化解释为块级按需分配的结果,而不是把 PagedAttention 简化成某个特定内核名称。