
大模型原理与训练 / 系统课时
理解预填充与解码路径
理解预填充与解码路径
一次自回归生成并不是从头到尾都以同一种方式计算。把请求拆成 Prefill 与 Decode 两段后,就能分别理解它们的计算密度、显存访问与 KV Cache 行为,并据此判断 TTFT 和逐 Token 时延为什么会呈现不同瓶颈。
学习目标
- 说明 Prefill 与 Decode 各自处理什么输入,以及它们如何衔接。
- 区分两阶段的计算密度、访存特征与 KV Cache 读写方式。
- 用 TTFT 和逐 Token 时延定位请求更可能受哪一阶段限制。
两段路径解决不同问题
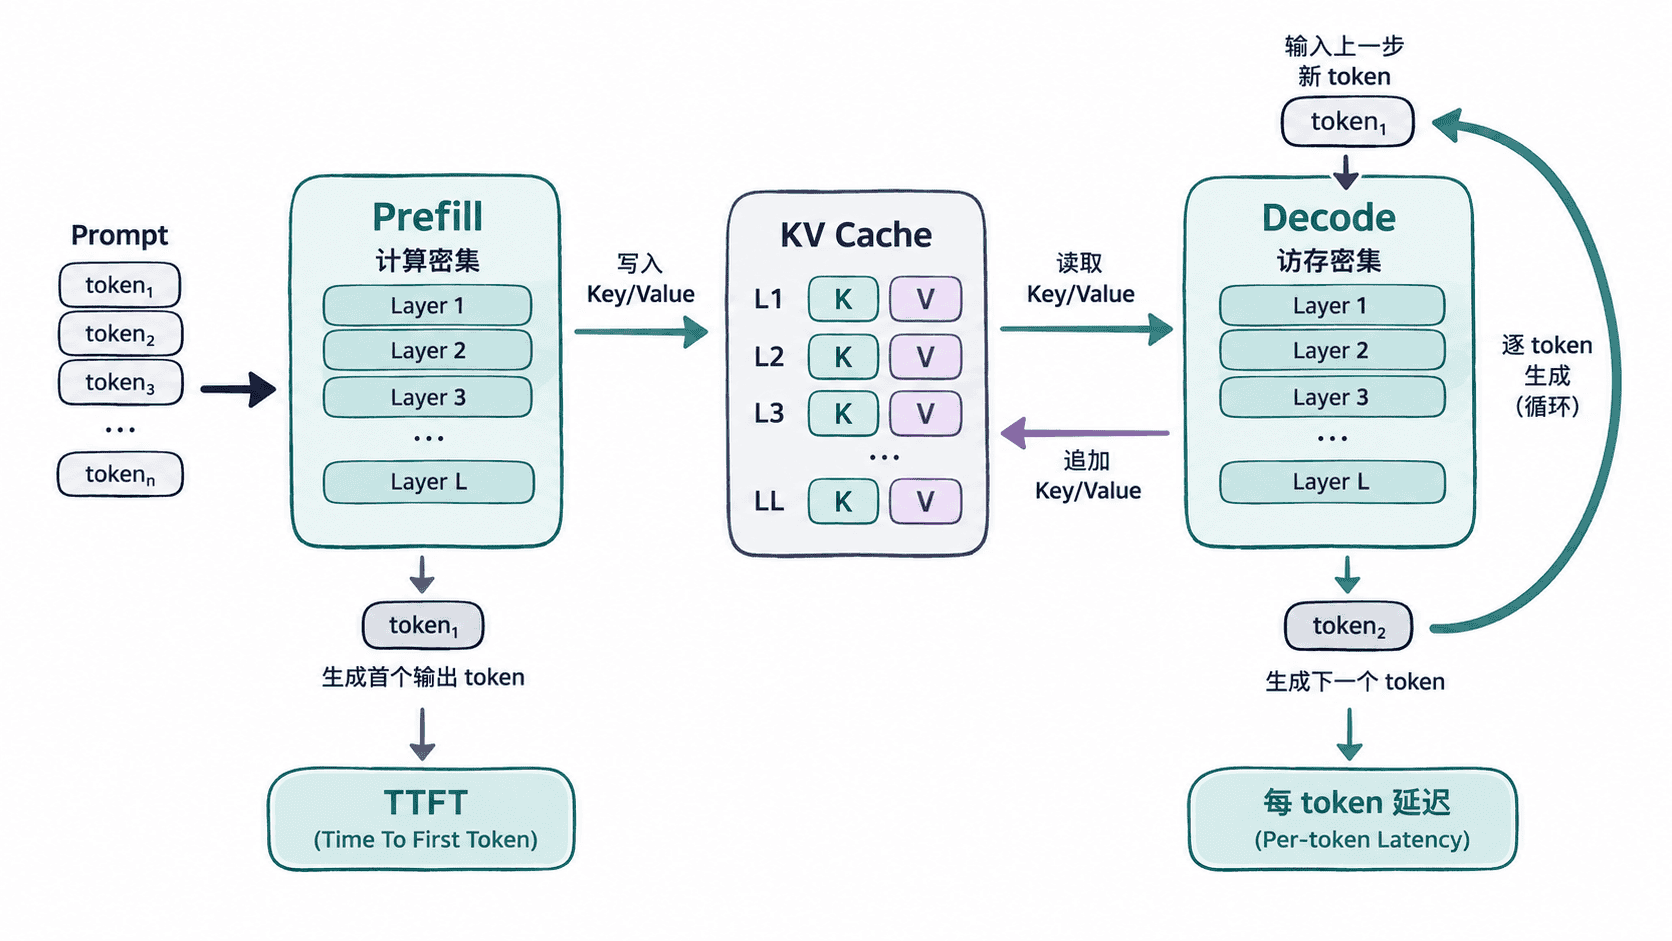
当用户提交一段已有上下文时,模型首先要一次性处理整段 Prompt,计算每一层的隐藏状态,并为后续生成准备注意力所需的 Key、Value。这一阶段就是 Prefill。它的输入 Token 数通常较多,矩阵乘法规模大,GPU 更容易获得较高计算利用率。
随后模型进入 Decode。每一步只新增一个 Token,但必须读取此前累积的 KV Cache,与已有上下文做注意力计算,再得到下一个 Token。这个过程会重复很多次,直到遇到停止条件或达到生成长度上限。
Prefill 为什么更像计算问题
Prefill 会同时处理 Prompt 中的多个 Token。对线性层和 MLP 来说,这意味着一次可以进行更大的矩阵乘法,算力单元更容易被喂满。Prompt 越长,首轮计算量通常越大,因此首 Token 出现前的等待时间会明显增加。
注意力在这一阶段还要为 Prompt 中每个位置生成并保存 Key、Value。换句话说,Prefill 不只是“算出首 Token”,还在建立后续 Decode 可复用的上下文状态。
因此,TTFT(Time To First Token)主要反映请求进入服务后到首个输出 Token 出现之间的延迟。排查 TTFT 时,应优先关注 Prompt 长度、批大小、算子吞吐、排队时间与 Prefill 调度,而不是只盯着单步 Decode。
Decode 为什么更像访存问题
Decode 每轮只计算一个新 Token,单轮矩阵计算规模较小,却要反复读取模型权重和越来越大的 KV Cache。随着上下文增长,每一步注意力需要访问的历史 Key、Value 也更多,显存带宽和缓存访问效率会逐渐成为关键约束。
这也是为什么“GPU 理论 FLOPS 很高”并不意味着逐 Token 生成一定快。Decode 的瓶颈往往不是缺少算术能力,而是算力没有足够工作可做,同时大量时间花在搬运权重与状态上。
可把单个请求的生成阶段近似理解为:
其中 是实际生成的 Token 数, 是平均单步 Decode 时延。TTFT 更接近前一项,而用户看到的持续输出速度主要受后一项影响。
KV Cache 把重复计算换成显存
如果没有 KV Cache,生成第 100 个 Token 时,模型需要重新计算前面 99 个位置在每层注意力中的 Key 和 Value。KV Cache 将这些结果保留下来,使 Decode 只计算新 Token 对应的 Key、Value,再与历史缓存进行注意力。
这个交换非常典型:它显著减少重复计算,却让显存占用随上下文长度和并发请求数增长。于是 Prefill、Decode 与 KV Cache 形成了推理优化的基本三角关系——首 Token 要快、逐 Token 要快、并发要高,往往会争夺同一块 GPU 的计算和显存资源。
用指标判断瓶颈属于哪一段
如果 TTFT 高,但首 Token 出现后流式输出很顺畅,问题更可能在排队、长 Prompt 或 Prefill 吞吐。如果 TTFT 正常,但后续 Token 间隔持续偏大,则应重点检查 Decode 批处理、KV Cache 访问、显存带宽和上下文长度。
不要用单一“请求总耗时”覆盖这两个阶段。对在线服务来说,至少应分别记录 TTFT、平均或 P95 单 Token 时延,以及最终生成吞吐。只有把两段路径拆开,后续的批处理、量化、并行和 KV Cache 优化才有明确目标。