
大模型原理与训练 / 系统课时
设计预热、健康检查与滚动升级
设计预热、健康检查与滚动升级
大模型实例“进程已启动”不等于“可以接请求”。模型权重加载、CUDA Kernel 热身和缓存初始化都可能造成长时间冷启动。本节把这些步骤纳入启动与就绪条件,并用 Kubernetes 探针和滚动策略避免冷实例抢流量或升级时切断长生成请求。
学习目标
- 区分启动、存活与就绪探针各自负责的故障类型
- 把模型加载、Kernel 热身和缓存初始化纳入
readiness条件 - 配置可保护长请求的滚动升级、摘流与优雅终止流程
把预热状态做成明确的就绪门槛
推理进程启动后至少经历“加载权重 → 初始化设备与执行引擎 → 运行代表性预热请求 → 初始化必要缓存 → 接受流量”几个阶段。只有最后一个阶段才能把实例加入负载均衡池。
启动探针负责给冷启动足够时间,避免加载模型期间被误判为死亡;存活探针只判断进程是否陷入不可恢复状态;就绪探针则判断“现在能不能接新请求”。三者复用同一个简单进程存活信号,会让冷实例过早进流量,也可能把只是暂时繁忙的健康实例重启。
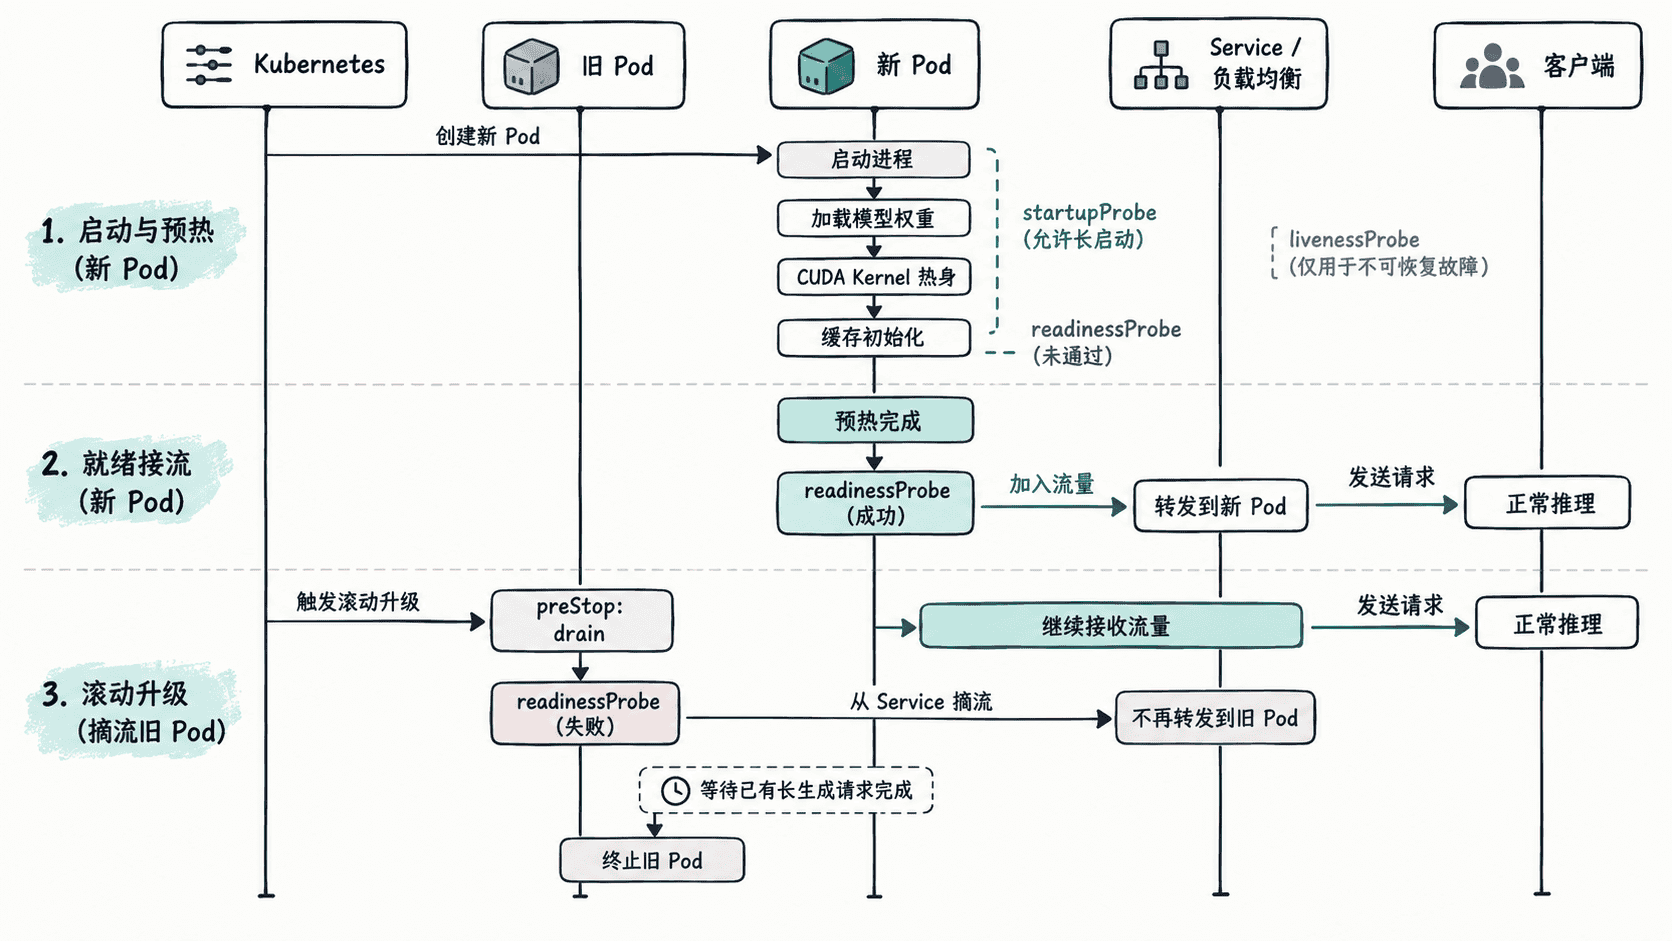
用应用状态暴露三类探针
下面是可运行的 FastAPI 示例。后台任务模拟模型加载、Kernel 热身和缓存初始化;/health/startup 只在初始化完成后成功,/health/live 只检查进程是否还能响应,/health/ready 还会检查实例是否已经进入摘流状态。运行前需要 Python 3.10+,并已安装 fastapi 与 uvicorn。
将下面内容保存为 app.py:
import asyncio
from contextlib import asynccontextmanager

import uvicorn
from fastapi import FastAPI, Response

state = {"initialized": False, "draining": False}

async def warmup():
    # 真实服务依次执行模型加载、代表性 shape 的 Kernel 热身与缓存初始化。
    await asyncio.sleep(3)
    state["initialized"] = True

@asynccontextmanager
async def lifespan(app: FastAPI):
    task = asyncio.create_task(warmup())
    yield
    await task

app = FastAPI(lifespan=lifespan)

@app.get("/health/live")
async def live():
    return {"status": "alive"}

@app.get("/health/startup")
async def startup(response: Response):
    if not state["initialized"]:
        response.status_code = 503
        return {"status": "warming"}
    return {"status": "started"}

@app.get("/health/ready")
async def ready(response: Response):
    if not state["initialized"] or state["draining"]:
        response.status_code = 503
        return {"status": "not_ready"}
    return {"status": "ready"}

@app.get("/drain")
async def drain():
    # preStop 先摘流,再等待 Endpoint 更新传播。
    state["draining"] = True
    await asyncio.sleep(20)
    return {"status": "draining"}

if __name__ == "__main__":
    uvicorn.run(app, host="0.0.0.0", port=8000)
预期结果:运行 python app.py 后,前约 3 秒访问 /health/startup 会得到 503,预热完成后返回 200;具体预热时间取决于模型大小、存储速度和 GPU 初始化成本。
配置 Kubernetes 探针和滚动策略
下面的 Deployment 配置假设镜像运行上述服务。startupProbe 最多给 30 分钟冷启动时间;它成功后才启用存活与就绪判断。maxUnavailable: 0 保证升级期间不主动减少可用副本,maxSurge: 1 允许先拉起一个新副本。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: llm-api
spec:
  replicas: 2
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0
      maxSurge: 1
  selector:
    matchLabels:
      app: llm-api
  template:
    metadata:
      labels:
        app: llm-api
    spec:
      terminationGracePeriodSeconds: 600
      containers:
        - name: api
          image: example/llm-api:<ID>
          ports:
            - containerPort: 8000
          startupProbe:
            httpGet:
              path: /health/startup
              port: 8000
            periodSeconds: 10
            failureThreshold: 180
          livenessProbe:
            httpGet:
              path: /health/live
              port: 8000
            periodSeconds: 10
            failureThreshold: 3
          readinessProbe:
            httpGet:
              path: /health/ready
              port: 8000
            periodSeconds: 5
            failureThreshold: 1
          lifecycle:
            preStop:
              httpGet:
                path: /drain
                port: 8000
配置生效行为:把 <ID> 换成不可变镜像标签或摘要后,新 Pod 在 readinessProbe 成功前不会进入 Service Endpoint;旧 Pod 收到终止流程时,preStop 先把实例设为 draining 并等待 20 秒,再进入进程终止阶段。600 秒宽限期包含 preStop 时间,因此应用服务器还需要支持优雅关闭,让已建立的长生成连接在剩余时间内结束。
先摘流,再等待长生成请求结束
理想顺序是:先把实例标成 draining,使 readiness 失败;等待 Service 或网关停止分配新请求;继续服务已经建立的生成连接;当前在途任务清零后再退出。readiness 只决定是否接受“新流量”,不应该成为杀掉“已有请求”的开关。
如果流量经过独立网关,还要确认它对 Endpoint 变化的传播延迟。preStop 的等待时间应覆盖这段延迟,而不是随意固定为 20 秒;长生成请求的最大允许时长则应与 terminationGracePeriodSeconds、应用服务器优雅关闭超时共同设计。
验证升级没有冷流量和请求中断
执行滚动状态检查:
kubectl rollout status deployment/llm-api
kubectl get pods -l app=llm-api
预期输出:
deployment "llm-api" successfully rolled out
NAME                       READY   STATUS    RESTARTS   AGE
llm-api-<ID>-<ID>          1/1     Running   0          <TIME>
llm-api-<ID>-<ID>          1/1     Running   0          <TIME>
Pod 名称、年龄和时间属于动态值,实际结果会不同。升级期间还应从网关或服务指标确认:新副本首次 readiness 成功前请求数为 0;旧副本进入 draining 后新请求数迅速降为 0;在途生成请求能在终止宽限期内正常结束。
避免两个常见误判
不要把“GPU 很忙”直接判为 liveness 失败,否则高负载会触发重启风暴;短暂容量不足应该由调度器、队列或 503 处理。也不要只做一次极短空请求作为预热,实际流量若存在不同 batch、上下文长度、量化或图捕获路径,应选择少量代表性 shape 触发真正会用到的执行路径。
上线判据应同时满足:新实例完成模型与执行路径预热后才接流量,旧实例先摘流再结束在途请求,探针不会把正常冷启动或短时繁忙误判为进程故障。