
大模型原理与训练 / 系统课时
用流式响应缩短用户等待
用流式响应缩短用户等待
流式 API 的价值不是“把完整答案切小块”,而是把后端生成进度真实地暴露给客户端。本节定义一套最小 SSE 事件契约,实现首包、增量 Token、完成信号与异常中断,并用可执行接口验证用户看到的等待时间是否真的缩短。
学习目标
- 设计
meta、token、done、error四类事件,让客户端能判断生成状态 - 实现一个可运行的 SSE 接口,并正确处理客户端断开和服务端异常
- 区分传输首包与首个可见 Token,用指标验证流式链路没有被代理缓冲
先固定流式事件契约
SSE 响应使用 text/event-stream,事件之间用空行分隔。对于推理服务,不要让客户端靠“连接断了”猜测是否正常完成,而应定义明确的完成事件。最小契约可以保持四类事件:meta 表示请求已接收,token 只携带新增文本,done 给出正常结束原因,error 表示仍可在连接上报告的生成失败。
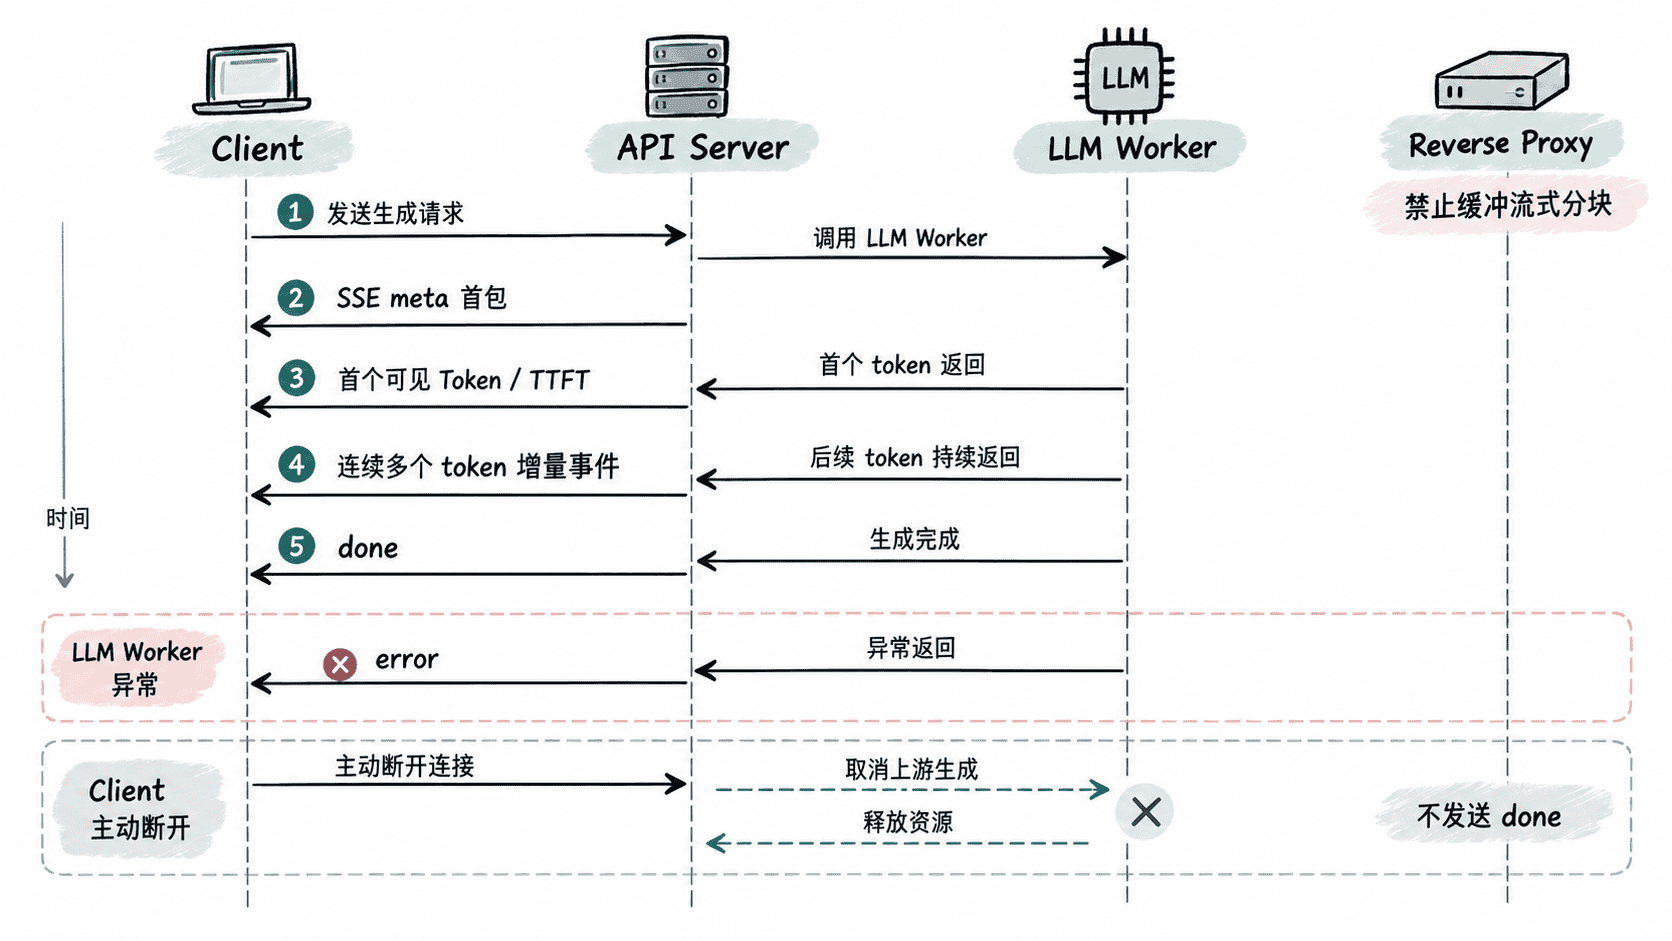
传输层的“首包”与用户真正感知到的“首个 Token”不是一回事。meta 可以很快到达,用来确认请求已进入服务;真正的 TTFT 应从请求接收到第一条 token 事件计算,否则服务可能只是很快回了一个空壳事件,模型仍然让用户等待很久。
实现一个可验证的 SSE 接口
下面用 FastAPI 构造最小服务。示例模型用异步生成器模拟三个 Token,替换 fake_model() 即可接入真实推理引擎。服务端在每次发送前检查客户端是否已经断开;生成异常时只返回稳定错误码,不把内部异常细节暴露给客户端。
import asyncio
import json
import uuid
from collections.abc import AsyncIterator

from fastapi import FastAPI, Request
from pydantic import BaseModel
from starlette.responses import StreamingResponse

app = FastAPI()

class GenerateRequest(BaseModel):
    prompt: str

def sse(event: str, payload: dict) -> str:
    data = json.dumps(payload, ensure_ascii=False, separators=(",", ":"))
    return f"event: {event}\ndata: {data}\n\n"

async def fake_model(prompt: str) -> AsyncIterator[str]:
    # 真实服务应在这里迭代推理引擎的增量输出。
    _ = prompt
    for token in ["你", "好", "。"]:
        await asyncio.sleep(0.08)
        yield token

@app.post("/v1/generate")
async def generate(body: GenerateRequest, request: Request) -> StreamingResponse:
    request_id = uuid.uuid4().hex

    async def event_stream() -> AsyncIterator[str]:
        # meta 代表传输首包,不能把它当成首个可见 Token。
        yield sse("meta", {"request_id": request_id})
        try:
            async for token in fake_model(body.prompt):
                if await request.is_disconnected():
                    return
                yield sse("token", {"delta": token})
            yield sse("done", {"finish_reason": "stop"})
        except asyncio.CancelledError:
            raise
        except Exception:
            yield sse("error", {"code": "generation_failed"})

    return StreamingResponse(
        event_stream(),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "X-Accel-Buffering": "no",
        },
    )
预期结果:服务收到请求后先发送 meta,随后逐条发送三个 token,最后发送 done;若客户端提前断开,生成器停止继续发送。X-Accel-Buffering 是面向 Nginx 的缓冲提示,其他代理仍需单独检查流式配置。
保存为 app.py,安装好 FastAPI 与 Uvicorn 后,将 <PORT> 替换为实际端口,再启动服务并用 curl -N 观察分块是否实时到达。
uvicorn app:app --host 127.0.0.1 --port <PORT> &
SERVER_PID=$!
sleep 1
curl -N -s -X POST "http://127.0.0.1:<PORT>/v1/generate" -H "Content-Type: application/json" -d '{"prompt":"hello"}'
kill "${SERVER_PID}"
预期输出中 <ID> 会因请求而变化;事件之间应有空行,并且三条 token 应随生成过程逐步出现,而不是最后一次性到达。
event: meta
data: {"request_id":"<ID>"}

event: token
data: {"delta":"你"}

event: token
data: {"delta":"好"}

event: token
data: {"delta":"。"}

event: done
data: {"finish_reason":"stop"}
如果 curl -N 仍然在结束时一次性打印全部事件,应先检查反向代理、网关或 CDN 是否缓冲响应,而不是先修改模型推理代码。
正确处理完成、错误和主动断开
正常完成必须发 done,客户端收到后再把请求状态改成完成;模型异常且连接仍可写时发 error,随后结束连接。不要在 error 后继续伪造 done,否则前端无法区分完整答案与部分答案。
客户端主动断开是另一种情况:连接已经不存在,服务端无法可靠地再发 error 或 done。正确动作是尽快取消上游生成、释放 KV Cache、批次槽位或其他资源。真实推理引擎如果支持取消请求,应把断开信号继续传播到引擎,而不是只停止 HTTP 写出。
用等待指标验收流式体验
至少记录四个时间点:请求进入 API、首字节发送、首个 token 发送、最后一个 token 或终止事件发送。由此可以同时观察传输首包、TTFT、持续生成速度与完整请求时长。若首字节很快但首 Token 仍慢,瓶颈在排队或模型;若服务端逐步发送而客户端一次性收到,瓶颈更可能在代理或客户端解析链路。
上线前还要验证取消是否真正回收推理资源。流式服务只有在“首 Token 更早、增量持续到达、正常结束可识别、异常与断开能清理资源”四件事同时成立时,才真正缩短了用户等待,而不是只改变了响应格式。