
大模型原理与训练 / 系统课时
用 TensorRT-LLM 构建引擎
用 TensorRT-LLM 构建引擎
本节把 Hugging Face 权重转换为可加载的 TensorRT-LLM 引擎,并把并行、插件与构建边界落到实际命令中。你会得到一套可复现的构建流程,也会知道哪些优化必须在权重阶段决定。
学习目标
- 说清权重转换、并行切分、引擎构建与运行时加载之间的关系
- 用固定版本完成单卡 TensorRT-LLM 引擎构建并验证产物
- 区分算子插件、量化与并行策略进入引擎的不同位置,并记录构建成本与推理收益
先固定可构建引擎的版本
截至 2026 年 9 月,TensorRT-LLM 当前版本已移除 TensorRT engine backend、trtllm-build 和按模型转换脚本,新项目改为直接加载 Hugging Face 权重并使用 trtllm-serve 或 LLM API。为了完整复现“转换权重→构建引擎”的流程,本节固定使用仍保留该能力的 1.1.0 环境。([NVIDIA GitHub Pages][1])
先确认 GPU 容器中仍有构建工具。宿主机需要可用的 NVIDIA 驱动、Docker 与 NVIDIA Container Toolkit。
docker run --rm --gpus all \
  nvcr.io/nvidia/tensorrt-llm/release:1.1.0 \
  bash -lc 'command -v trtllm-build >/dev/null && echo "trtllm-build=OK"'
预期输出
trtllm-build=OK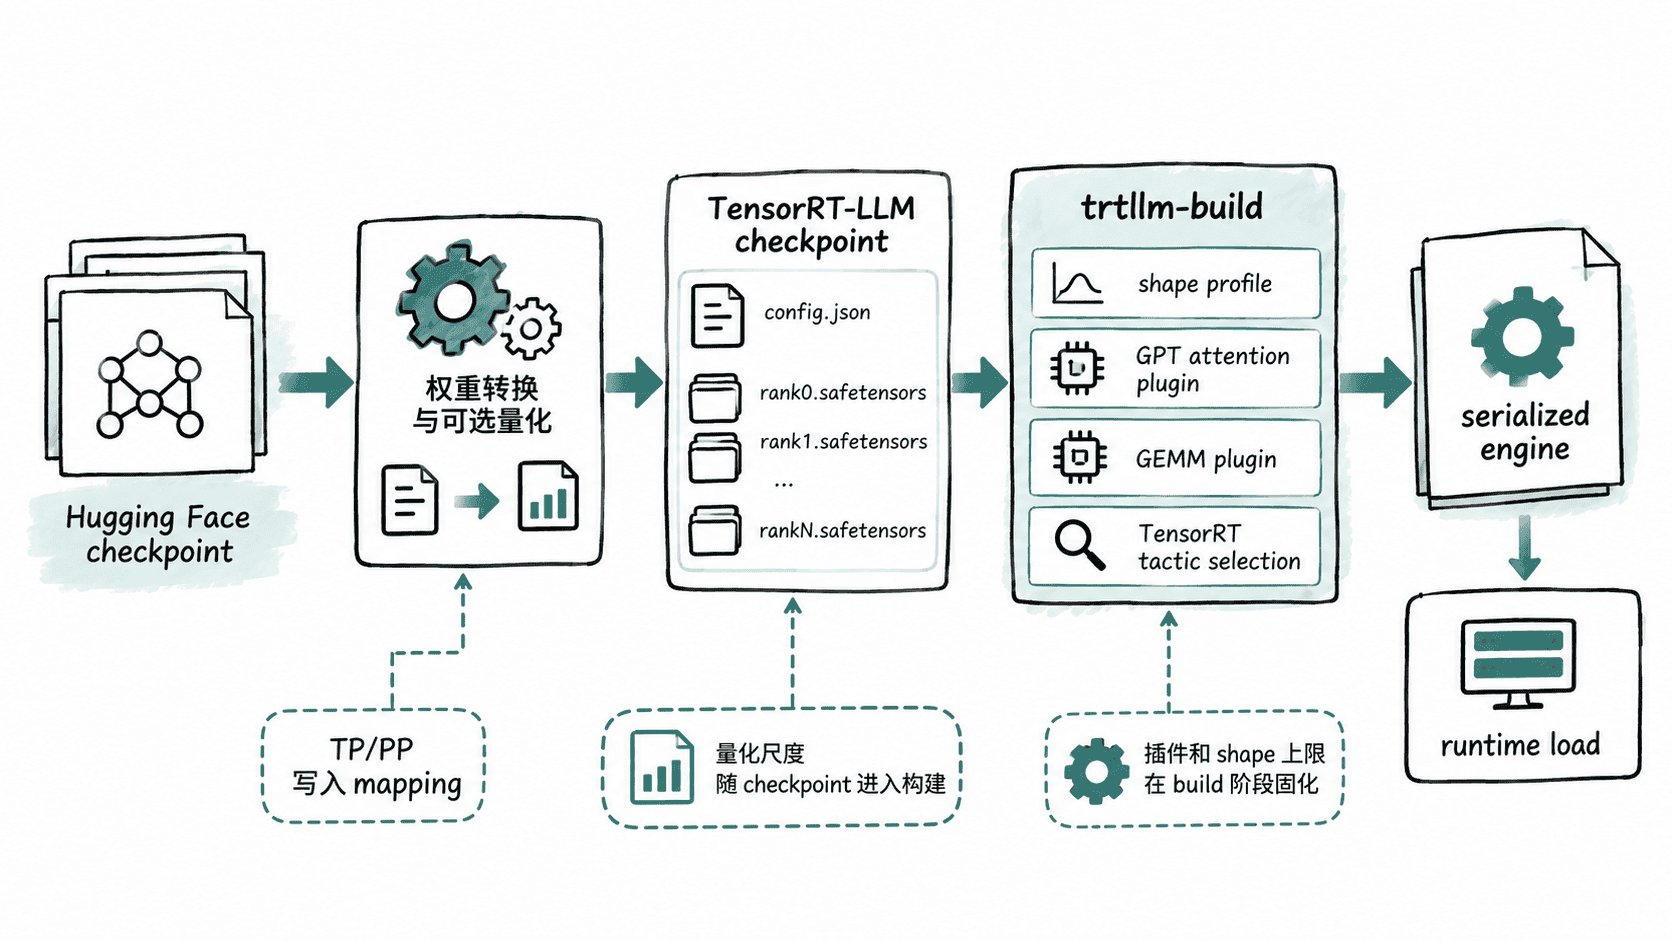
转换权重并写入并行映射
TensorRT-LLM 的旧式流程先把训练框架权重转成统一 checkpoint。config.json 保存模型结构与 mapping,rank<N>.safetensors 保存各并行 rank 的权重分片;因此 TP/PP 不是构建后再临时添加,而是在转换时就决定权重如何切分。([NVIDIA GitHub Pages][2])
下面用公开的 TinyLlama 做单卡演示。真实大模型只需替换模型目录,并按 GPU 数量调整 --tp_size、--pp_size。
mkdir -p "$PWD/tllm-work/models" "$PWD/tllm-work/artifacts"

docker run --rm --gpus all --ipc=host \
  -v "$PWD/tllm-work:/workspace" \
  nvcr.io/nvidia/tensorrt-llm/release:1.1.0 \
  bash -lc '
    set -euo pipefail
    MODEL_DIR=/workspace/models/tinyllama
    CKPT_DIR=/workspace/artifacts/tinyllama-ckpt

    python3 - <<'"'"'PY'"'"'
from huggingface_hub import snapshot_download
snapshot_download(
    repo_id="TinyLlama/TinyLlama-1.1B-Chat-v1.0",
    local_dir="/workspace/models/tinyllama",
)
PY

    cd /app/tensorrt_llm/examples/models/core/llama
    python3 convert_checkpoint.py \
      --model_dir "$MODEL_DIR" \
      --dtype float16 \
      --tp_size 1 \
      --pp_size 1 \
      --output_dir "$CKPT_DIR"

    test -f "$CKPT_DIR/config.json"
    test -f "$CKPT_DIR/rank0.safetensors"
    echo "checkpoint=OK"
  '
预期输出
checkpoint=OK如果要做 FP8、AWQ 或其他低精度方案,应先用该版本支持的量化流程生成带量化权重与尺度信息的 checkpoint,再构建引擎;构建器只能消费已有的量化表示,不能把普通 FP16 权重“凭空变成”正确的校准量化模型。
构建引擎并固化运行边界
构建阶段会根据 checkpoint、最大 batch、输入长度和总序列长度创建优化 profile,并选择 TensorRT tactic。gpt_attention_plugin、gemm_plugin 等插件把高频模式映射到专用实现;当前 CLI 也把 fused attention、去 padding 等能力作为 build 配置暴露。([NVIDIA GitHub Pages][3])
继续用同一个工作目录构建引擎,并记录一次性构建耗时。max_seq_len 是输入与输出合计上限,因此不能只按 prompt 长度设置。
docker run --rm --gpus all --ipc=host \
  -v "$PWD/tllm-work:/workspace" \
  nvcr.io/nvidia/tensorrt-llm/release:1.1.0 \
  bash -lc '
    set -euo pipefail
    CKPT_DIR=/workspace/artifacts/tinyllama-ckpt
    ENGINE_DIR=/workspace/artifacts/tinyllama-engine

    started=$(date +%s)
    trtllm-build \
      --checkpoint_dir "$CKPT_DIR" \
      --output_dir "$ENGINE_DIR" \
      --gpt_attention_plugin float16 \
      --gemm_plugin float16 \
      --max_batch_size 4 \
      --max_input_len 512 \
      --max_seq_len 768

    elapsed=$(( $(date +%s) - started ))
    test -f "$ENGINE_DIR/config.json"
    find "$ENGINE_DIR" -maxdepth 1 -type f -name "*.engine" -print -quit | grep -q .
    printf "engine=OK\nbuild_seconds=%s\n" "$elapsed"
  '
预期输出
engine=OK
build_seconds=<TIME>
<TIME> 取决于 GPU、模型大小和 tactic 搜索。构建失败时优先检查三件事:checkpoint mapping 是否与可见 GPU 数量一致、长度和 batch 上限是否造成显存不足、量化 checkpoint 与所选插件精度是否匹配。
加载引擎并验证生成
引擎构建成功不等于运行时一定可加载。最直接的验收是用同版本运行时加载引擎并完成一次生成;这能同时暴露反序列化、tokenizer、GPU 兼容性和并行 rank 不一致等问题。
docker run --rm --gpus all --ipc=host \
  -v "$PWD/tllm-work:/workspace" \
  nvcr.io/nvidia/tensorrt-llm/release:1.1.0 \
  bash -lc '
    python3 /app/tensorrt_llm/examples/run.py \
      --engine_dir /workspace/artifacts/tinyllama-engine \
      --tokenizer_dir /workspace/models/tinyllama \
      --input_text "The capital of France is" \
      --max_output_len 16
  '
预期输出
Input [Text 0]: "The capital of France is"
Output [Text 0 Beam 0]: "<GENERATED_TEXT>"
生成文本会随采样配置与实现细节变化,因此验收重点是引擎成功加载、请求完成且输出非空,不应把某一句自然语言结果当成二进制兼容性测试。
用同一负载记录收益
不要用“构建成功”代替性能结论。至少在同一块 GPU、同一模型、同一 prompt 集、同一输出长度与并发条件下,对基线和引擎分别记录 TTFT、每 token 延迟、输出 tokens/s、峰值显存和错误率。
| 指标 | 基线运行时 | TensorRT-LLM 引擎 | 判断重点 |
|---|---|---|---|
| 一次性构建时间 | 0 | 实测 | 是否能被长期复用抵消 |
| TTFT | 实测 | 实测 | 交互延迟是否改善 |
| 输出 tokens/s | 实测 | 实测 | 吞吐是否提升 |
| 峰值 GPU 显存 | 实测 | 实测 | 是否释放更多并发空间 |
| 结果一致性 | 基准输出 | 对比输出 | 量化后是否仍满足质量阈值 |
如果收益很小,先检查 workload 是否命中构建 profile,再看 batch、序列长度、插件和精度是否与真实流量一致。对 2026 年的新部署,还应把旧式 engine build 与当前 PyTorch backend 的 trtllm-serve 方案做同负载对比,而不是因为“引擎”这个名词就默认它更快。