
大模型原理与训练 / 系统课时
用投机解码降低 Decode 延迟
用投机解码降低 Decode 延迟
投机解码不是让小模型替代大模型,而是让草稿模型先提议若干 Token,再由目标模型批量校验。本篇聚焦提议、接受与回退链路,并用接受率、加速比和草稿计算占比判断它是否真的降低 Decode 延迟。
学习目标
- 解释草稿模型提议、目标模型校验和拒绝后回退的完整流程。
- 根据草稿模型成本、接受率和候选长度选择合理组合。
- 用固定负载测量加速收益,判断是否值得在时延敏感服务中启用。
理解提议与校验
普通自回归解码每生成一个 Token 都要执行一次目标模型前向计算。投机解码先让更便宜的草稿模型连续提出 个候选 Token,再让目标模型用一次前向过程校验这一段候选,因此有机会用一次目标模型计算推进多个 Token。
校验并不是简单判断整段对错。目标模型从候选序列开头逐个检查,连续接受的前缀可以直接提交;首次不接受的位置按具体算法执行校正或从目标模型分布重新采样,然后开始下一轮提议。标准的接受与拒绝校正实现可以保持目标模型原有采样分布,而不是用草稿模型的输出替换目标模型。
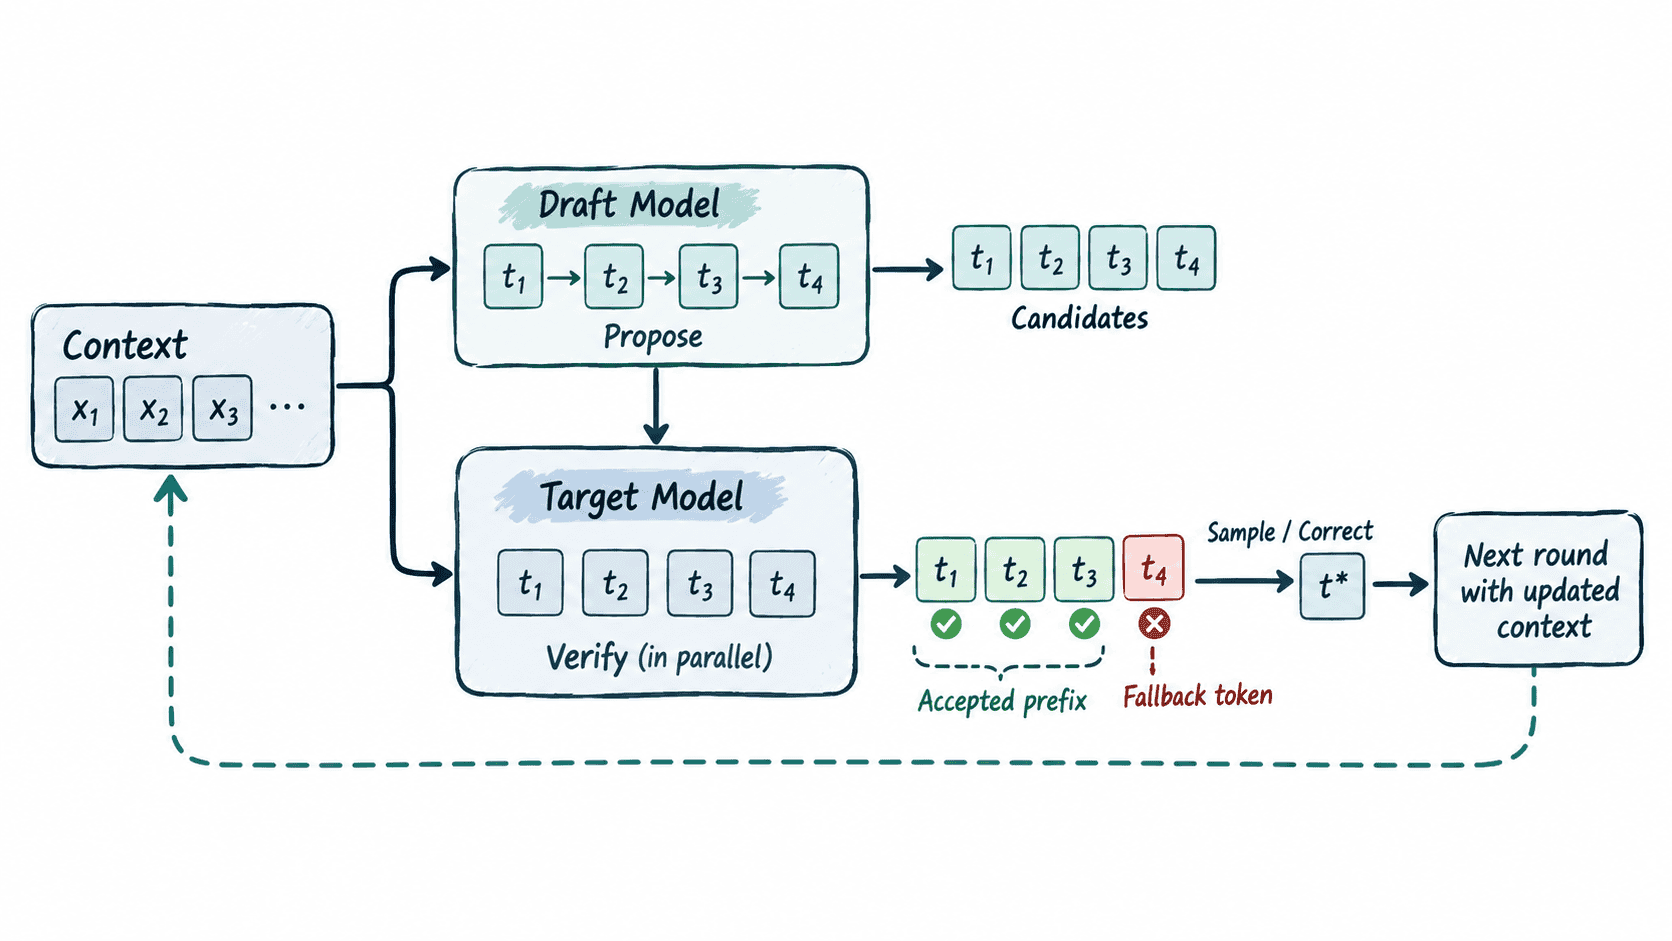
投机解码真正节省的是目标模型的串行 Decode 步数,但会新增草稿模型计算和候选校验工作。因此它不是免费加速:如果大量候选最终被拒绝,草稿计算反而会成为额外负担。
选草稿模型与候选长度
草稿模型首先要足够便宜,其次才是足够准确。一个与目标模型极其接近、但运行成本只略低的草稿模型,即使接受率很高,也可能因为提议本身过慢而没有端到端收益。实际部署还要确认推理框架要求的词表、Tokenizer 或模型族兼容条件。
候选长度 决定每轮最多尝试推进多少 Token。较小的 几乎不会积累大量无效候选,但目标模型每次校验能合并的 Decode 步数有限;较大的 能提高单轮理论推进量,却更容易在前部发生不匹配,使后面的候选全部失去价值。
选择时不要只比较接受率。例如 的接受率可能高于 ,但后者仍可能因为每次校验能接受更多 Token 而拥有更低的平均 Decode 时延。通常应同时记录接受 Token 数、端到端时延、草稿计算时间和目标模型校验时间。
量化接受率和计算代价
接受率可定义为已接受候选数除以草稿模型提出的候选总数。下面的完整 Python 示例使用同一组请求在不同候选长度下得到的示例压测数据,计算接受率、相对基线加速比和草稿计算占比,并按端到端加速比选择候选长度。真实测试时应把数组中的数据替换成服务端采集结果。
baseline_ms = 100_000

runs = [
    {"k": 2, "proposed": 6_000, "accepted": 5_100, "latency_ms": 84_000, "draft_ms": 9_000},
    {"k": 4, "proposed": 12_000, "accepted": 9_000, "latency_ms": 72_000, "draft_ms": 15_000},
    {"k": 8, "proposed": 24_000, "accepted": 12_000, "latency_ms": 82_000, "draft_ms": 28_000},
]

for run in runs:
    run["accept_rate"] = run["accepted"] / run["proposed"]
    run["speedup"] = baseline_ms / run["latency_ms"]
    # 草稿计算占总投机解码时间的比例,可作为额外计算成本的直观指标。
    run["draft_share"] = run["draft_ms"] / run["latency_ms"]
    print(
        f"k={run['k']} "
        f"accept={run['accept_rate']:.1%} "
        f"speedup={run['speedup']:.2f}x "
        f"draft_share={run['draft_share']:.1%}"
    )

best = max(runs, key=lambda run: run["speedup"])
print(f"best_k={best['k']}")
预期输出
k=2 accept=85.0% speedup=1.19x draft_share=10.7%
k=4 accept=75.0% speedup=1.39x draft_share=20.8%
k=8 accept=50.0% speedup=1.22x draft_share=34.1%
best_k=4这个结果说明最高接受率并不等于最佳配置。k=2 虽然接受率最高,但目标模型每轮推进的 Token 较少;k=8 又因为拒绝增多和草稿成本上升丢失收益。当前负载下,k=4 的端到端加速比最好。
判断哪些请求值得启用
投机解码通常更适合低到中等并发、Decode 占比高且对单请求时延敏感的负载。在这类场景中,GPU 还有余量执行额外草稿计算,而减少目标模型串行 Decode 轮次可以直接改善 TPOT 或整段生成时间。
当服务已经处于高并发饱和状态时,需要特别谨慎。投机解码会增加每个请求消耗的计算量和临时资源,如果额外计算挤占批处理容量,单请求虽然可能少做几轮目标模型 Decode,整个服务的 Token 吞吐却可能下降。
接受率持续偏低、草稿计算占比不断升高或高并发吞吐明显下降,都是缩短候选长度、换更合适草稿模型或直接关闭投机解码的信号。最终目标不是追求最高接受率,而是在目标业务负载下用更少的端到端时间生成同样符合目标模型分布的结果。