
大模型原理与训练 / 系统课时
构建可复现的 GPU 推理镜像
构建可复现的 GPU 推理镜像
同一套推理代码在开发机能跑、换到压测或生产节点却行为不同,通常不是“容器失效”,而是基础镜像、CUDA、Python 依赖、缓存目录或启动参数没有被固定。本节把这些变量收敛进镜像与显式运行参数,并用 GPU 自检证明镜像在不同节点具备一致的启动基础。
学习目标
- 固定基础镜像、CUDA 运行时和 Python 依赖,减少环境漂移。
- 设计稳定的镜像层与缓存目录,让构建可重复且不把临时缓存写进最终层。
- 用容器内版本与 CUDA 可用性检查验证镜像,而不是只看构建成功。
先把可复现拆成四层
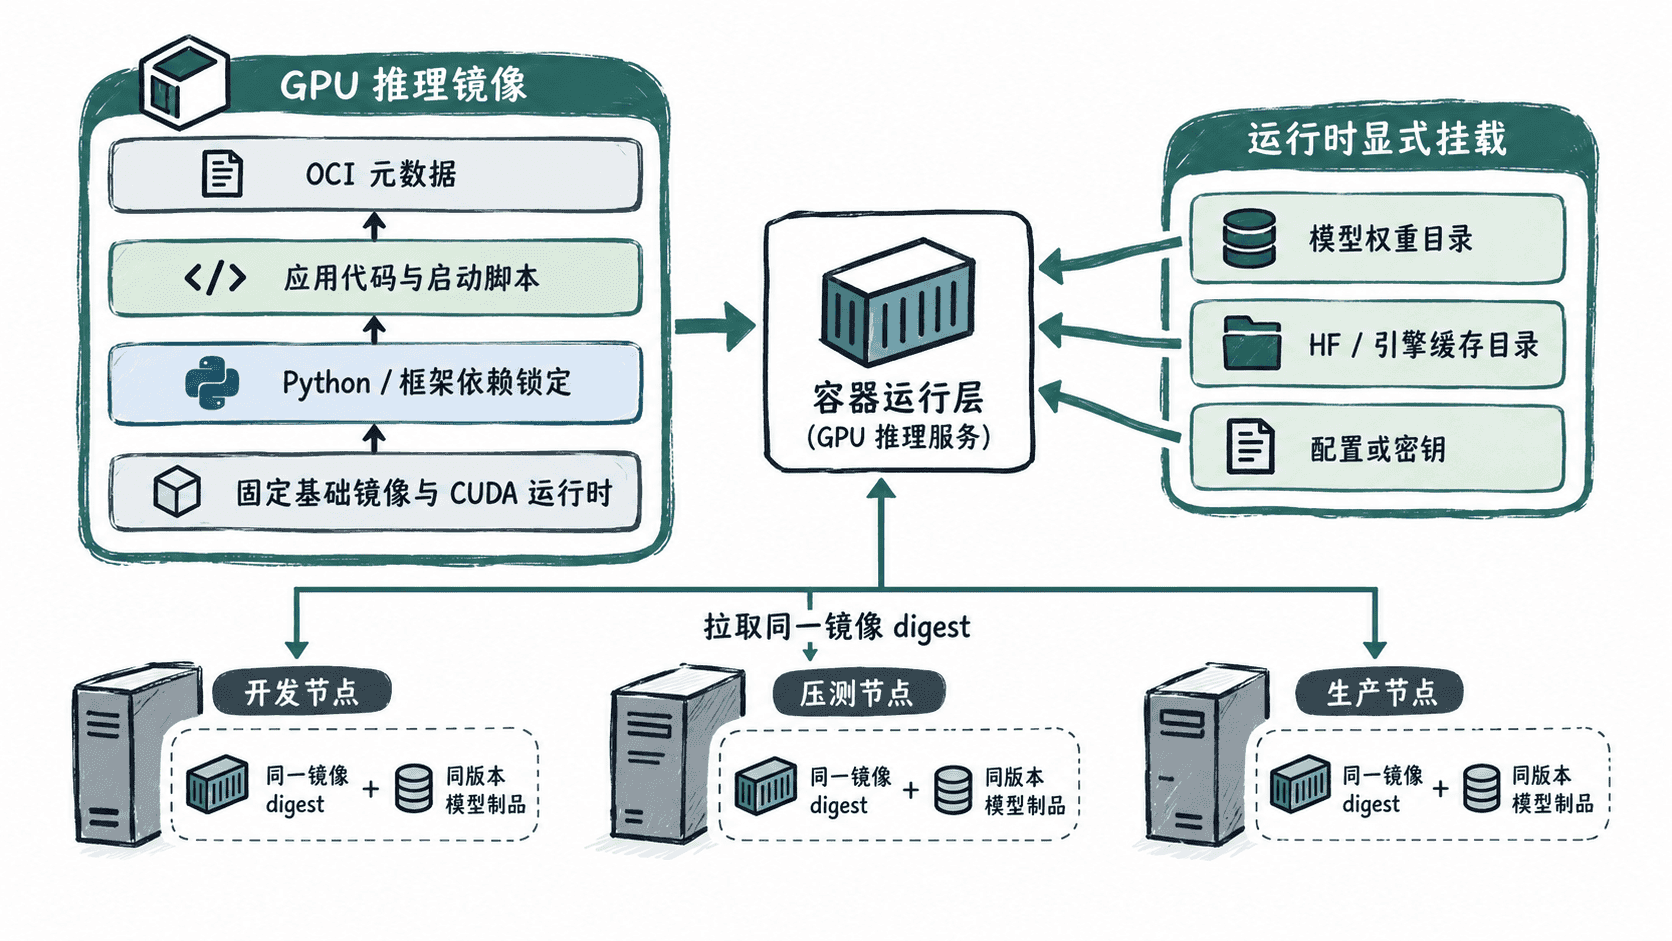
可复现至少包含四个层面:基础镜像决定操作系统和 CUDA 用户态运行库;Python 环境决定框架与推理依赖;应用层决定启动脚本和默认参数;运行时挂载决定模型权重、缓存和配置从哪里来。任何一层使用 latest、未锁版本或依赖宿主机隐式目录,都可能让相同 Dockerfile 在不同时间得到不同结果。
模型权重本身也要单独版本化。镜像可复现不等于模型可复现;生产环境应记录模型仓库 revision、校验值或内部制品版本,并把模型目录显式挂载到容器,而不是依赖某台机器已经下载过的缓存。
准备最小可验证镜像
下面用固定的 PyTorch CUDA 运行时作为基础镜像,再锁定 Transformers 与 Safetensors 版本。requirements.lock 是配置文件,不单独运行;生产仓库应把它与 Dockerfile 一起纳入版本控制。
transformers==4.48.0
safetensors==0.5.2
版本检查脚本只做三件事:输出框架版本、输出编译时 CUDA 版本、确认容器能看到 GPU。它不加载模型,因此适合在开发、压测和生产节点上快速判断“镜像与 GPU 运行时是否一致”。
import torch
import transformers

print(f"torch={torch.__version__}")
print(f"transformers={transformers.__version__}")
print(f"cuda_runtime={torch.version.cuda}")

if not torch.cuda.is_available():
    raise SystemExit("CUDA is not available")

print("cuda_available=True")
Dockerfile 把依赖安装放在应用代码之前,使依赖层可以稳定复用;BuildKit 的 pip 缓存只参与构建,不进入最终镜像。HF_HOME 使用固定目录,后续可以在运行时把缓存或预下载模型显式挂载到这里。
# syntax=docker/dockerfile:1.7
ARG BASE_IMAGE=pytorch/pytorch:2.5.1-cuda12.4-cudnn9-runtime
FROM ${BASE_IMAGE}

ARG APP_VERSION=1.0.0
WORKDIR /app

ENV PIP_DISABLE_PIP_VERSION_CHECK=1 PYTHONDONTWRITEBYTECODE=1 HF_HOME=/cache/hf

COPY requirements.lock /app/requirements.lock
RUN --mount=type=cache,target=/root/.cache/pip python -m pip install -r /app/requirements.lock

COPY version_check.py /app/version_check.py

LABEL org.opencontainers.image.version="${APP_VERSION}"

CMD ["python", "/app/version_check.py"]
为了得到真正不可漂移的生产镜像,完成首次验证后应把 BASE_IMAGE 从普通 tag 改为 image@sha256:<ID> 形式,并在制品记录中保存最终镜像 digest。这样即使上游 tag 被重新指向,构建输入仍然不变。
构建并验证 GPU 行为
在包含 Dockerfile、requirements.lock 和 version_check.py 的目录执行以下命令。--gpus all 依赖宿主机已正确安装 NVIDIA Container Toolkit;如果这里只失败而镜像构建成功,应先修宿主机 GPU 容器运行时,不要重新安装镜像内 Python 包。
DOCKER_BUILDKIT=1 docker build -t llm-inference:1.0.0 .
docker run --rm --gpus all llm-inference:1.0.0
预期输出:
torch=2.5.1
transformers=4.48.0
cuda_runtime=12.4
cuda_available=True
如果开发节点和生产节点得到的版本行不同,说明两边运行的不是同一镜像制品;如果版本相同但 cuda_available 失败,则问题位于宿主机驱动、容器运行时或 GPU 分配层,而不是应用依赖层。
控制缓存与启动差异
不要在容器启动时临时 pip install,否则同一镜像会因为外部仓库变化而产生不同进程环境。模型缓存也不要默认写入用户家目录;应固定到如 /cache/hf 的明确路径,并通过卷或持久盘控制其生命周期。需要只读模型制品时,可以把权重目录与下载缓存分开,避免推理进程误改模型文件。
开发、压测和生产还应共享同一条启动入口,只通过环境变量或参数传入环境差异,例如模型路径、端口和并发上限。镜像内负责提供稳定的软件栈,集群编排层负责提供 GPU、挂载和配置;把这两个职责分开,才能在节点变化时仍然复现相同的启动行为。