
大模型原理与训练 / 系统课时
用 SGLang 加速结构化工作流
用 SGLang 加速结构化工作流
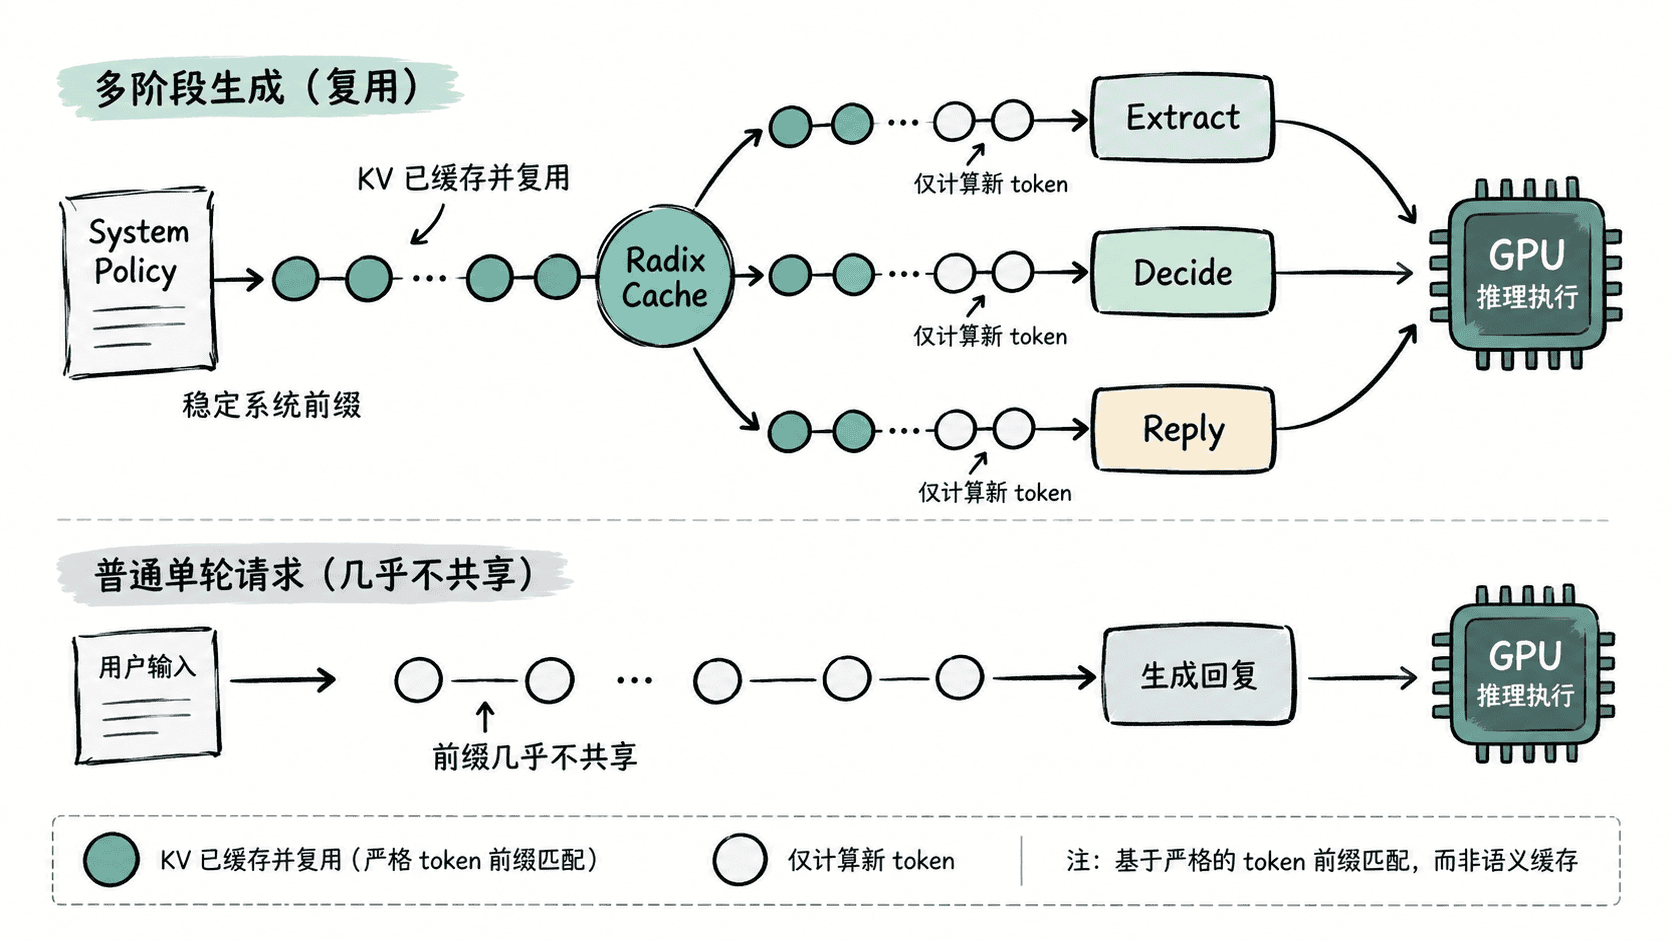
这一节把 SGLang 用在多阶段生成而不是普通单轮聊天:通过稳定前缀让 Radix Cache 复用已计算状态,用 JSON Schema 固化阶段输出,再用同一负载做缓存消融,判断工作流是否真的从前缀复用中获益。
学习目标
- 把多阶段请求组织成便于前缀复用的消息结构
- 用 OpenAI 兼容接口约束 JSON Schema 输出
- 用基准测试区分共享前缀工作流和普通单轮请求的性能特征
把工作流拆成可复用前缀
SGLang 的高性能路径包含 RadixAttention 与前缀缓存。它复用的是相同 token 前缀对应的计算状态,而不是按语义相似度猜测“这两段话差不多”。因此,长系统提示、工具说明和稳定策略应尽量放在消息前部,把每个阶段变化的数据放到后部。([SGLang Documentation][3])
例如一个“抽取 → 判断 → 生成回复”的流程,可以让三条分支都从同一份系统规则开始。第一阶段输出再作为第二阶段的输入;只要前面的消息序列保持一致,后续请求就有机会命中已经存在的前缀节点。
启动 SGLang 服务
先用单卡启动基线服务。SGLang 官方示例使用 python3 -m sglang.launch_server 和 --model-path,并提供 OpenAI 兼容接口;张量并行可通过 --tp 调整。([SGLang Documentation][4])
python3 -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-7B-Instruct \
  --host 0.0.0.0 \
  --port 30000 \
  --tp 1
预期结果:服务进程保持运行并监听 30000 端口;具体初始化日志依赖版本、模型和注意力后端。
SGLang 服务已启动;OpenAI 兼容端点可从 http://127.0.0.1:30000/v1 访问用 JSON Schema 固化阶段输出
结构化工作流最怕第一阶段自由生成一段自然语言,第二阶段再靠正则猜字段。SGLang 的结构化输出支持 JSON Schema、正则和 EBNF;OpenAI 兼容接口可以通过 response_format 提交 JSON Schema。([SGLang Documentation][5])
下面把“工单文本 → 摘要与优先级”做成一个可验证阶段。程序只在响应能被解析、字段类型正确且优先级落在枚举内时输出成功。
import json
import urllib.request

url = "http://127.0.0.1:30000/v1/chat/completions"
schema = {
    "type": "object",
    "properties": {
        "summary": {"type": "string"},
        "priority": {"type": "string", "enum": ["low", "medium", "high"]},
    },
    "required": ["summary", "priority"],
    "additionalProperties": False,
}
payload = {
    "model": "Qwen/Qwen2.5-7B-Instruct",
    "messages": [
        {"role": "system", "content": "你是工单工作流中的结构化抽取器。"},
        {"role": "user", "content": "支付接口连续失败,已有多名用户无法完成订单。"},
    ],
    "temperature": 0,
    "max_tokens": 128,
    "response_format": {
        "type": "json_schema",
        "json_schema": {"name": "ticket_stage", "schema": schema},
    },
}

request = urllib.request.Request(
    url,
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
    method="POST",
)
with urllib.request.urlopen(request) as response:
    data = json.load(response)

stage = json.loads(data["choices"][0]["message"]["content"])
assert isinstance(stage["summary"], str)
assert stage["priority"] in {"low", "medium", "high"}
print("schema_ok=True")
预期输出:
schema_ok=True在真实多阶段流程里,第二阶段只需要把 stage 作为新输入继续调用;稳定的系统策略、工具说明或长上下文仍放在最前面。这样“结构化约束”负责保证阶段边界,而“共享前缀”负责减少重复 prefill,两者解决的是不同问题。
用消融测试判断缓存价值
不要用两组完全不同的提示词直接比较吞吐。更可靠的办法是固定模型、长度、并发和请求数,只改变是否启用 Radix Cache。SGLang 的基准工具提供 generated-shared-prefix 数据集,专门构造“长共享系统前缀 + 短变化问题”的负载。([SGLang Documentation][4])
在默认启用缓存的服务上运行:
python3 -m sglang.bench_serving \
  --backend sglang-oai-chat \
  --base-url http://127.0.0.1:30000 \
  --model Qwen/Qwen2.5-7B-Instruct \
  --dataset-name generated-shared-prefix \
  --gsp-num-groups 8 \
  --gsp-prompts-per-group 8 \
  --gsp-system-prompt-len 1024 \
  --gsp-question-len 64 \
  --gsp-output-len 64 \
  --num-prompts 64 \
  --max-concurrency 16
预期结果:
成功完成 64 个请求,并输出 Request throughput、TTFT、ITL 等服务指标;具体数值随模型、GPU 和软件版本变化。然后停止服务,在原启动参数末尾追加 --disable-radix-cache,重启并原样执行同一条 benchmark。只比较同一环境下两次结果。官方基准示例也使用该开关做缓存关闭场景。([SGLang Documentation][4])
共享前缀越长、分支越多,重复 prefill 的可复用空间通常越大;普通单轮请求如果彼此前缀很少重复,Radix Cache 的收益就会明显缩小。性能差异因此不应写成固定倍数,而应同时看请求吞吐、TTFT 和实际前缀复用程度。
判断什么时候适合 SGLang 工作流
SGLang 特别适合“稳定规则很多、后半段频繁分支”的工作负载,例如工具调用链、长系统提示下的批量任务、同一上下文上的多次决策,以及要求严格 JSON 结构的流水线。结构化输出当前支持 JSON Schema、正则和 EBNF,并默认提供相应语法约束后端。([SGLang Documentation][5])
如果每个请求都是完全独立的短提示,几乎没有共同前缀,那么缓存树能复用的计算本来就少,此时更应该关注基础批处理、模型大小和解码速度。选 SGLang 的关键不是“工作流听起来复杂”,而是请求之间是否真的存在可重复的前缀与明确的结构化边界。