
大模型原理与训练 / 系统课时
建立 TTFT、TPOT 与吞吐基线
建立 TTFT、TPOT 与吞吐基线
这一节把“感觉变快”改成可重复验证的性能基线。你会把一次生成拆成首 Token 等待与持续解码两个阶段,固定输入长度、输出长度和并发度运行 vllm bench serve,并同时记录时延分位数、请求吞吐和 Token 吞吐。
学习目标
- 准确定义 TTFT、TPOT、端到端时延以及请求和 Token 吞吐。
- 在固定输入、输出与并发条件下运行可复现的服务基准测试。
- 用同一组指标判断量化、调度或扩容改动是否真的改善性能。
把指标放到同一条时间轴
一次流式请求从客户端发出到收到第一个输出 Token 的时间是 TTFT,记为 。它主要反映排队、请求处理和 prefill 阶段的综合等待。端到端时延是 ,覆盖从发送请求到最后一个输出 Token 的全部时间。
当输出 Token 数量 时,TPOT 可写成 。它把首 Token 之后的解码时间摊到剩余输出 Token 上,因此更适合观察持续生成速度。输出只有一个 Token 时,不应计算 TPOT。
请求吞吐是测试窗口内成功完成的请求数除以持续时间;输出 Token 吞吐是生成 Token 总数除以持续时间。若工具同时报告 Total token throughput,它通常还把输入 Token 计入,因此跨不同输入长度的实验不能只比较这一项。
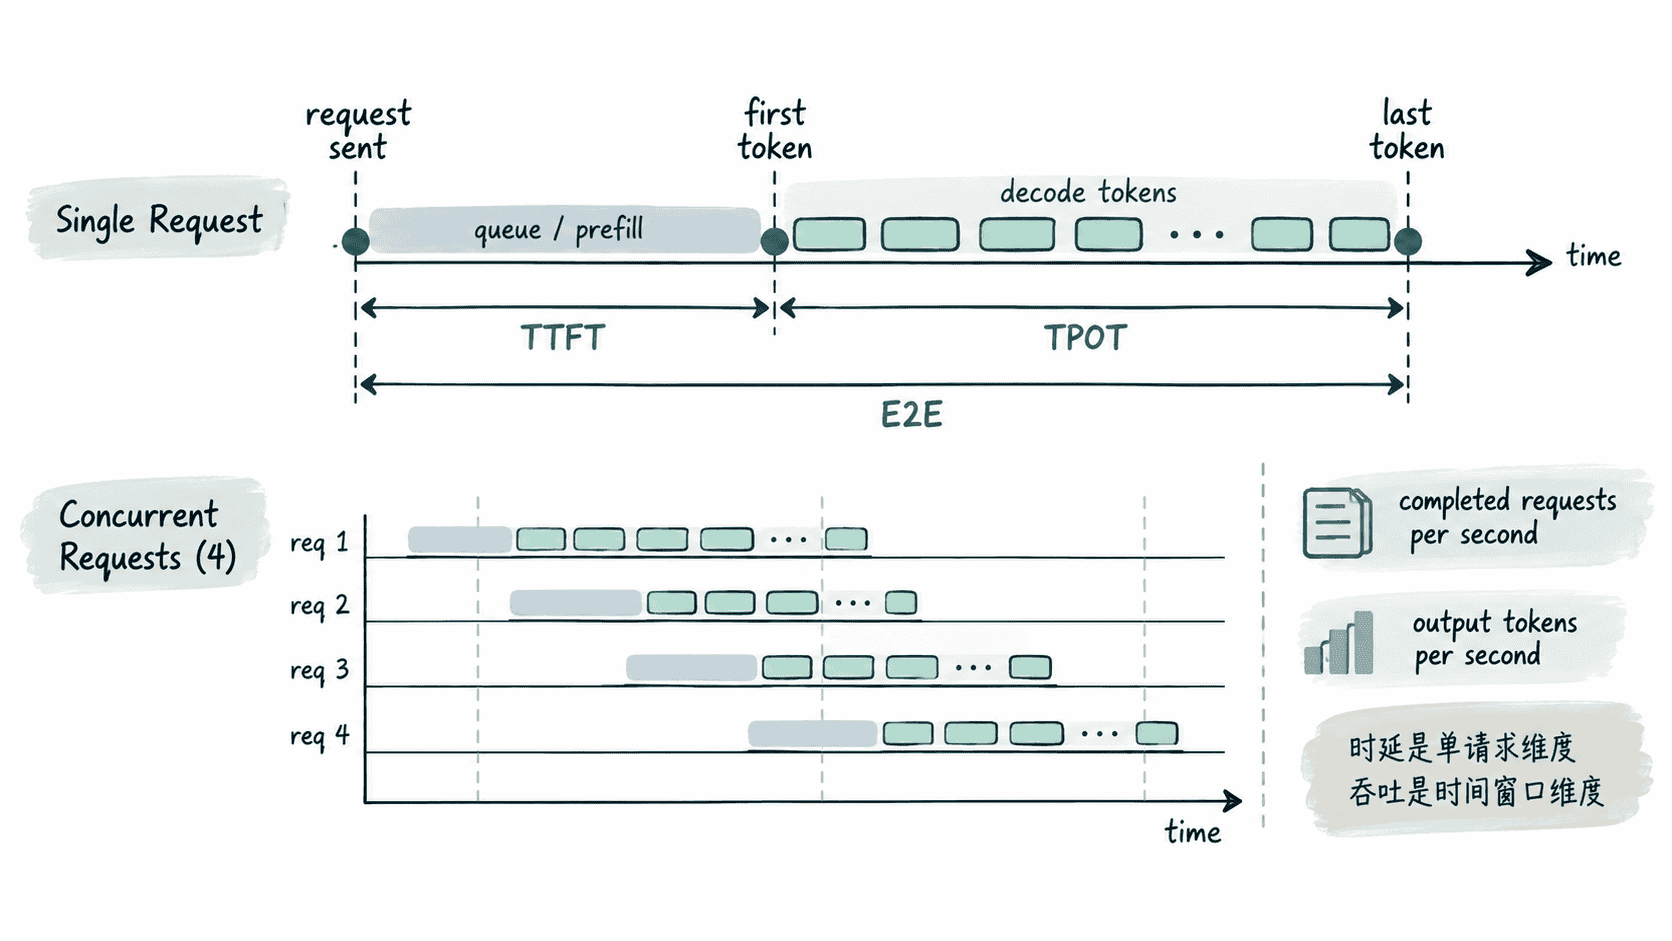
固定可比较的实验条件
性能基线的关键不是追求某个漂亮数字,而是让前后实验只有一个变量发生变化。至少固定模型权重与 dtype、GPU 型号和卡数、vLLM 服务参数、输入与输出 Token 长度、并发度、请求总数、随机种子以及缓存状态。
本节采用一组容易复现的基线:输入 512 Token、输出 128 Token、并发 8、请求 64、随机种子 42。--random-range-ratio 0.0 关闭长度波动,--ignore-eos 防止模型提前遇到 EOS 而缩短输出。比较不同服务配置时,应保持这些参数不变。
运行固定负载基准
如果服务尚未启动,可在第一个终端启动与基线一致的模型。这里继续使用单卡和本机端口,避免网络链路成为额外变量。
vllm serve Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 \
  --port 8000
预期结果
服务进程保持运行,并可通过 http://127.0.0.1:8000/v1/models 访问。在第二个终端运行在线服务基准。--request-rate inf 表示尽快提交负载,--max-concurrency 8 把同时在途请求限制为 8;这样每次测试的并发条件保持一致。
vllm bench serve \
  --backend openai-chat \
  --model Qwen/Qwen2.5-0.5B-Instruct \
  --endpoint /v1/chat/completions \
  --dataset-name random \
  --random-input-len 512 \
  --random-output-len 128 \
  --random-range-ratio 0.0 \
  --ignore-eos \
  --seed 42 \
  --num-prompts 64 \
  --request-rate inf \
  --max-concurrency 8 \
  --percentile-metrics ttft,tpot,e2el \
  --metric-percentiles 50,95,99
预期输出中应至少出现以下指标,具体数值取决于 GPU、驱动、模型和服务参数:
Successful requests: 64
Request throughput (req/s): <REQ_PER_SEC>
Output token throughput (tok/s): <TOK_PER_SEC>
Mean TTFT (ms): <TTFT_MS>
P95 TTFT (ms): <TTFT_P95_MS>
Mean TPOT (ms): <TPOT_MS>
P95 TPOT (ms): <TPOT_P95_MS>
Mean E2EL (ms): <E2E_MS>
P95 E2EL (ms): <E2E_P95_MS><REQ_PER_SEC>、<TOK_PER_SEC> 和各时延值都是动态结果。测试失败时先检查成功请求数,不要把含大量失败请求的高吞吐当成性能提升。
记录基线并判断改动
每次改动至少保留同一组核心证据:TTFT 的 P50/P95/P99、TPOT 的 P50/P95/P99、E2E、请求吞吐、输出 Token 吞吐、成功请求数,以及对应的模型、GPU、并发度、输入输出长度和服务启动参数。单次结果容易受热身和系统抖动影响,正式对比可重复运行多次并比较中位结果。
判断优化是否有效时要同时看延迟和吞吐。例如量化后 Token 吞吐上升,但 P95 TTFT 明显恶化,说明高并发下排队或 prefill 代价可能变差;扩容后请求吞吐提升却单请求 TPOT 不变,则收益主要来自并行容量而不是单流解码速度。只有工作负载和测量口径保持一致,后续每次优化才有可比较证据。