
大模型原理与训练 / 系统课时
用准入控制保护 GPU 队列
用准入控制保护 GPU 队列
GPU 推理服务最怕的不是瞬时繁忙,而是请求在无界队列里越积越多,最终把尾延迟和 KV Cache 一起拖垮。本文用并发槽位、KV 余量和预计排队时间做准入决策,并用小型实验对比无界与有界排队。
学习目标
- 用三个容量信号判断请求应执行、排队还是拒绝
- 设计有界队列与可解释的拒绝原因
- 理解准入控制对尾延迟、成功率和重试行为的权衡
准入控制要看三个信号
只限制并发数不够,因为“还能启动一个请求”并不代表 KV Cache 足够,也不代表队列里的旧请求还能在 SLA 内开始执行。一个实用的 Admission Control 至少同时观察并发槽位、KV Cache 余量和预计排队时间。
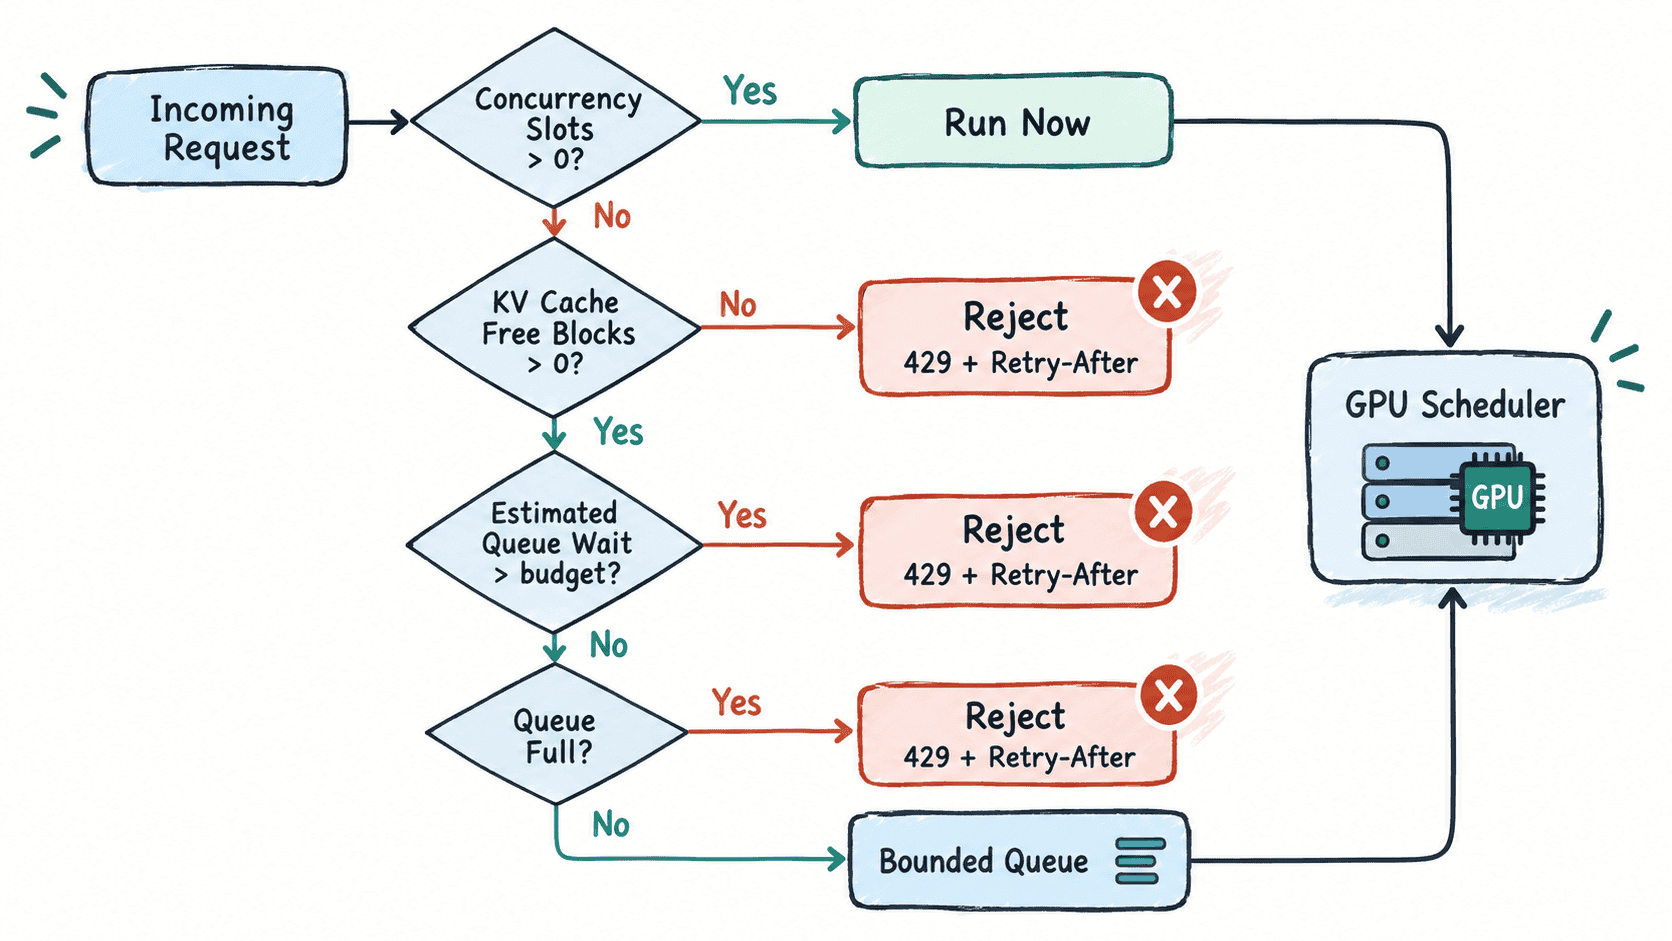
对于 KV Cache,优先使用推理引擎暴露的“空闲 block 数”或“可容纳 token 数”,而不是自己用显存总量粗算。请求需要的容量可以结合 prompt 长度与 max_new_tokens 估计,并额外保留安全水位,防止所有请求同时增长到上限时才发现显存不足。
用有界队列做最小实现
下面的脚本先实现三类拒绝条件,再用 8 个同时到达、2 个执行槽位的突发流量,对比无界队列和最多等待 2 个请求的有界队列。
from dataclasses import dataclass
from math import ceil

@dataclass(frozen=True)
class Limits:
    slots: int = 2
    max_queue: int = 2
    kv_reserve_tokens: int = 2_000
    max_queue_wait_s: float = 1.5

def admit(
    limits: Limits,
    active: int,
    queued: int,
    kv_free_tokens: int,
    requested_kv_tokens: int,
    estimated_wait_s: float,
) -> tuple[bool, str]:
    if kv_free_tokens - requested_kv_tokens < limits.kv_reserve_tokens:
        return False, "kv_cache_low"
    if active < limits.slots:
        return True, "run_now"
    if estimated_wait_s > limits.max_queue_wait_s:
        return False, "queue_wait_too_long"
    if queued >= limits.max_queue:
        return False, "queue_full"
    return True, "queue"

def p95(values: list[float]) -> float:
    index = ceil(0.95 * len(values)) - 1
    return sorted(values)[index]

def burst(total: int, slots: int, max_queue: int | None) -> tuple[float, float]:
    accepted = total if max_queue is None else min(total, slots + max_queue)
    completions = [float(index // slots + 1) for index in range(accepted)]
    return accepted / total, p95(completions)

limits = Limits()

print("kv_low:", admit(
    limits, active=1, queued=0, kv_free_tokens=2_500,
    requested_kv_tokens=1_000, estimated_wait_s=0.1,
))
print("wait_high:", admit(
    limits, active=2, queued=1, kv_free_tokens=10_000,
    requested_kv_tokens=1_000, estimated_wait_s=2.0,
))

unbounded = burst(total=8, slots=2, max_queue=None)
bounded = burst(total=8, slots=2, max_queue=2)

print(f"unbounded: success={unbounded[0]:.0%}, p95={unbounded[1]:.1f}s")
print(f"bounded: success={bounded[0]:.0%}, p95={bounded[1]:.1f}s")
预期输出
kv_low: (False, 'kv_cache_low')
wait_high: (False, 'queue_wait_too_long')
unbounded: success=100%, p95=4.0s
bounded: success=50%, p95=2.0s
这个实验故意把服务时间固定为 1 秒,只展示队列上界对尾延迟的影响。无界队列短期看起来“全接收”,但后半段请求要等到第 4 秒;有界队列牺牲了本次突发中的即时成功率,却把已接纳请求的 p95 控制在 2 秒。
拒绝比偷偷排队更容易治理
容量型拒绝通常应该是明确、快速、可重试的结果。服务仍健康但当前没有容量时,可以返回 429 Too Many Requests,并在能够估计恢复时间时附带 Retry-After;实例本身不可用时再使用 503 Service Unavailable。客户端应采用带抖动的退避,避免所有请求在同一时刻再次冲击队列。
不要把“排队等待超预算”的请求继续留在内部队列,然后让它们最终由客户端超时清理。那会让 GPU 调度器维护大量已经接近失效的工作项,也会放大取消传播和 KV 回收的压力。
阈值要围绕 SLA 调整
max_queue 不是越小越好。过小会在短暂抖动时产生大量拒绝,过大又会把问题转化成尾延迟。更稳妥的做法是同时监控接纳率、拒绝原因分布、队列 p95 等待时间、首 token 延迟和 KV Cache 水位,再逐步调整阈值。
验证时要把成功率分成“首次接纳成功率”和“包含重试后的最终成功率”。准入控制的目标不是追求零拒绝,而是在 GPU 饱和前主动削峰,让已接纳请求保持可预测的延迟,并让被拒绝请求能够在系统恢复容量后有序重试。