
大模型原理与训练 / 系统课时
区分计算、显存与排队瓶颈
区分计算、显存与排队瓶颈
慢请求并不意味着 GPU 算力一定不足。本节把 SM 利用率、HBM 带宽、显存水位、KV Cache 使用率和队列时间放在同一时间窗口分析,用信号组合区分计算、带宽、容量与调度瓶颈,再据此选择验证和优化方向。
学习目标
- 根据多项 GPU 与服务指标区分四类常见性能瓶颈
- 避免仅凭 GPU 利用率或显存占用给出错误结论
- 使用并发爬坡和单变量实验验证初步诊断
先看信号组合,不看单个百分比
SM 利用率反映 GPU 计算单元在采样周期内的活跃程度,但高 SM 利用率不等于已经达到理论 FLOPS。HBM 带宽接近设备可实现峰值时,更可能受到权重、激活或 KV Cache 数据搬运限制,两种指标也可能同时很高。
显存水位与 KV Cache 使用率回答的是容量问题。它们接近上限时,服务可能无法继续接纳更大的批次或更长上下文,并出现 KV Cache 回收、抢占甚至分配失败。队列时间和队列深度则反映请求是否在执行前长期等待。
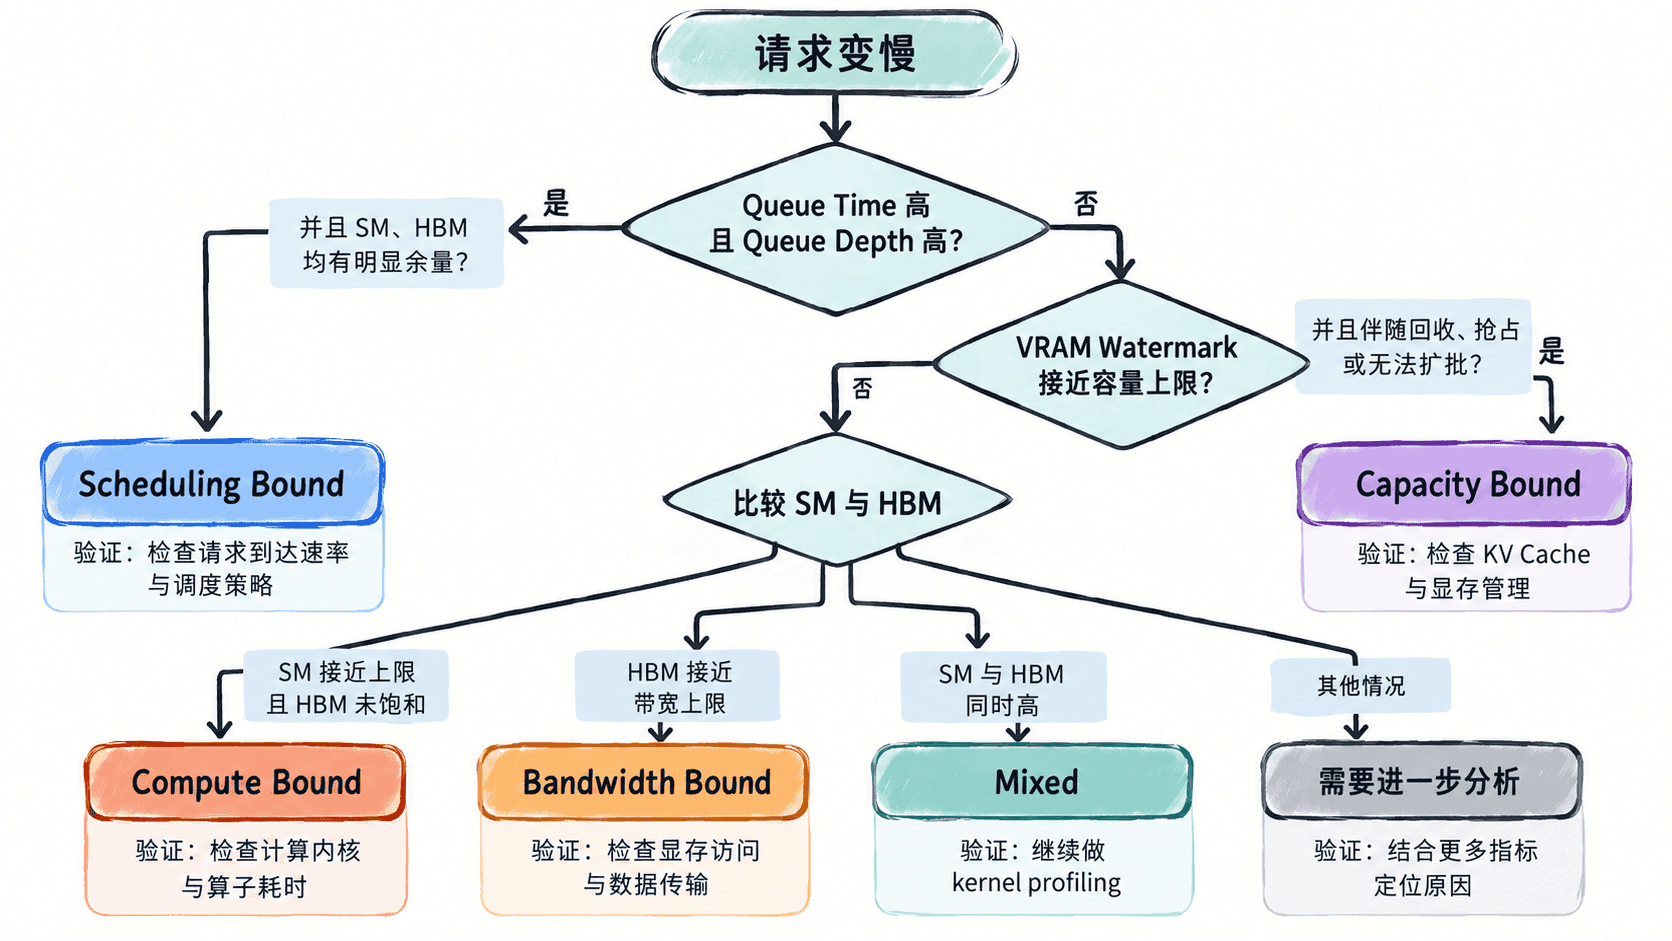
四类瓶颈通常怎样同时出现
| 类型 | 典型信号组合 | 常见负载表现 |
|---|---|---|
| 计算受限 | SM 长时间接近高位,HBM 尚有余量 | 增大并发后吞吐很快进入平台期,计算密集阶段延长 |
| 带宽受限 | HBM 带宽接近平台可实现上限,TPOT 往往更敏感 | 增加批量或并发后数据搬运竞争加剧,Decode 速度下降 |
| 容量受限 | 显存水位或 KV Cache 接近上限,出现回收、抢占或无法继续扩批 | 并发继续增加时队列扩大,甚至发生 OOM 或请求拒绝 |
| 调度受限 | 队列时间很高,但 SM 与 HBM 仍有明显余量 | GPU 间歇空闲,请求却持续等待执行 |
计算受限与带宽受限并不是互斥标签。某些 kernel 可以同时让 SM 和 HBM 保持高负载,此时需要 kernel profiler、算术强度和具体算子耗时进一步判断,不能只凭一条设备监控曲线做最终归因。
用启发式脚本做初筛
下面的脚本把一组人工构造的监控快照进行分类。阈值只是为了演示判别顺序,并不是适用于所有 GPU、模型和推理框架的生产标准;真实系统应依据硬件峰值、历史基线与 SLO 校准阈值。
profiles = [
    {'name': 'compute', 'sm': 96, 'hbm': 58, 'memory': 63, 'kv': 52, 'queue_ms': 80},
    {'name': 'bandwidth', 'sm': 68, 'hbm': 94, 'memory': 71, 'kv': 66, 'queue_ms': 90},
    {'name': 'capacity', 'sm': 62, 'hbm': 73, 'memory': 96, 'kv': 95, 'queue_ms': 420},
    {'name': 'scheduling', 'sm': 44, 'hbm': 51, 'memory': 67, 'kv': 62, 'queue_ms': 780},
]

def classify(metrics):
    # 长时间排队且 GPU 仍有余量时,先检查调度和主机侧路径。
    if metrics['queue_ms'] >= 500 and metrics['sm'] < 70 and metrics['hbm'] < 70:
        return 'scheduling-bound'
    # 容量到顶可能阻止新请求或更大批次进入执行。
    if metrics['memory'] >= 92 or metrics['kv'] >= 92:
        return 'capacity-bound'
    if metrics['hbm'] >= 90:
        return 'bandwidth-bound'
    if metrics['sm'] >= 90:
        return 'compute-bound'
    return 'mixed-or-unclear'

for profile in profiles:
    print(f"{profile['name']} -> {classify(profile)}")
预期输出
compute -> compute-bound
bandwidth -> bandwidth-bound
capacity -> capacity-bound
scheduling -> scheduling-bound
这类规则适合做告警后的第一轮分流,而不适合替代性能分析。尤其是显存占用高但没有 KV 回收、抢占或排队增长时,它可能只是正常地提高了缓存利用率,并不构成容量瓶颈。
按顺序验证,而不是看一个瞬时点
- 固定模型版本、输入长度、输出长度和采样参数,完成预热后逐级提高并发。
- 每个并发档位同时记录吞吐、TTFT、TPOT、端到端时延、队列时间、SM、HBM、显存和 KV Cache。
- 找到 SLO 开始恶化前后,最先接近平台极限或发生突变的指标,而不是只观察故障发生后的最终状态。
- 每次只修改一个变量重复压测,用结果推翻或确认假设。
例如怀疑调度受限时,降低请求到达速率后队列应快速收缩,而 GPU 指标不需要发生明显变化。怀疑容量受限时,缩短最大上下文或降低并发若能显著减少 KV Cache 压力、抢占和排队,则诊断更可信。
修复方向与瓶颈必须对应
计算受限时,优先考虑降低计算量、采用更低精度、优化 kernel 或重新评估并行切分。带宽受限时,应关注权重与 KV Cache 的量化、融合算子、减少内存流量以及更高带宽的设备,而不是单纯提高并发。
容量受限时,可以限制最大上下文和并发、提高 KV Cache 管理效率、使用 KV Cache 量化或增加可用显存。调度受限则应检查连续批处理、Admission Control、批处理参数、CPU 预处理和调度器实现,避免 GPU 有余量却长期喂不满。
最终判断标准不是某个监控百分比是否足够高,而是一次针对根因的改动能否在相同工作负载下改善吞吐或尾延迟,并让对应的瓶颈信号按预期发生变化。