
大模型原理与训练 / 系统课时
用 vLLM 承载通用生成服务
用 vLLM 承载通用生成服务
这一节把 vLLM 配成一个可迭代的默认生成服务:先明确模型、上下文和张量并行参数,再通过 OpenAI 兼容接口验证请求,最后从调度与 KV Cache 的角度判断显存是否留出了足够并发空间。
学习目标
- 用
vllm serve启动可调用的 OpenAI 兼容生成服务 - 理解上下文长度、张量并行度和显存预算对并发的影响
- 用稳定的接口检查模型加载与聊天请求是否正常
建立默认 Serving 基线
vLLM 的 serve 命令直接启动 OpenAI 兼容 HTTP 服务,当前接口覆盖 /v1/chat/completions 等常用路径;--max-model-len 控制单个请求允许使用的提示词加输出总长度,--tensor-parallel-size 控制张量并行规模。([vLLM][1])
先以单卡、8K 上下文作为基线。示例模型可替换为你已经下载并确认兼容的模型。
vllm serve Qwen/Qwen2.5-7B-Instruct \
  --host 0.0.0.0 \
  --port 8000 \
  --max-model-len 8192 \
  --tensor-parallel-size 1 \
  --gpu-memory-utilization 0.90
预期结果:服务进程保持运行并监听 8000 端口。启动日志会随版本和硬件变化,不应把某一条固定日志当作验收条件。
vLLM 服务已启动;HTTP 端点可从 http://127.0.0.1:8000 访问这里显式把 --gpu-memory-utilization 设为 0.90,目的是给运行时和其他 CUDA 分配留一点余量;该参数定义的是当前 vLLM 实例可用于模型执行器的 GPU 显存比例。([vLLM][2])
验证模型与 OpenAI 兼容接口
不要只看“进程没退出”。先查询模型列表,确认 API 层和模型加载都已经可用。
python3 - <<'PY2'
import json
import urllib.request

with urllib.request.urlopen("http://127.0.0.1:8000/v1/models") as response:
    data = json.load(response)

print(data["data"][0]["id"])
PY2
预期输出:
Qwen/Qwen2.5-7B-Instruct再发一个聊天请求,并只验证协议结构而不是模型生成的具体文案。这样测试不会因为采样差异而变得脆弱。
import json
import urllib.request

url = "http://127.0.0.1:8000/v1/chat/completions"
payload = {
    "model": "Qwen/Qwen2.5-7B-Instruct",
    "messages": [{"role": "user", "content": "用一句话解释 KV Cache。"}],
    "temperature": 0,
    "max_tokens": 64,
}

request = urllib.request.Request(
    url,
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
    method="POST",
)

with urllib.request.urlopen(request) as response:
    result = json.load(response)

assert result["model"] == payload["model"]
assert isinstance(result["choices"][0]["message"]["content"], str)
print("chat_ok=True")
预期输出:
chat_ok=True看懂调度与显存行为
通用 Serving 的核心不是“每个请求独占一次前向”,而是调度器持续从等待与运行中的请求里选择序列,把当前迭代可以处理的 token 组织成批次。KV Cache 则保存已经计算过的键值状态,长上下文和更多并发序列都会消耗这部分显存。
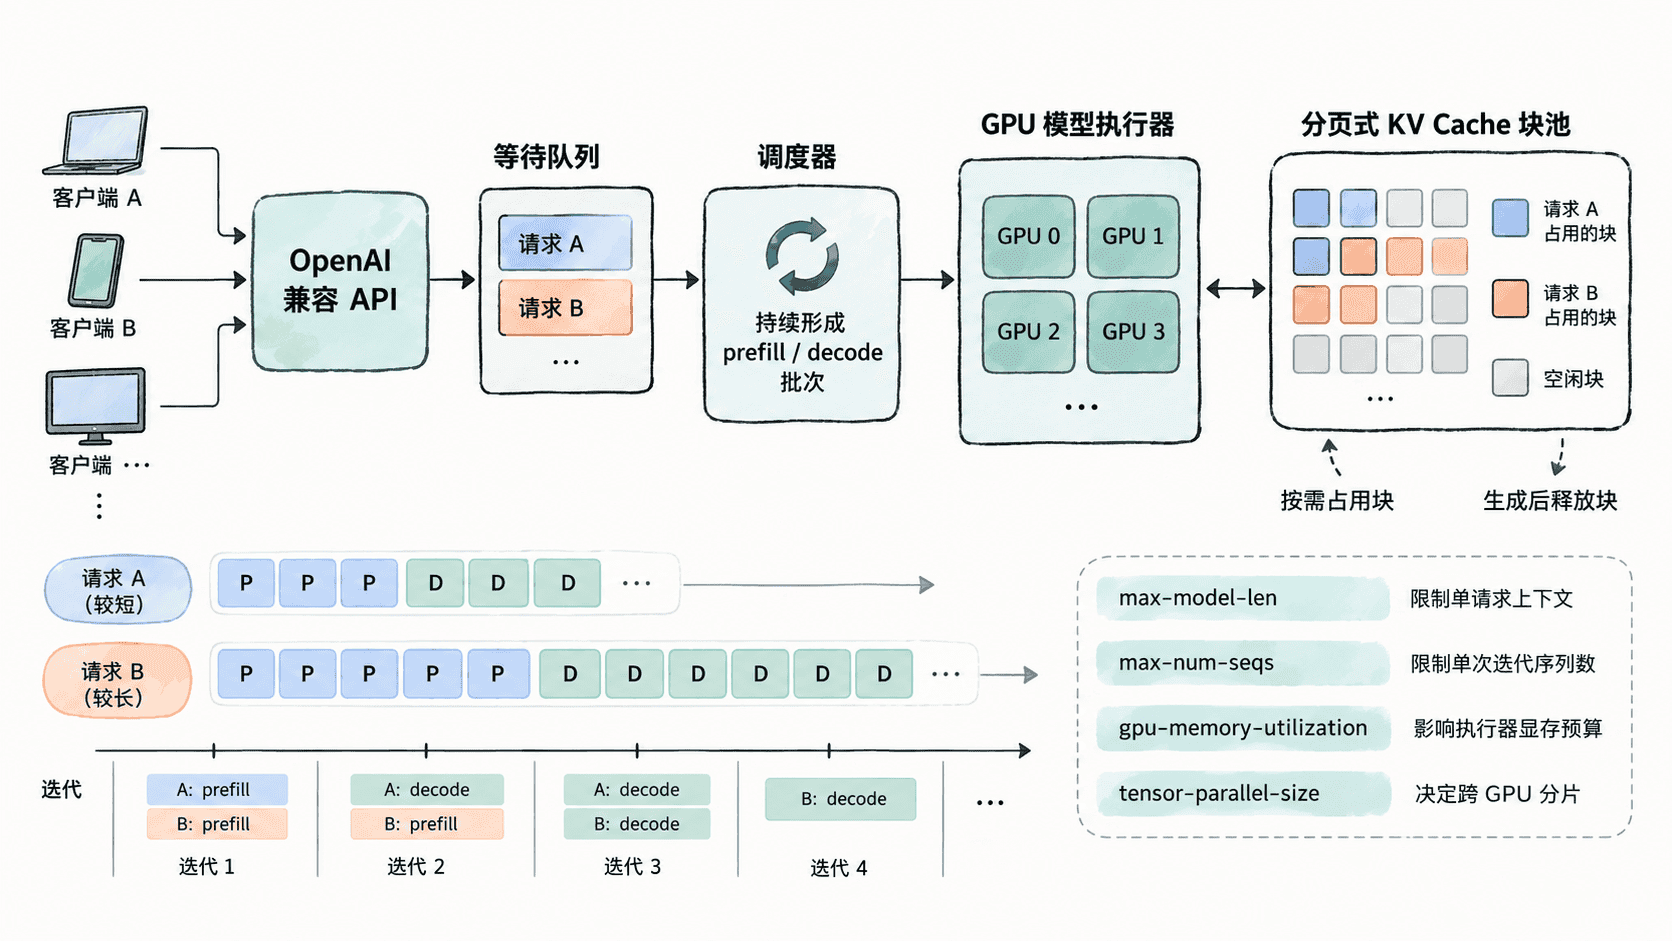
几个参数要分开理解:
| 参数 | 控制什么 | 调大后的主要代价 |
|---|---|---|
--max-model-len |
单请求最大上下文 | 长请求可占用更多 KV Cache,极端情况下压低可并发量 |
--max-num-seqs |
单次迭代最多处理的序列数 | 更高并发需要更多运行时与 KV Cache 空间 |
--gpu-memory-utilization |
当前实例的 GPU 显存预算比例 | 过高会减少其他分配的安全余量 |
--tensor-parallel-size |
一个模型副本跨多少 GPU 做张量并行 | 增加跨卡通信,并要求拓扑与带宽匹配 |
当前 vLLM 把 --max-num-seqs 定义为单次迭代可处理的最大序列数,因此它和 --max-model-len 不是同一个维度:一个管“同时多少条”,一个管“单条最长多少”。([vLLM][2])
选择并行度与默认参数
如果模型能稳定放进单卡,先用 tensor-parallel-size=1 做基线,更容易分辨延迟、吞吐和显存变化来自哪里。只有模型权重放不下、单卡吞吐不足,或已有高速互联的多卡节点时,再提高 TP;TP 能分摊模型计算与部分内存压力,但不会免费消除通信成本。
调整时一次只改一类变量。先固定模型和请求负载,观察单卡 8K;再改变上下文长度;最后再尝试 TP 或并发上限。这样出现 OOM、TTFT 上升或吞吐下降时,能明确是哪一个旋钮造成的。
一个可作为默认 Serving 方案的实例,至少应满足三项验收:模型列表可查询、Chat Completions 请求结构正确、目标并发下没有持续 OOM 或明显排队失控。满足这三项后,再进入量化、批处理上限或多卡优化,才不会把基础配置问题误判成引擎性能问题。