
大模型原理与训练 / 系统课时
构造贴近真实流量的压测集
构造贴近真实流量的压测集
压测结果是否可信,首先取决于输入是否像真实流量。本篇把线上请求压缩为 Prompt 长度、生成长度、到达速率和并发形态,用固定种子与分层抽样构造可复现压测集,避免短提示和恒定并发带来的虚高吞吐。
学习目标
- 从线上请求中提取影响推理负载的四个核心维度。
- 用分层样本和固定随机种子保留长尾请求,同时保证测试可复现。
- 用变化的到达速率与并发上限代替单一恒定并发,构造更接近线上峰谷的回放清单。
先保留联合分布而不是只看平均值
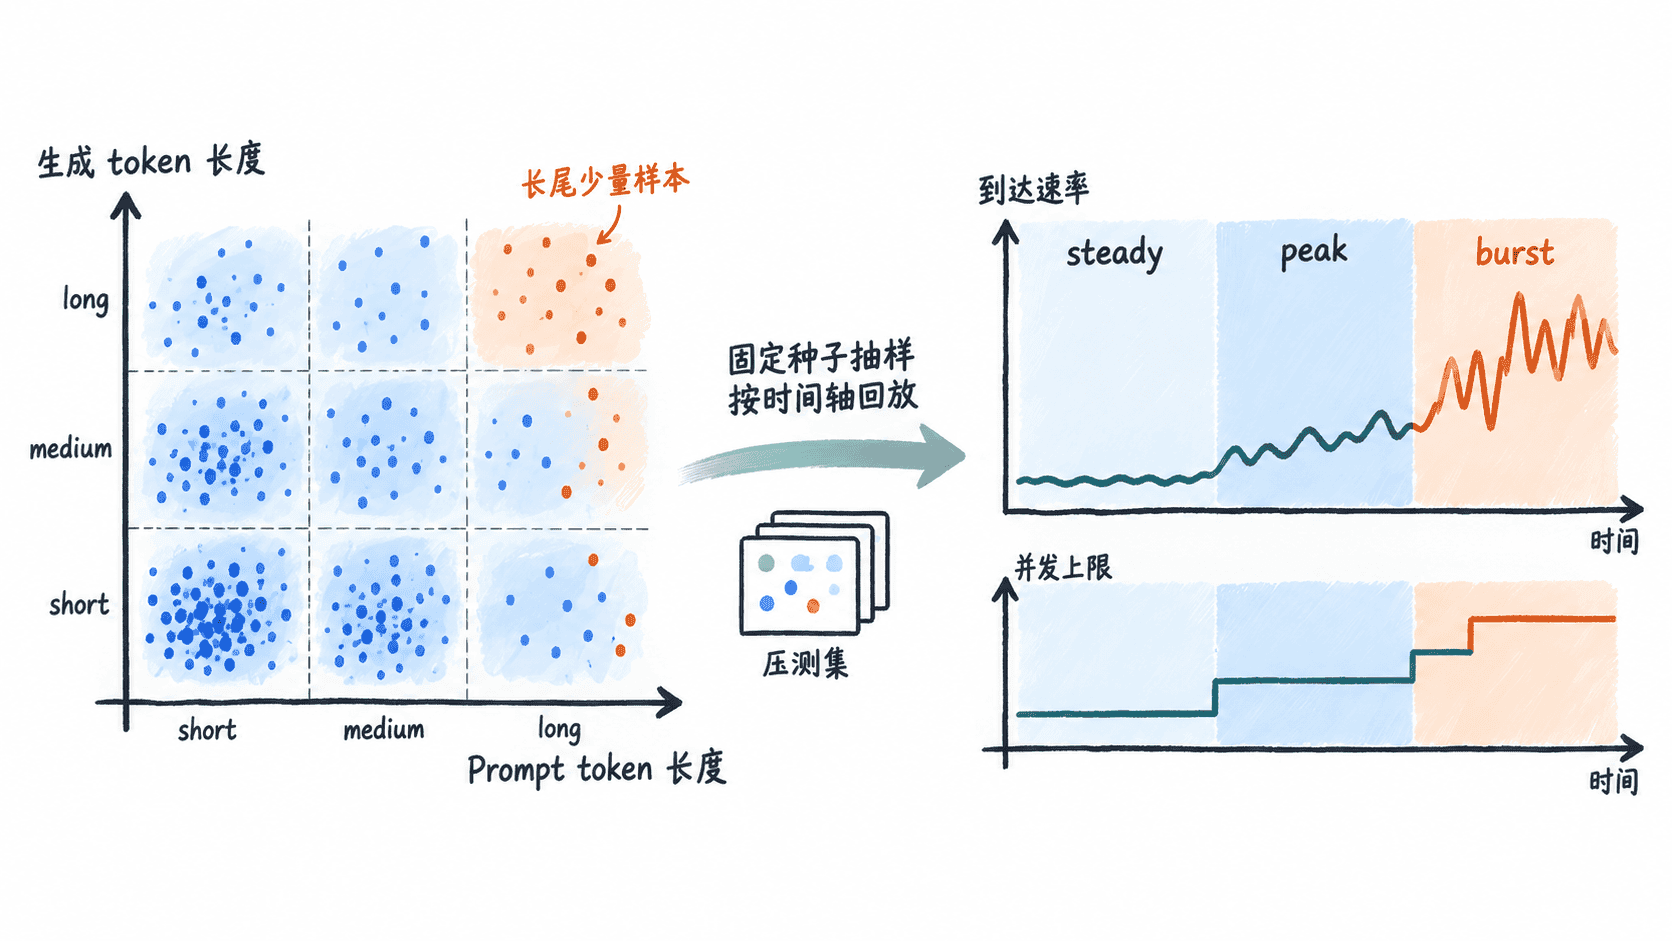
推理负载至少由四个维度共同决定:Prompt token 数影响 Prefill,生成 token 数影响 Decode 持续时间,到达速率决定排队压力,并发分布决定同一时刻有多少请求争用显存与计算资源。只记录平均 Prompt 长度和平均 QPS,会把长尾和突发全部抹平。
尤其要避免把 Prompt 长度和生成长度独立随机化。线上常见“长 Prompt 短回答”和“短 Prompt 长生成”等相关关系,若分别按边际分布抽样,可能合成线上几乎不存在的组合。更稳妥的做法是先按二维区间或业务类型分层,再在层内抽样。
用固定种子生成分层清单
下面的脚本构造 20 条请求元数据:短、中、长三层分别保留 9、8、3 条,随后用固定种子打乱顺序。流量阶段从 steady 过渡到 peak 和 burst,每个阶段使用不同的泊松到达速率与并发上限,最终写出可供压测客户端消费的 JSONL 清单。
from collections import Counter
from pathlib import Path
import json
import random
import statistics

rng = random.Random(2026)
strata = [
    ("short", (32, 256), (32, 128), 9),
    ("medium", (257, 2048), (129, 512), 8),
    ("long", (2049, 8192), (513, 1536), 3),
]

samples = []
for name, prompt_range, gen_range, count in strata:
    for _ in range(count):
        samples.append(
            {
                "stratum": name,
                "prompt_tokens": rng.randint(*prompt_range),
                "max_new_tokens": rng.randint(*gen_range),
            }
        )
rng.shuffle(samples)

phases = [
    ("steady", 8, 4.0, 8),
    ("peak", 8, 8.0, 16),
    ("burst", 4, 12.0, 24),
]
timeline = []
for phase, count, qps, cap in phases:
    timeline.extend([(phase, qps, cap)] * count)

records = []
elapsed = 0.0
for i, (sample, (phase, qps, cap)) in enumerate(zip(samples, timeline), 1):
    elapsed += rng.expovariate(qps)
    records.append(
        {
            "id": f"req-{i:03d}",
            **sample,
            "phase": phase,
            "arrival_s": round(elapsed, 3),
            "concurrency_cap": cap,
        }
    )

path = Path("bench_manifest.jsonl")
path.write_text(
    "\n".join(json.dumps(r, ensure_ascii=False) for r in records) + "\n",
    encoding="utf-8",
)

counts = Counter(r["stratum"] for r in records)
print(f"count={len(records)} strata={dict(counts)}")
print(
    "mean_prompt=%.1f mean_generation=%.1f"
    % (
        statistics.mean(r["prompt_tokens"] for r in records),
        statistics.mean(r["max_new_tokens"] for r in records),
    )
)
print("first5_arrivals=" + ",".join(f"{r['arrival_s']:.3f}" for r in records[:5]))
print(f"saved={path}")
预期输出
count=20 strata={'medium': 8, 'short': 9, 'long': 3}
mean_prompt=1237.4 mean_generation=308.9
first5_arrivals=0.505,0.643,1.049,1.553,2.074
saved=bench_manifest.jsonl
固定种子保证同一脚本重复执行时得到相同样本和到达时间。实际项目中,区间和比例应来自脱敏后的线上统计,而不是照搬示例数值;token 长度也应使用目标模型对应的 tokenizer 统计,而不是字符数。
到达速率和并发要分别看
恒定并发属于闭环压测:只有前一个请求结束,客户端才补下一个请求。这种方式适合测系统在给定并发下的饱和能力,却会隐藏真实流量中的突发到达。开放式回放则按时间戳发请求,即使前面的请求尚未完成,新请求仍会到达,更适合观察排队、首 token 延迟和过载行为。
并发上限仍有价值,但它更像保护条件,而不是唯一的流量模型。测试集中同时保存 arrival_s 与 concurrency_cap,可以让客户端既还原到达节奏,又避免压测器自身无限堆积请求。
用分层校验避免漂亮但错误的结果
生成清单后先做静态校验:样本总量是否正确、各层比例是否符合目标、长尾是否真的存在、相同随机种子能否复现。随后再把请求送入服务,记录 TTFT、TPOT、端到端延迟、吞吐和错误率,并按短、中、长层分别统计,避免总体平均值掩盖长请求退化。
一个可信的压测集不是“请求越多越真实”,而是能稳定复现线上最重要的负载结构。只要长度分布、到达节奏、并发峰值和长尾样本都被保留下来,后续性能结论才有资格用于容量规划和优化决策。