
大模型原理与训练 / 系统课时
用模型路由承接多规格请求
用模型路由承接多规格请求
同一个推理入口常同时承接长上下文、高优先级和低成本批任务。本篇把路由规则拆成可执行条件,并用回退与熔断处理实例池异常,使请求在质量、容量和成本之间得到可解释的去向。
学习目标
- 根据模型版本、上下文长度、优先级和成本预算筛选实例池。
- 区分正常路由、模型回退与熔断转移,避免静默降级。
- 用可重复的测试请求验证路由策略的关键边界。
把路由问题变成约束筛选
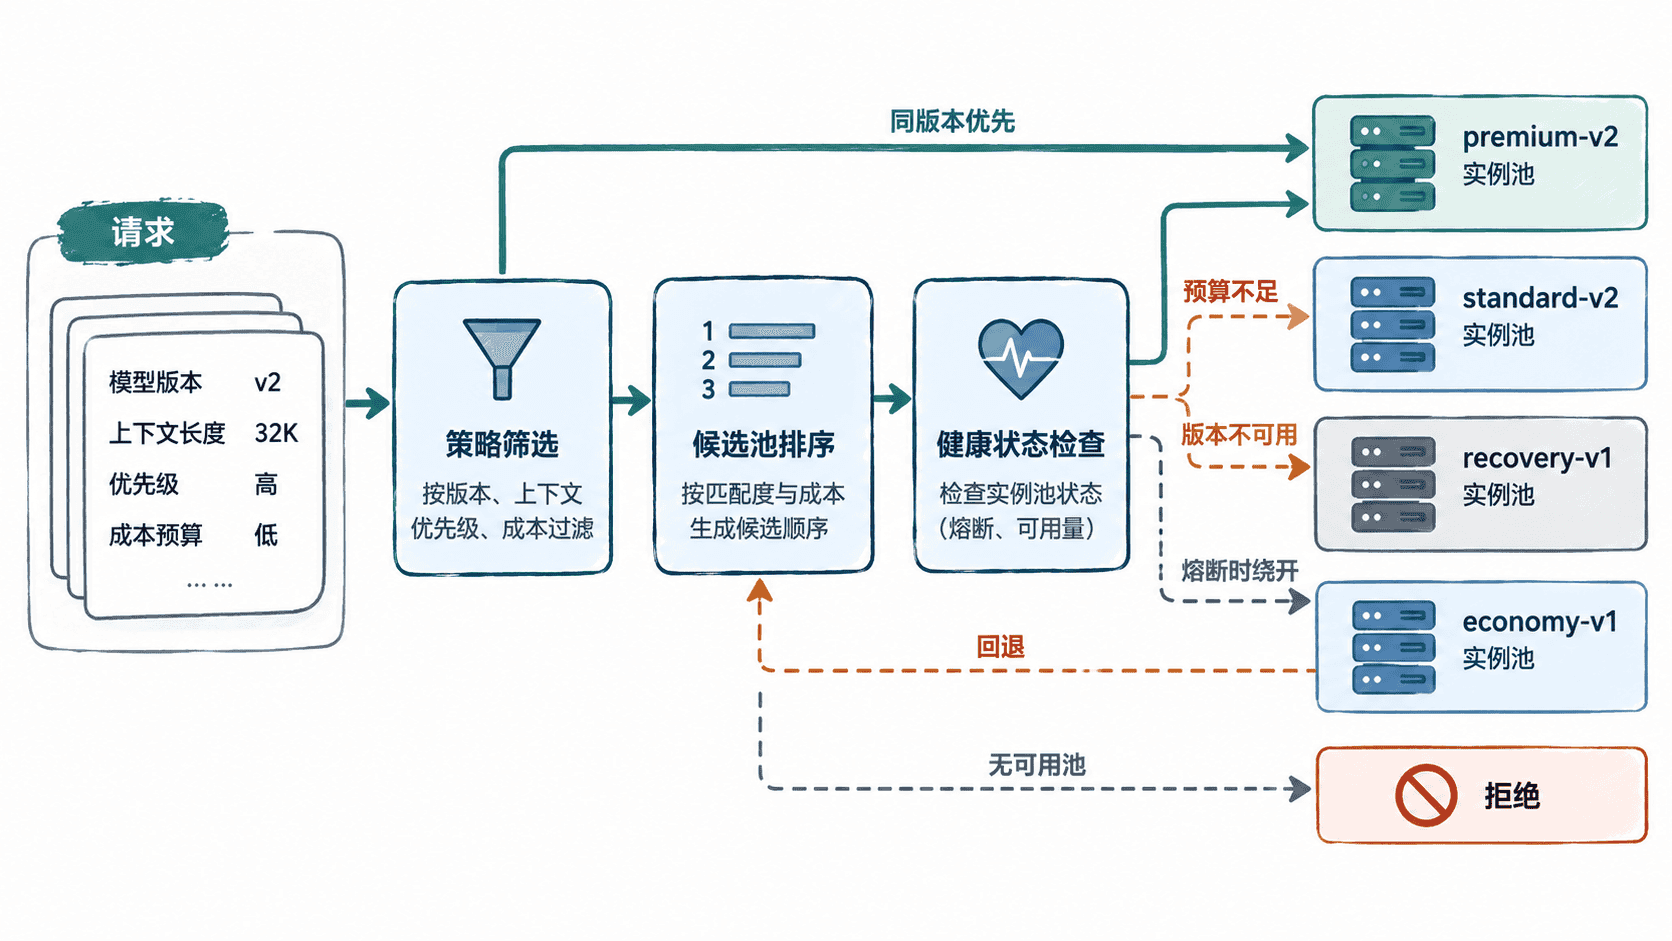
路由器不应只做“随机挑一台机器”。它首先读取请求元数据,再把请求与实例池能力逐项匹配。最少要显式建模四类约束:首选模型版本、prompt_tokens + max_new_tokens 的上下文需求、请求优先级,以及租户允许的成本等级。
实例池也要暴露可比较的能力,例如模型版本、最大上下文、成本等级、允许的优先级和健康状态。这样路由结果才能解释为“满足哪些条件后被选中”,而不是散落在多个 if 分支里的隐含规则。
| 维度 | 请求侧含义 | 实例池侧能力 |
|---|---|---|
| 模型版本 | 首选版本与是否允许回退 | 当前加载的模型版本 |
| 上下文长度 | Prompt 与最大生成长度之和 | 可承载的最大 token 数 |
| 优先级 | high、normal、low 等服务等级 |
接受哪些优先级 |
| 成本 | 租户可接受的成本上限 | 单次路由的成本等级 |
| 健康状态 | 不直接指定 | 是否可接流量 |
用一个确定性策略实现路由
下面的示例先筛掉上下文、优先级、成本和健康状态不满足的池,再优先选择首选模型;只有请求允许回退且同版本池不可用时,才考虑其他模型。示例中的 healthy 用来模拟熔断器对实例池可用性的判断。
from dataclasses import dataclass
from typing import FrozenSet

@dataclass(frozen=True)
class Pool:
    name: str
    model: str
    max_context: int
    unit_cost: int
    priorities: FrozenSet[str]
    healthy: bool = True

@dataclass(frozen=True)
class Request:
    request_id: str
    preferred_model: str
    prompt_tokens: int
    max_new_tokens: int
    priority: str
    max_unit_cost: int
    allow_fallback: bool

def route(req: Request, pools: list[Pool]) -> str:
    total_tokens = req.prompt_tokens + req.max_new_tokens

    def usable(pool: Pool) -> bool:
        return (
            pool.healthy
            and total_tokens <= pool.max_context
            and req.priority in pool.priorities
            and pool.unit_cost <= req.max_unit_cost
        )

    exact = [p for p in pools if usable(p) and p.model == req.preferred_model]
    if exact:
        return min(exact, key=lambda p: (p.unit_cost, p.max_context)).name

    if req.allow_fallback:
        fallback = [p for p in pools if usable(p)]
        if fallback:
            return min(fallback, key=lambda p: (p.unit_cost, p.max_context)).name

    return "NO_ROUTE"

pools = [
    Pool("premium-v2", "v2", 131072, 3, frozenset({"high", "normal"})),
    Pool("standard-v2", "v2", 32768, 2, frozenset({"high", "normal", "low"})),
    Pool("recovery-v1", "v1", 65536, 2, frozenset({"high", "normal"})),
    Pool("economy-v1", "v1", 32768, 1, frozenset({"normal", "low"})),
]

requests = [
    Request("req-high", "v2", 60000, 4000, "high", 3, True),
    Request("req-batch", "v2", 9000, 1000, "low", 1, True),
]

for req in requests:
    print(f"{req.request_id} -> {route(req, pools)}")

# 模拟 premium-v2 被熔断后,长上下文高优请求走恢复池。
pools[0] = Pool(
    "premium-v2", "v2", 131072, 3, frozenset({"high", "normal"}), healthy=False
)
retry = Request("req-fallback", "v2", 60000, 4000, "high", 3, True)
print(f"{retry.request_id} -> {route(retry, pools)}")
预期输出
req-high -> premium-v2
req-batch -> economy-v1
req-fallback -> recovery-v1
第一条请求只有长上下文池能承接,因此进入 premium-v2;第二条受成本上限约束,只能回退到低成本 economy-v1;第三条在首选长上下文池被熔断后进入 recovery-v1。
把回退与熔断设计成显式状态
回退解决“没有合适的首选池”,例如预算不足、首选版本无容量或长上下文池已满。回退到旧模型时,响应中应记录实际服务模型和降级标记,调用方才能知道质量语义发生了变化。对明确要求固定模型版本的请求,应设置 allow_fallback=false,宁可返回不可服务,也不要静默换模型。
熔断解决“某个池暂时不可信”。生产环境通常根据连续错误、超时比例或健康检查维护关闭、打开和半开状态,而不是某次失败后永久摘除。路由器只消费熔断状态;状态统计应由独立的健康与故障策略负责。
验证真正会出错的边界
上线前至少覆盖四类请求:恰好达到上下文上限、超过上限一个 token、预算低于所有候选池、首选池熔断且回退池可用。还要检查高优请求不会被低成本批任务挤占保留容量,并确认无可用池时返回明确的不可路由结果,而不是无限重试。
模型路由的核心不是“多写几个分支”,而是把请求约束、实例能力、健康状态和降级语义都变成可观察的数据。只有路由结果可解释、回退可追踪、熔断可恢复,多规格请求才适合共享同一个服务入口。