
大模型原理与训练 / 系统课时
为 MoE 模型配置专家并行
为 MoE 模型配置专家并行
MoE 推理的难点不是把专家权重平均切到多张卡,而是让路由后的 Token 在正确的 GPU 间高效交换。本节用 4 卡 vLLM 服务说明 Expert Parallel 的配置方式,并给出专家负载、All-to-All 压力和拓扑错配的判断方法。
学习目标
- 解释稀疏激活为什么会把计算压力转化为 All-to-All 通信压力
- 为 MoE Serving 配置 Expert Parallel,并验证服务能够正常加载
- 根据专家负载与链路指标识别热点专家和并行拓扑不匹配
从稀疏激活推导并行目标
MoE 层通常包含多个专家,但每个 Token 只由 Router 选择其中少数几个专家执行。例如共有 64 个专家、每个 Token 选择 2 个专家时,计算是稀疏的;真正的部署问题是这 2 个专家可能位于其他 GPU 上,因此需要先把 Token 激活发送到目标专家,再把专家输出送回原来的计算路径。
Expert Parallel 的核心做法是让不同 Rank 持有不同专家。与把同一个矩阵切片到多卡的 Tensor Parallel 不同,EP 的通信模式更接近“按路由结果重新分发 Token”。因此一次 MoE 层往往包含 Dispatch All-to-All、专家计算和 Combine All-to-All 三段,路由越不均衡,越容易出现部分 GPU 忙、部分 GPU 等待的情况。
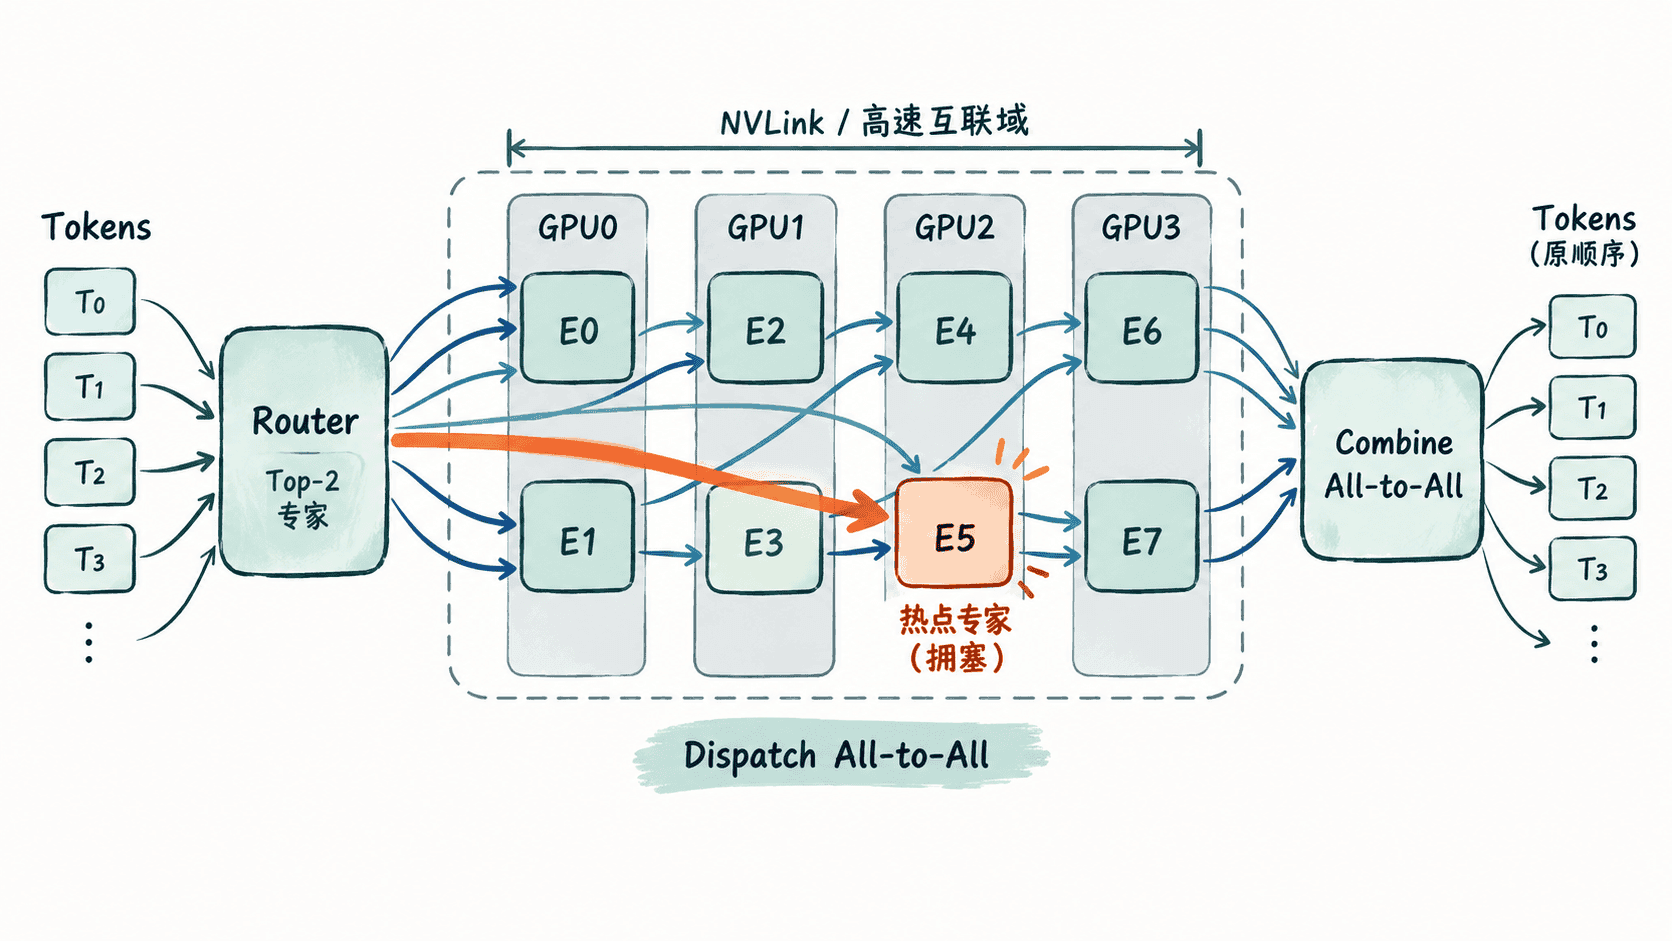
EP 并不会自动消除负载不均。它只改变专家权重的放置和 Token 的交换方式;如果 Router 长期把大量 Token 送往少数专家,或者 EP Rank 被跨越低速 PCIe、NUMA 甚至普通以太网放置,延迟仍可能显著恶化。
配置一个最小 Expert Parallel 服务
下面以单机 4 GPU、vLLM OpenAI 兼容服务为例。前提是 <MODEL_PATH> 指向一个受当前 vLLM 版本支持的 MoE 模型,4 张 GPU 都可见且显存足以装下该模型。--enable-expert-parallel 让 MoE 专家使用 EP;--tensor-parallel-size 4 定义参与该并行组的 4 个 Rank,非 MoE 层仍按引擎支持的方式参与模型并行。
export CUDA_VISIBLE_DEVICES=0,1,2,3

vllm serve <MODEL_PATH> \
  --served-model-name moe-ep \
  --tensor-parallel-size 4 \
  --enable-expert-parallel \
  --host 0.0.0.0 \
  --port <PORT>
预期结果
服务进程保持运行并监听 <PORT>;模型对外名称为 moe-ep,启动过程中没有模型加载失败、CUDA OOM 或分布式通信初始化错误。<MODEL_PATH> 和 <PORT> 需要替换为实际值。若模型并不是 MoE,或者当前引擎版本不支持该模型的 EP 实现,不应仅靠添加开关强行启用;先确认模型架构和 Serving 引擎的支持范围。
用负载和链路指标判断是否真的受益
观察 EP 不能只看平均 GPU 利用率。至少要同时收集每个专家在固定时间窗口内接收的 Token 数、All-to-All 耗时或传输字节、每张 GPU 的计算利用率,以及 NVLink、NVSwitch、InfiniBand 或 RoCE 等实际数据通路的利用率。框架没有导出 per-expert 计数时,应通过其 Router/EPLB 诊断能力或离线压测埋点补齐,而不是用单个 GPU 利用率猜测专家是否均衡。
一个简单的负载不均衡指标是 。当 持续升高,同时部分 GPU 忙而其他 GPU 等待,通常说明存在热点专家;如果专家负载已经比较均衡,但 All-to-All 时间占比明显升高,更应检查专家是否被分布到了跨 NUMA、跨 PCIe 根节点或跨慢速网络的 Rank 上。
| 观测现象 | 更可能的原因 | 优先检查 |
|---|---|---|
| 少数专家 Token 数长期偏高 | Router 偏置或请求分布集中 | per-expert Token 计数、负载均衡策略 |
| 各专家负载接近但通信时间高 | EP Rank 拓扑不合理 | NVLink/NVSwitch 域、NUMA、跨机链路 |
| GPU 利用率呈一高一低交替 | All-to-All 等待或批次不均 | 通信时间线、批大小、专家放置 |
| 吞吐提升但 P95 延迟恶化 | 大批次掩盖了通信尾延迟 | P50/P95、单请求 Token 路径 |
修复热点专家与拓扑错配
热点专家首先是路由问题,不是简单增加 GPU 就能解决。若 Serving 框架提供 Expert Parallel Load Balancing 或冗余专家能力,可以在稳定压测流量下启用并观察专家迁移前后的负载差异;如果没有,应优先调整请求混合、批处理策略或专家副本方案,而不是盲目扩大 EP 组。
拓扑问题则应从“高频通信留在最快互联域”出发。单机优先让 EP Rank 位于同一 NVLink/NVSwitch 域;多机必须跨节点时,应确保节点间使用预期的高速网络,并通过 NCCL 或网络监控确认数据没有意外回落到低速接口。最终验收不是“开关已经打开”,而是在同一请求集和批量配置下,专家负载没有持续热点、All-to-All 没有成为新的主瓶颈,并且吞吐与尾延迟都符合服务目标。