
大模型原理与训练 / 系统课时
用流水并行跨卡切分层级
用流水并行跨卡切分层级
当单卡放不下完整模型时,可以按 Transformer 层把模型切成多个阶段,让请求依次跨 GPU 流动。本篇重点不是“把层平均分掉”,而是用微批、气泡和阶段耗时判断流水并行是否真正缓解显存压力,还是把在线推理时延放大。
学习目标
- 解释 Pipeline Parallel 的阶段、微批与流水气泡如何形成。
- 根据实测阶段耗时判断切层是否均衡,并估算微批对利用率的影响。
- 判断流水并行适合解决的显存问题,以及在线低并发场景中的时延代价。
流水并行怎样切开模型
设模型有 32 个 Transformer 层,可以把连续层划成 4 个阶段,分别放到 4 张 GPU。阶段只保存自己负责的权重与这些层对应的运行时状态;前一阶段计算出的激活通过互联传给下一阶段,因此单卡权重显存下降,但请求必须按阶段顺序前进。
单个微批从 Stage 0 走到 Stage 3 时,各阶段尚不能一直满载。只有连续送入多个微批,后面的阶段在处理较早微批时,前面的阶段才能并行处理新的微批。流水首尾没有工作可做的空槽就是气泡。
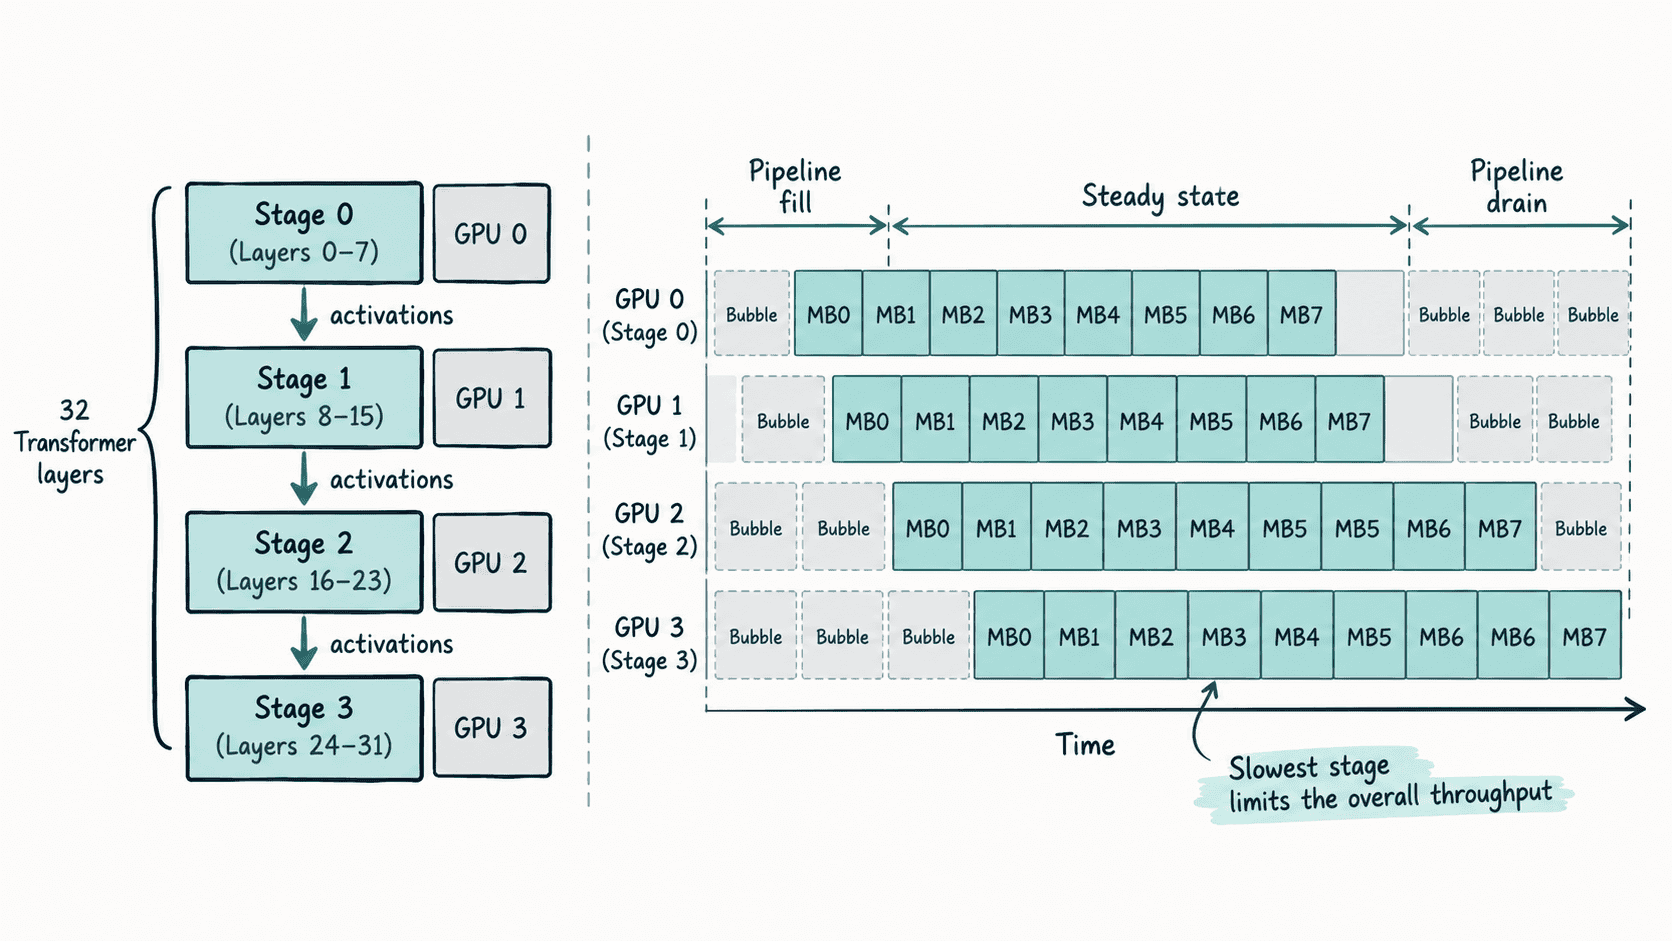
用微批换取阶段重叠
若有 个耗时近似相同的阶段、一次流水处理 个微批,简单 fill-drain 调度下的气泡占比可近似看成 。增加微批能摊薄填充和排空气泡,但会让一个请求被拆得更细,增加调度、跨卡传输与排队成本;在线服务还要面对不同请求长度导致的微批不整齐。
下面的可执行脚本用实测的“每个微批阶段耗时”估算一次流水批次。示例假设阶段耗时已经把相邻阶段的数据传输折算进去,因此它适合做容量规划,不代表具体推理框架的调度器实现。
stage_ms = [5.8, 6.2, 6.0, 5.9]
microbatches = 8

p = len(stage_ms)
fill_latency = sum(stage_ms)
bottleneck = max(stage_ms)
# fill-drain 近似:首个微批走完整条流水,之后每个微批受最慢阶段限制。
pipeline_makespan = fill_latency + (microbatches - 1) * bottleneck
sequential_makespan = microbatches * fill_latency
bubble_ratio = (p - 1) / (microbatches + p - 1)

print(f"stages={p}, microbatches={microbatches}")
print(f"fill_latency={fill_latency:.1f} ms")
print(f"pipeline_makespan={pipeline_makespan:.1f} ms")
print(f"idealized_speedup={sequential_makespan / pipeline_makespan:.2f}x")
print(f"bubble_ratio={bubble_ratio:.1%}")
预期输出:
stages=4, microbatches=8
fill_latency=23.9 ms
pipeline_makespan=67.3 ms
idealized_speedup=2.84x
bubble_ratio=27.3%
这里的 27.3% 是由阶段数和微批数得到的结构性气泡估算;真实利用率还会受通信、同步、动态批处理、Prefill/Decode 比例和请求长度分布影响。
阶段平衡比平均分层更重要
不要直接按“每卡 8 层”判定均衡。Embedding、输出头、不同层实现、KV Cache 访问和跨卡通信都会让阶段耗时不同。流水节拍最终由最慢阶段决定:其他阶段即使显存还有余量,也会等待瓶颈阶段。
实际切分时,应先用代表性输入测量每个候选阶段的 Prefill 与 Decode 耗时,再移动层边界,使最慢阶段尽量接近其余阶段。还要同时检查显存峰值,因为把更多层移到较快 GPU 可能解决计算不平衡,却让该阶段在长上下文下先触发 OOM。
什么时候值得使用流水并行
流水并行最直接的价值是把权重和分层状态拆到多卡:当模型无法在单卡容纳,而机器又具备足够快的 GPU 互联时,它能让模型先跑起来,并通过多请求或多微批提高吞吐。对于长上下文、大权重模型,这往往比单纯压缩批次更可控。
它并不天然降低单请求时延。低并发时没有足够微批填满流水,阶段越多,首 token 前必须经过的串行阶段和跨卡传输越多;自回归 Decode 每一步计算粒度又很小,通信比例会进一步上升。如果目标是极低延迟且模型能由较少 GPU 通过张量并行容纳,流水并行通常不是第一选择。
最终应把 Pipeline Parallel 看成“容量约束下的结构性切分”:先确认它解决了单卡显存瓶颈,再用代表性流量验证阶段利用率、TTFT、TPOT 与吞吐。如果只能靠不断增加微批才能跑满,而业务延迟预算无法接受这些等待,那么切得更多阶段只会把显存问题换成时延问题。