
大模型原理与训练 / 系统课时
用 Transformers 跑通生成
用 Transformers 跑通生成
环境自检通过后,需要把模型加载、分词、GPU 放置、生成和性能记录串成一条可复现链路。本节用一个小型因果语言模型完成单卡生成,并同时记录 dtype、耗时、token 数与峰值显存,形成第一份推理基线。
学习目标
- 使用 Transformers 加载分词器和因果语言模型并放到单张 GPU
- 正确控制 dtype、
device_map与核心生成参数 - 记录生成耗时、token 数、吞吐和峰值显存作为性能基线
固定单卡生成的数据路径
一次最小生成会经历提示词、Tokenizer、输入 token、GPU 上的因果语言模型、自回归生成以及 Decoder 解码几个阶段。模型加载时的 dtype 直接影响权重显存,device_map 决定权重放在哪里,而 max_new_tokens、是否采样和 KV Cache 等生成设置又会影响运行时间与显存峰值。
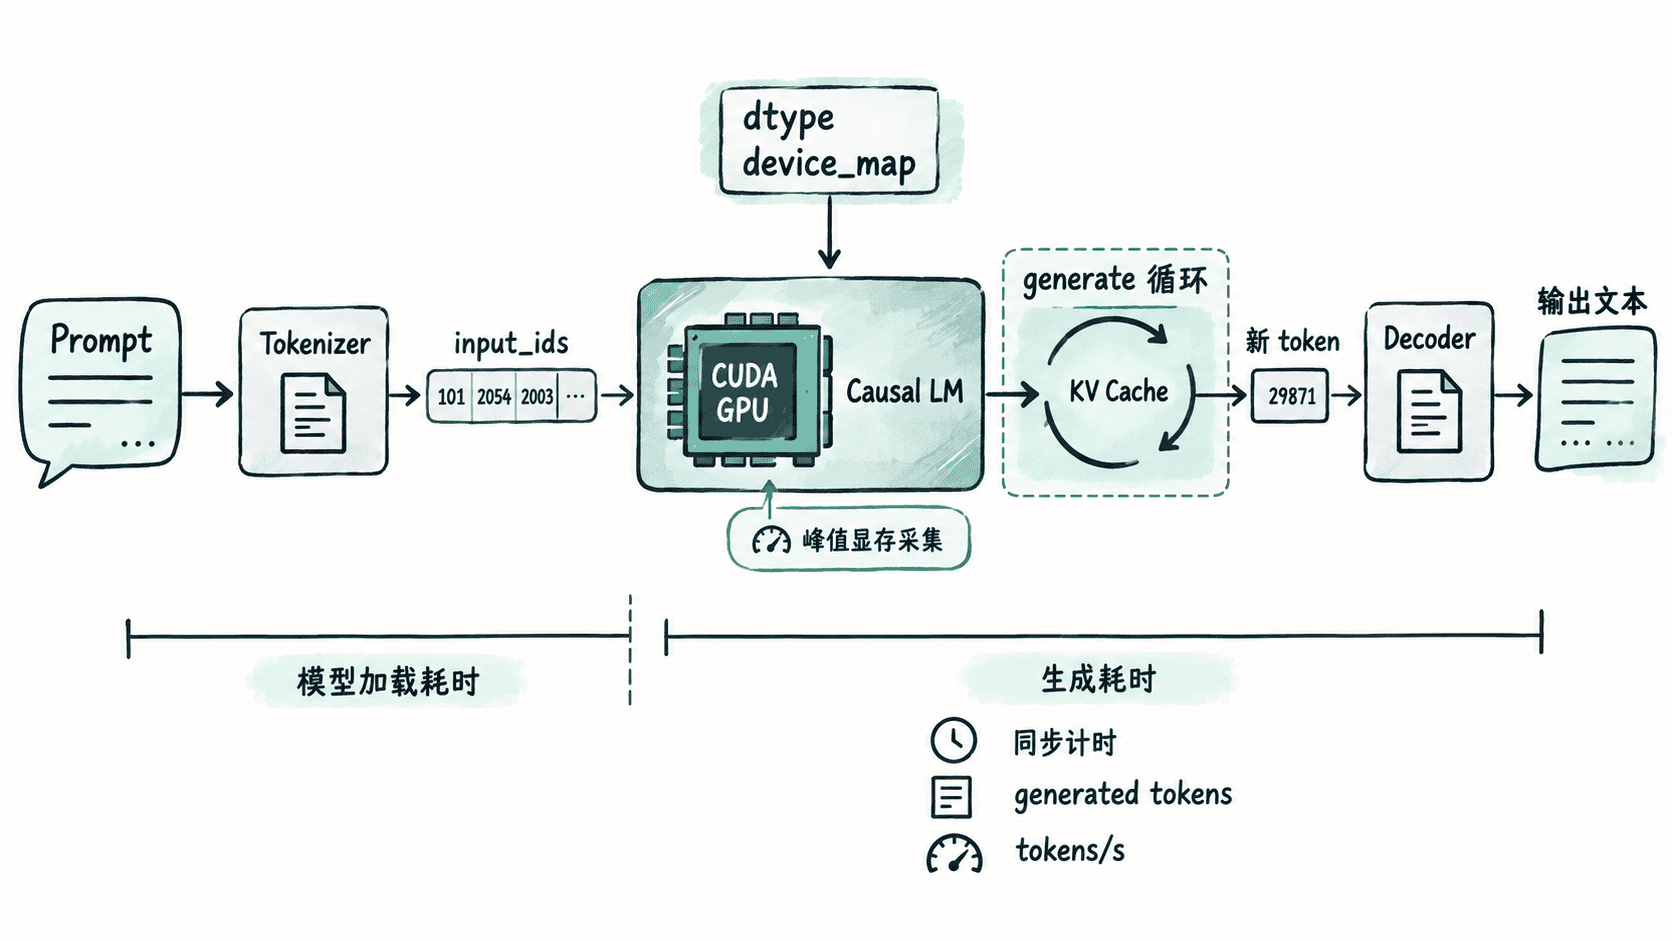
本节选择体积较小的 Qwen/Qwen2.5-0.5B-Instruct,目的是先验证推理链路,而不是测试显卡极限。第一次运行可能需要下载权重,因此首轮的模型加载时间会混入网络耗时;完成缓存后再运行一次,得到的加载时间才适合作为本机基线。
跑通一次可复现的 GPU 生成
下面示例要求当前环境已经能正常使用 PyTorch CUDA,并安装 transformers、accelerate 和 safetensors。代码根据显卡能力优先选择 BF16,否则使用 FP16;整个模型通过 device_map 固定到 cuda:0,避免多卡自动切分干扰单卡基线。
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer


def main() -> None:
    if not torch.cuda.is_available():
        raise SystemExit("CUDA is required for this baseline")

    model_id = "Qwen/Qwen2.5-0.5B-Instruct"
    device = "cuda:0"
    dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16

    load_start = time.perf_counter()
    tokenizer = AutoTokenizer.from_pretrained(model_id)
    model = AutoModelForCausalLM.from_pretrained(
        model_id,
        dtype=dtype,
        device_map=device,
    )
    torch.cuda.synchronize()
    load_seconds = time.perf_counter() - load_start

    messages = [{"role": "user", "content": "用一句话解释 KV Cache 的作用。"}]
    prompt = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
    )
    inputs = tokenizer(prompt, return_tensors="pt").to(device)
    input_tokens = inputs["input_ids"].shape[1]

    # 单独测量生成阶段,并从模型已驻留显存的状态重新统计峰值。
    torch.cuda.reset_peak_memory_stats()
    torch.cuda.synchronize()
    generate_start = time.perf_counter()
    with torch.inference_mode():
        outputs = model.generate(
            **inputs,
            max_new_tokens=48,
            do_sample=False,
            use_cache=True,
        )
    torch.cuda.synchronize()
    generation_seconds = time.perf_counter() - generate_start

    new_tokens = outputs[0, input_tokens:]
    generated_tokens = new_tokens.shape[0]
    text = tokenizer.decode(new_tokens, skip_special_tokens=True).strip()
    peak_gb = torch.cuda.max_memory_allocated() / 1024**3
    tokens_per_second = generated_tokens / generation_seconds

    print(f"model={model_id}")
    print(f"device={next(model.parameters()).device}")
    print(f"dtype={next(model.parameters()).dtype}")
    print(f"load_seconds={load_seconds:.3f}")
    print(f"input_tokens={input_tokens}")
    print(f"generated_tokens={generated_tokens}")
    print(f"generation_seconds={generation_seconds:.3f}")
    print(f"tokens_per_second={tokens_per_second:.2f}")
    print(f"peak_allocated_gb={peak_gb:.3f}")
    print(f"text={text}")


if __name__ == "__main__":
    main()
预期输出结构如下。时间、token 数、显存和生成文本都会受到 GPU、软件版本与模型实际输出影响,因此使用动态值表示。
model=Qwen/Qwen2.5-0.5B-Instruct
device=cuda:0
dtype=<DTYPE>
load_seconds=<TIME>
input_tokens=<VALUE>
generated_tokens=<VALUE>
generation_seconds=<TIME>
tokens_per_second=<VALUE>
peak_allocated_gb=<VALUE>
text=<GENERATED_TEXT>
torch.cuda.synchronize() 很重要,因为 CUDA kernel 通常异步提交。如果只在 model.generate() 前后直接读 CPU 时钟,计时可能在 GPU 尚未完成工作时就停止,得到偏低且不可比较的数据。
看懂影响结果的三个控制面
| 控制项 | 本例设置 | 对基线的主要影响 |
|---|---|---|
| dtype | BF16 可用时用 BF16,否则 FP16 | 决定权重与部分计算张量的显存和计算路径 |
device_map |
cuda:0 |
强制整个模型留在单卡,避免 CPU 或多卡卸载改变结果 |
| 生成参数 | max_new_tokens=48、do_sample=False、use_cache=True |
固定最大输出长度与解码策略,并启用典型 KV Cache 路径 |
对于性能对比,最容易被忽略的是输入和输出 token 数。两个请求即使都叫“生成一段回答”,长度不同也会导致生成时间与 KV Cache 显存不可直接比较。因此每次基准测试都应记录 input_tokens 和 generated_tokens,而不是只保存一个总耗时。
把第一份数据变成可复现基线
至少记录模型 ID 或具体 revision、GPU 型号、PyTorch 与 Transformers 版本、dtype、device_map、完整生成参数、输入 token 数、输出 token 数、生成耗时、tokens/s 和峰值显存。模型第一次从网络下载时的耗时应单独排除,避免把带宽差异误认为模型加载性能。
同一台机器再次测试时,应复用完全相同的提示词和生成参数。do_sample=False 可以消除随机采样带来的主要输出差异,但 GPU 负载、温度、其他进程和底层 kernel 选择仍可能令耗时产生波动,因此性能判断应比较多次运行,而不是把一次小幅变化当成优化结果。
处理最常见的首次运行失败
如果模型加载阶段就出现 CUDA out of memory,先确认模型是否确实全部放在 cuda:0,再检查权重 dtype 与当前空闲显存。为了保持本节的单卡基线,不要立即改成自动 CPU 卸载;优先换更小模型或释放其他 GPU 进程,否则得到的数据已经不再代表纯单卡推理。
如果出现模型在 CUDA、输入仍在 CPU 的设备不一致错误,要检查 Tokenizer 返回的张量是否执行了 .to(device)。如果 device_map 相关加载提示缺少 Accelerate,则补齐当前环境中的 accelerate 依赖,再重新启动 Python 进程。
当相同提示词能够稳定生成文本,并同时得到明确的 dtype、token 数、生成耗时、吞吐和峰值显存时,Transformers 单卡推理链路就已经跑通。后续量化、批处理、KV Cache 优化或推理引擎替换,都应继续与这份最小基线比较。