
大模型原理与训练 / 系统课时
建立推理服务可观测指标
建立推理服务可观测指标
一次延迟尖峰如果只能看到“GPU 利用率下降”还不足以定位根因。本篇把推理服务拆成请求、调度、KV Cache、模型实例和 GPU 五层,并说明如何用日志、追踪和聚合指标关联 request_id,把慢请求一路追到队列、批次与硬件。
学习目标
- 为推理服务设计请求级到 GPU 级的五层最小指标集合
- 正确使用
request_id关联日志与追踪,避免把高基数字段塞进指标标签 - 按固定顺序从延迟尖峰定位到队列、KV Cache、模型实例或硬件根因
先定义五层指标边界
可观测性不是“指标越多越好”,而是每一层都能回答一个明确问题。第一版只保留能支持容量、延迟和故障定位的指标。
| 层级 | 最小指标 | 主要用途 |
|---|---|---|
| 请求级 | QPS、错误率、E2E latency、TTFT、TPOT、输入/输出 token | 判断用户体验和负载变化 |
| 调度级 | queue depth、queue time、running/pending、batch size、preemption | 判断是否排队、合批不足或调度拥塞 |
| KV Cache | usage ratio、allocation failure、eviction/recompute | 判断上下文容量与缓存压力 |
| 模型实例 | tokens/s、active sequences、prefill/decode 数、实例健康 | 判断是哪一个实例或阶段掉速 |
| GPU | utilization、显存、功耗、温度、时钟、PCIe/NVLink 吞吐 | 判断硬件饱和、降频或通信瓶颈 |
延迟指标最好用 Histogram 或等价的可聚合分布结构,而 queue depth、batch size、KV Cache 使用率更适合 Gauge。请求数、错误数和重试数则适合 Counter。
让 request_id 贯穿日志与追踪
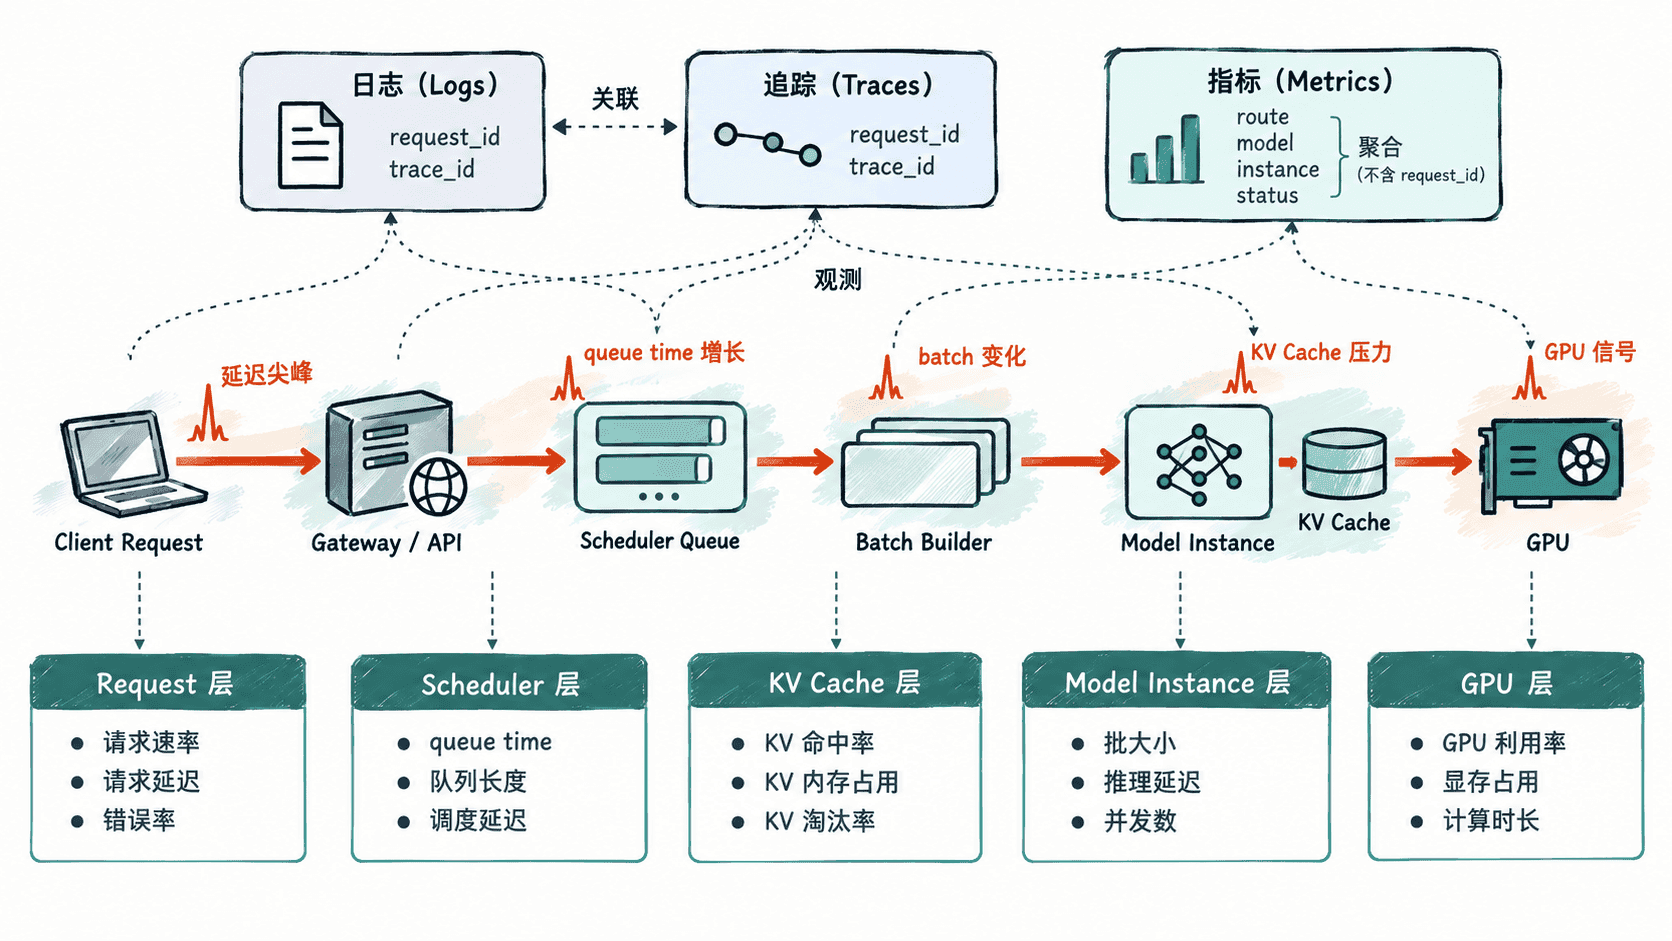
request_id 适合放在结构化日志和 trace span 中,因为它能精确指向一次请求;但不要把它放进 Prometheus 标签。每个请求一个标签值会制造高基数时间序列,轻则占用大量内存,重则让查询和存储系统失去可用性。
建议入口生成或接收 request_id,随后在排队、组批、prefill、decode 和响应阶段都写入同一个 ID;追踪系统再用 trace_id 串起 span。指标只使用有限集合的标签,例如 route、model、instance、status 和少量优先级枚举。
建一个最小可运行指标骨架
下面的 Python 脚本模拟一次请求完成后的结构化日志和五层指标输出。它不依赖第三方库,重点验证命名、单位和关联键;接入真实服务时,再把这些采样点放到对应执行阶段并暴露给指标采集器。
import json
import uuid

request_id = uuid.uuid4().hex
trace_id = uuid.uuid4().hex

log = {
    "request_id": request_id,
    "trace_id": trace_id,
    "stage": "response",
    "queue_ms": 17,
    "batch_size": 8,
    "ttft_ms": 126,
    "e2e_ms": 842,
}

print(json.dumps(log, ensure_ascii=False, separators=(",", ":")))

metrics = [
    'inference_request_duration_seconds{route="/v1/chat",status="200"} 0.842',
    'inference_scheduler_queue_seconds{model="demo"} 0.017',
    'inference_scheduler_batch_size{model="demo"} 8',
    'inference_kv_cache_usage_ratio{model="demo"} 0.63',
    'inference_instance_tokens_per_second{model="demo",instance="0"} 142.5',
    'inference_gpu_utilization_ratio{gpu="0"} 0.91',
]

for line in metrics:
    print(line)
预期输出(实际 request_id 和 trace_id 会不同):
{"request_id":"<ID>","trace_id":"<ID>","stage":"response","queue_ms":17,"batch_size":8,"ttft_ms":126,"e2e_ms":842}
inference_request_duration_seconds{route="/v1/chat",status="200"} 0.842
inference_scheduler_queue_seconds{model="demo"} 0.017
inference_scheduler_batch_size{model="demo"} 8
inference_kv_cache_usage_ratio{model="demo"} 0.63
inference_instance_tokens_per_second{model="demo",instance="0"} 142.5
inference_gpu_utilization_ratio{gpu="0"} 0.91
这个示例中的 duration 只是单点演示。生产环境应把请求延迟、TTFT 和 TPOT记录为可聚合分布,并由监控系统计算 P50、P95、P99,而不是在应用进程里只保留一个百分位结果。
从延迟尖峰反推根因
定位时先判断慢在 TTFT 还是 TPOT。TTFT 上升优先看 queue time、batch 形成时间、prefill tokens/s 和 KV Cache 分配;TPOT 上升则更应该看 decode tokens/s、active sequences、GPU 时钟与跨卡通信。
如果 request P99 上升且 queue depth、queue time 同时上升,先处理容量、限流或调度;如果队列正常而 KV Cache 使用率接近上限,并伴随 eviction、recompute 或 preemption 增加,问题更可能来自上下文容量压力。
若调度和 KV Cache 都正常,但某个模型实例的 tokens/s 明显下降,就继续下钻该实例对应 GPU。高温或功耗限制配合 SM clock 下跌指向降频;GPU 利用率波动且互联吞吐异常升高,则更像通信或同步开销。
控制标签基数和告警边界
指标标签应是有限集合。不要使用 request_id、user_id、完整 prompt、任意 URL、时间戳或异常堆栈作为标签;这些信息应留在日志或追踪系统中。指标负责“发现异常”,日志和 trace 负责“解释这一次为什么异常”。
告警也应跨层组合,而不是只盯单个 GPU 百分比。更有用的条件是“P99 超阈值且 queue time 上升”“KV Cache 高水位且 eviction 增长”或“tokens/s 下跌且 SM clock 同步下降”。这样告警本身就携带第一步诊断方向,能明显缩短从现象到根因的路径。