
大模型原理与训练 / 系统课时
用 Triton 管理模型实例
用 Triton 管理模型实例
本节用一个最小可运行模型搭起 Triton 模型仓库,配置两个执行实例、动态批处理与健康检查,再演示显式加载和卸载。完成后你能分清 Triton 的模型实例管理职责与集群伸缩职责。
学习目标
- 按 Triton 规则组织模型仓库并理解版本目录、配置和后端的关系
- 用
instance_group与调度配置控制单进程内的并发执行能力 - 使用健康接口和显式模型控制 API 验证服务状态,并判断何时交给集群编排层扩容
建一个可验证的模型仓库
Triton 从一个或多个 model repository 加载模型;每个模型使用自己的目录,模型版本放在数字子目录中。示例固定使用 Triton 26.08 容器,并用 Python backend 写一个输入加一的无状态模型,便于把注意力集中在实例和调度行为上。([NVIDIA Docs][4])
rm -rf models/adder
mkdir -p models/adder/1

cat > models/adder/config.pbtxt <<'EOF'
name: "adder"
backend: "python"
max_batch_size: 8

input [
  {
    name: "INPUT0"
    data_type: TYPE_FP32
    dims: [ 1 ]
  }
]

output [
  {
    name: "OUTPUT0"
    data_type: TYPE_FP32
    dims: [ 1 ]
  }
]

instance_group [
  {
    count: 2
    kind: KIND_CPU
  }
]

dynamic_batching {
  max_queue_delay_microseconds: 1000
}
EOF

cat > models/adder/1/model.py <<'PY'
import numpy as np
import triton_python_backend_utils as pb_utils

class TritonPythonModel:
    def execute(self, requests):
        responses = []
        for request in requests:
            x = pb_utils.get_input_tensor_by_name(request, "INPUT0").as_numpy()
            y = (x + np.float32(1.0)).astype(np.float32)
            output = pb_utils.Tensor("OUTPUT0", y)
            responses.append(
                pb_utils.InferenceResponse(output_tensors=[output])
            )
        return responses
PY

find models/adder -maxdepth 2 -type f | sort
预期输出
models/adder/1/model.py
models/adder/config.pbtxt
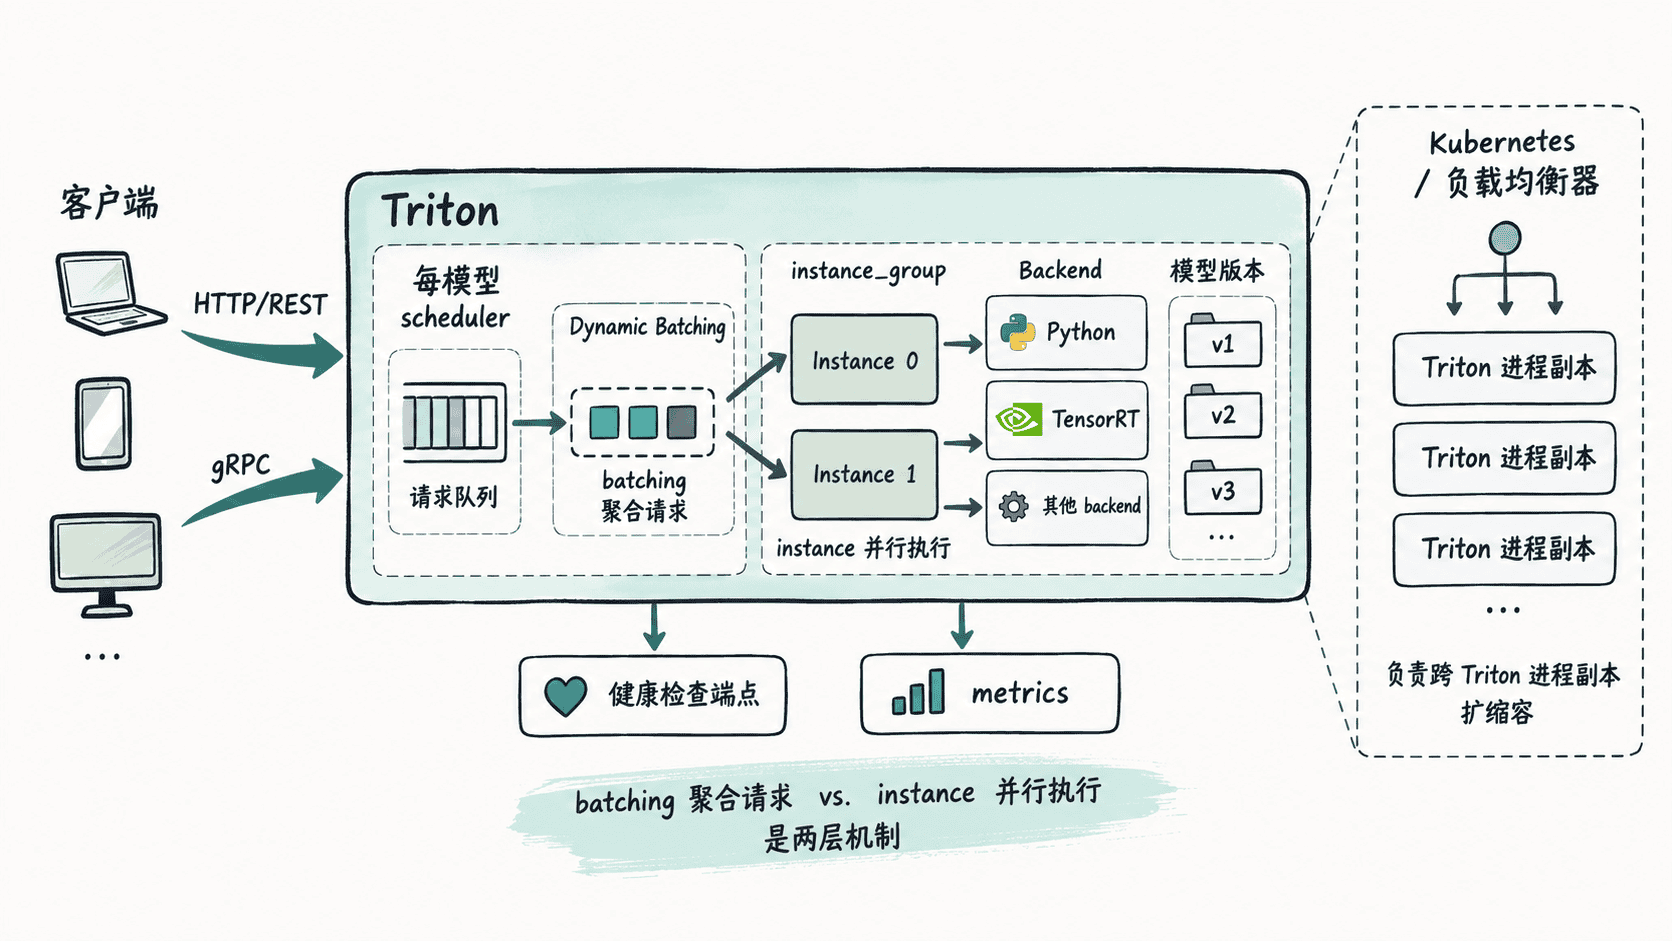
count: 2 表示 Triton 为这个模型创建两个执行实例;两批请求可以在不同实例上并行执行。dynamic_batching 则作用在实例之前,允许调度器短暂聚合请求后再交给可用实例,两者解决的不是同一个问题。Triton 官方文档也明确把实例数作为并行执行配置,而动态批处理通过队列等待时间控制聚合机会。([NVIDIA Docs][5])
启动服务并检查健康状态
Triton 26.08 官方镜像沿用 8000/8001/8002 作为常见 HTTP、gRPC 与 metrics 端口。这里使用 explicit 模式并在启动时加载 adder,这样后续可以用管理 API 主动卸载和加载。([NVIDIA Docs][6])
docker run --rm -d --name triton-adder \
  -p 8000:8000 \
  -p 8001:8001 \
  -p 8002:8002 \
  -v "$PWD/models:/models:ro" \
  nvcr.io/nvidia/tritonserver:26.08-py3 \
  tritonserver \
    --model-repository=/models \
    --model-control-mode=explicit \
    --load-model=adder >/dev/null

for i in $(seq 1 60); do
  code=$(curl -s -o /dev/null -w '%{http_code}' \
    http://localhost:8000/v2/health/ready || true)
  if [ "$code" = "200" ]; then
    echo "ready=200"
    exit 0
  fi
  sleep 1
done

echo "ready=timeout"
exit 1
预期输出
ready=200再分别检查进程存活、服务就绪和具体模型就绪。健康接口返回 200 才应让负载均衡器继续发送流量。Triton 的 HTTP/REST 与 gRPC 协议同时提供健康、元数据、统计和模型管理能力。([NVIDIA Docs][7])
for path in \
  /v2/health/live \
  /v2/health/ready \
  /v2/models/adder/ready
do
  code=$(curl -s -o /dev/null -w '%{http_code}' \
    "http://localhost:8000${path}")
  echo "${path}=${code}"
done
预期输出
/v2/health/live=200
/v2/health/ready=200
/v2/models/adder/ready=200
发请求验证实例后端
用 HTTP V2 inference API 发送一个标量批次。这里把返回 JSON 交给 Python 只打印数值,避免输出字段顺序影响验证。
curl -s -X POST \
  http://localhost:8000/v2/models/adder/infer \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": [
      {
        "name": "INPUT0",
        "shape": [1, 1],
        "datatype": "FP32",
        "data": [41.0]
      }
    ]
  }' \
| python3 -c 'import json,sys; print(json.load(sys.stdin)["outputs"][0]["data"][0])'
预期输出
42.0把 instance_group.count 从 1 调到 2,并不保证吞吐自动翻倍。实例会占用额外 CPU/GPU 上下文和模型资源;对大模型尤其要同时观察 p95 延迟、GPU 显存、队列时间和吞吐。对于自带 continuous/in-flight batching 的 LLM backend,也不要未经基准测试就叠加通用 dynamic_batching。
显式加载和卸载模型
默认 none 模式会在启动时加载仓库中的模型,运行中忽略仓库变化;explicit 模式则允许通过模型控制 API 主动 load/unload。官方安全指南建议除非确有动态管理需求,否则优先保持静态加载,并严格保护模型仓库与控制接口。([NVIDIA Docs][8])
curl -s -o /dev/null -w 'unload=%{http_code}\n' \
  -X POST \
  http://localhost:8000/v2/repository/models/adder/unload

curl -s -o /dev/null -w 'load=%{http_code}\n' \
  -X POST \
  http://localhost:8000/v2/repository/models/adder/load
预期输出
unload=200
load=200
这套机制适合在同一个 Triton 进程内管理多模型与版本,但它不是集群自动伸缩器。Triton 负责模型仓库、调度、实例、协议、健康与指标;当单进程的 GPU、显存或请求队列达到上限时,应由 Kubernetes、负载均衡器或其他编排层增加 Triton 副本并分发流量,而不是无限增大 instance_group.count。