
大模型原理与训练 / 系统课时
配好 CUDA 与 PyTorch 环境
配好 CUDA 与 PyTorch 环境
大模型能否稳定跑在单卡上,第一步不是下载模型,而是确认驱动、PyTorch CUDA 运行时、GPU 架构和显存访问都正常。本节建立一套可重复执行的自检流程,最终用真实矩阵运算证明 GPU 计算链路可用。
学习目标
- 分清 NVIDIA 驱动、PyTorch CUDA 运行时与本地 CUDA Toolkit 的职责
- 检查 GPU、计算能力、半精度支持和 PyTorch CUDA 状态
- 通过矩阵运算与显存统计建立部署前环境基线
先分清 CUDA 环境的几层关系
判断环境是否匹配时,不要只比较两个所谓的“CUDA 版本”。nvidia-smi 主要证明 NVIDIA 驱动能够识别 GPU;其中显示的 CUDA 版本表示该驱动能够支持的 CUDA 能力范围,并不等同于本机安装的 CUDA Toolkit 版本。
PyTorch 自己还带有用于运行预编译算子的 CUDA 运行时组件。torch.version.cuda 表示当前 PyTorch 构建所对应的 CUDA 版本,而 torch.cuda.get_device_capability() 则反映实际 GPU 的计算能力。普通预编译 PyTorch 推理首先依赖驱动兼容;只有编译自定义 CUDA 扩展等场景,才需要额外重点检查本地 Toolkit。
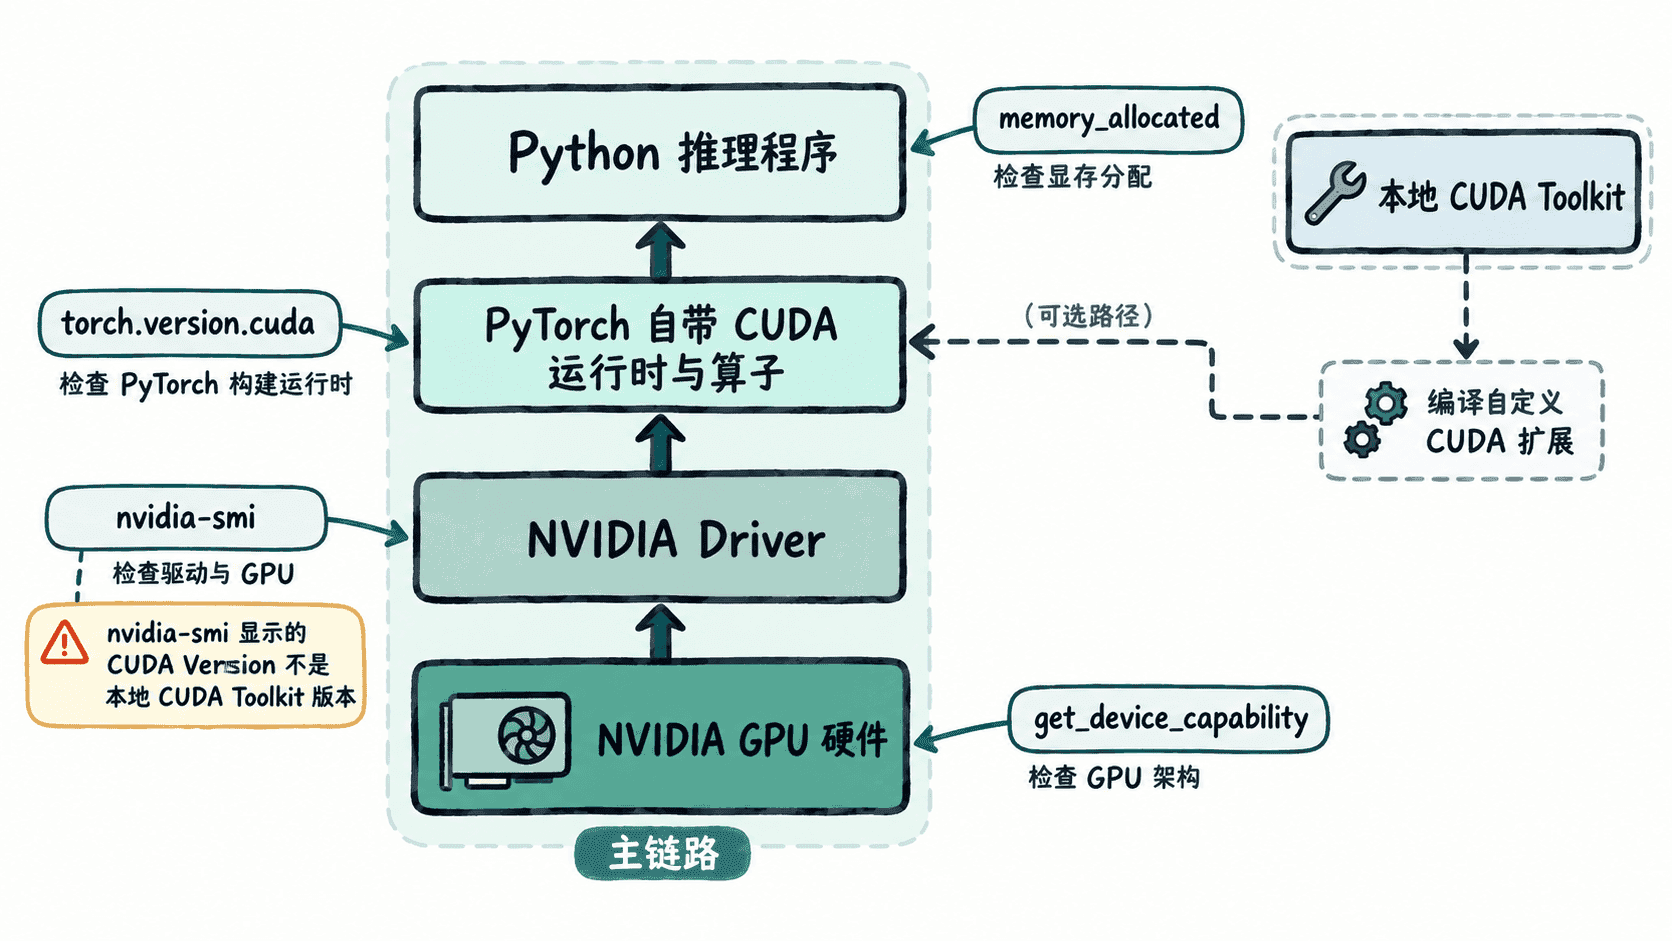
先确认驱动能够看到显卡
在进入 Python 环境前先查询 GPU。下面的命令只输出后续基线需要的显卡名称、驱动版本和显存容量,便于保存结果或写进部署检查单。
nvidia-smi --query-gpu=name,driver_version,memory.total --format=csv,noheader预期输出如下,具体型号、驱动和显存值会因机器而异。
<GPU_NAME>, <DRIVER_VERSION>, <MEMORY_TOTAL>如果这里直接报找不到命令、无法与 NVIDIA Driver 通信或没有任何 GPU,就先修复驱动、容器 GPU 映射或设备权限。此时继续调整 PyTorch 包通常没有意义,因为更底层的设备链路尚未建立。
用 PyTorch 做一次完整自检
仅有 torch.cuda.is_available() 为 True 还不够。部署前应至少验证设备属性、计划使用的半精度类型、一次真实 CUDA 矩阵乘法以及显存分配统计。下面程序可以保存为 check_torch_cuda.py 后直接执行。
import torch


def main() -> None:
    if not torch.cuda.is_available():
        raise SystemExit("CUDA unavailable: check driver and PyTorch installation")

    device = torch.device("cuda:0")
    props = torch.cuda.get_device_properties(device)
    dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16

    print(f"torch={torch.__version__}")
    print(f"torch_cuda={torch.version.cuda}")
    print(f"gpu={props.name}")
    print(f"capability={props.major}.{props.minor}")
    print(f"dtype={dtype}")

    # 重新统计本次计算的峰值,避免被此前 CUDA 操作污染。
    torch.cuda.empty_cache()
    torch.cuda.reset_peak_memory_stats(device)

    a = torch.randn((2048, 2048), device=device, dtype=dtype)
    b = torch.randn((2048, 2048), device=device, dtype=dtype)
    c = a @ b
    torch.cuda.synchronize(device)

    print(f"matmul_shape={tuple(c.shape)}")
    print(f"allocated_mb={torch.cuda.memory_allocated(device) / 1024**2:.1f}")
    print(f"peak_mb={torch.cuda.max_memory_allocated(device) / 1024**2:.1f}")


if __name__ == "__main__":
    main()
预期输出如下。版本、GPU、dtype 和显存数字属于动态值,实际结果可能不同。
torch=<VERSION>
torch_cuda=<VERSION>
gpu=<GPU_NAME>
capability=<MAJOR>.<MINOR>
dtype=<DTYPE>
matmul_shape=(2048, 2048)
allocated_mb=<VALUE>
peak_mb=<VALUE>
这里最关键的验收条件不是某个固定版本号,而是程序能够识别目标 GPU、成功选择可用半精度类型、完成矩阵乘法,并返回合理的显存统计。若半精度运算本身失败,也应在加载数十 GB 模型之前解决 GPU 架构或软件兼容问题。
按故障层级处理不匹配
环境异常时应从底层向上定位。nvidia-smi 失败通常属于驱动、设备映射或权限问题;nvidia-smi 正常而 torch.cuda.is_available() 为 False,则优先检查当前虚拟环境是否安装了正确的 PyTorch 构建,以及启动程序使用的 Python 是否就是安装依赖的解释器。
如果 CUDA 可用但矩阵运算失败,应继续核对 GPU 计算能力和所选 dtype;如果计算正常却在加载模型时出现 CUDA out of memory,则说明 CUDA 环境已经工作,问题已经转变为模型权重、KV Cache、激活和其他显存占用之和超过设备容量,不应再把它误判为驱动故障。
固化部署前基线
正式开始模型推理前,至少保存 GPU 型号与总显存、驱动版本、PyTorch 版本、torch.version.cuda、GPU compute capability、最终使用的 dtype,以及矩阵测试得到的峰值显存。这组数据能让后续的模型加载失败、性能回退和机器差异有明确的比较基准。
当 nvidia-smi、PyTorch CUDA 检测、半精度矩阵运算和显存统计全部通过时,这台机器才算具备了可靠的单卡推理基础环境。