
大模型原理与训练 / 系统课时
开启 Prefix Cache 复用前缀
开启 Prefix Cache 复用前缀
当多轮对话、RAG 模板或系统提示反复出现同一段开头时,Prefix Cache 可以直接复用已经计算过的 KV Cache,减少重复 Prefill。本节用 vLLM 开启前缀缓存,并用共享前缀负载检查命中率、KV 占用和 TTFT 是否真正改善。
学习目标
- 识别适合 Prefix Cache 的共享前缀,并避免把高变化字段放到前缀最前面。
- 在 vLLM 服务中显式开启前缀缓存,并构造可重复的共享前缀负载。
- 结合命中率、KV Cache 使用率和 TTFT 判断收益是否覆盖缓存占用。
Prefix Cache 复用的到底是什么
LLM 在 Prefill 阶段会为 Prompt 的每个 Token 计算注意力所需的 Key/Value。若后续请求拥有完全相同的 Token 前缀,这部分 KV 不必再次计算,只需从匹配结束的位置继续 Prefill 新增后缀。收益主要落在首 Token 之前,因此它改善的是 Prefill 工作量和 TTFT,而不是 Decode 阶段每个新 Token 的计算成本。
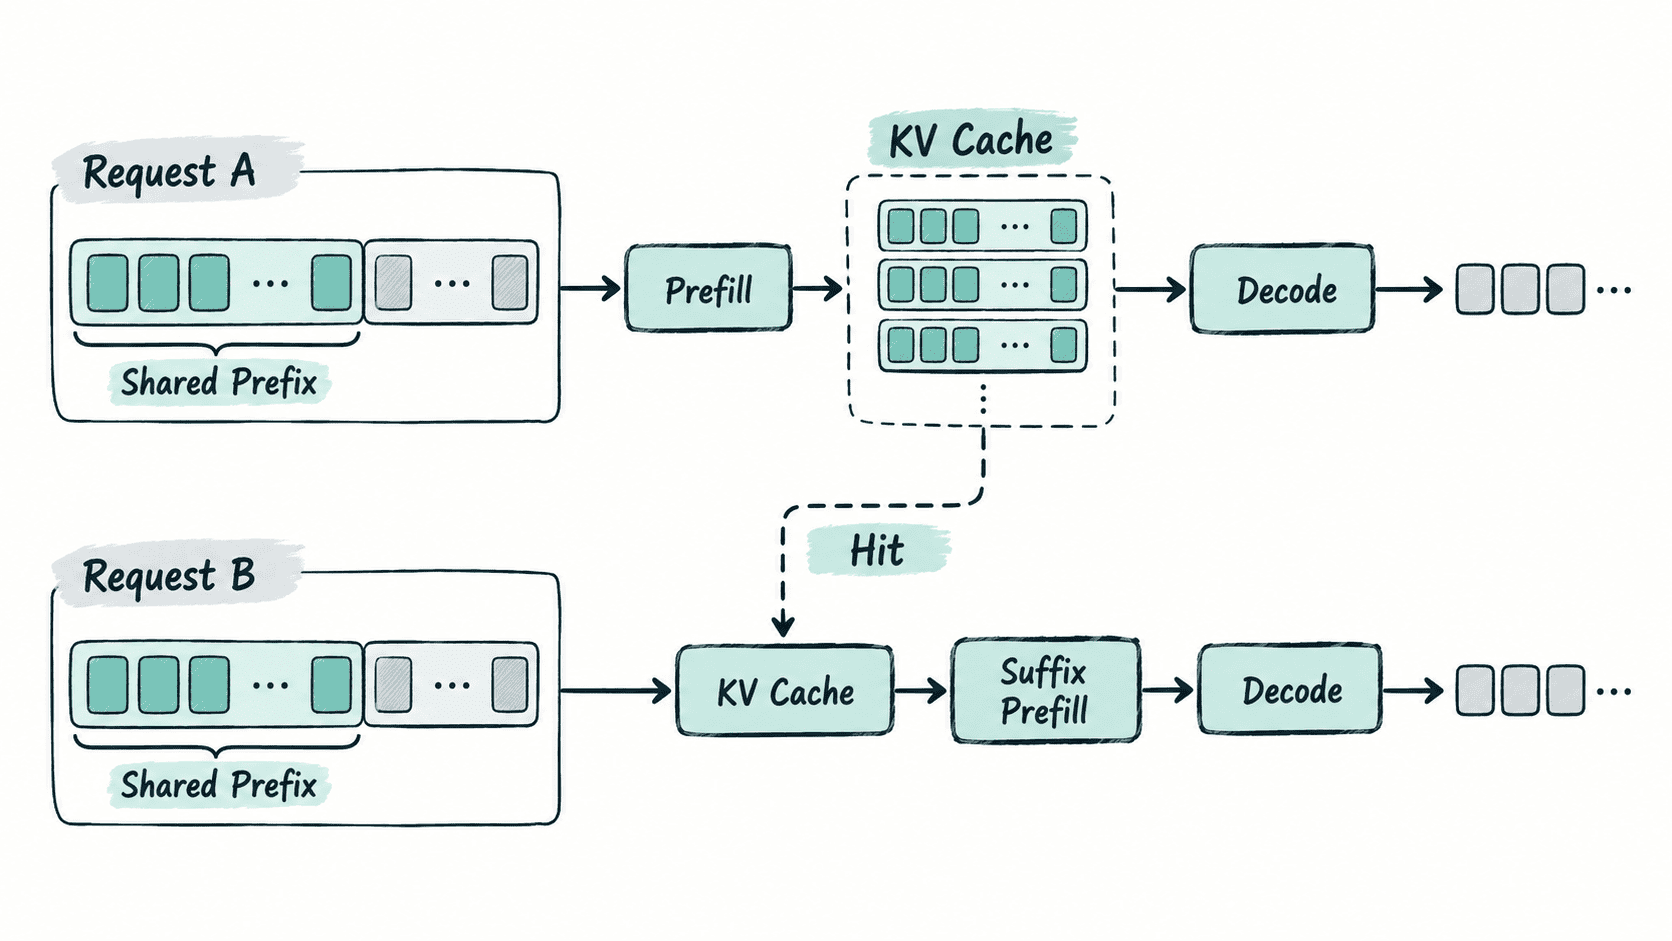
前缀必须在 Token 序列上连续匹配。系统提示、工具描述、固定 RAG 模板和多轮历史如果稳定地位于开头,通常容易命中;若把时间戳、请求 ID、随机盐值或每次变化的检索内容放在最前面,就会提前打断共享前缀。
显式开启前缀缓存
下面以一张单卡上的小模型为例启动 OpenAI 兼容服务。显式传入 --enable-prefix-caching,可以避免依赖环境默认值,让实验配置可复现。
# 显式启用 Prefix Cache,固定地址便于后续压测。
MODEL=Qwen/Qwen2.5-0.5B-Instruct
vllm serve "$MODEL" --host 127.0.0.1 --port 8000 --enable-prefix-caching
预期结果:
服务成功启动并监听 127.0.0.1:8000;后续拥有相同 Token 前缀的请求具备 KV Cache 复用条件。Prefix Cache 不会改变模型权重或生成语义。它只是让已经计算过的 KV 块在可复用时继续留在缓存池中,因此应把收益与 KV Cache 容量压力一起观察。
构造共享前缀负载
vllm bench serve 的随机数据集可以给一批请求附加固定前缀。下面让每个请求共享约 4096 个前缀 Token,再附加随机正文,用于模拟固定系统提示、大段 RAG 模板或重复文档上下文。
# 固定共享前缀长度,模拟系统提示或模板复用。
# 保持并发与输出长度不变,便于比较 TTFT。
MODEL=Qwen/Qwen2.5-0.5B-Instruct
vllm bench serve --backend openai-chat --model "$MODEL" --endpoint /v1/chat/completions --dataset-name random --random-prefix-len 4096 --random-input-len 256 --random-output-len 32 --num-prompts 50 --max-concurrency 4 --host 127.0.0.1 --port 8000 --percentile-metrics ttft,e2el
预期输出中的具体时间依 GPU 与并发而变化,重点记录 TTFT 和尾延迟:
Successful requests:                     50
Request throughput (req/s):              <VALUE>
Mean TTFT (ms):                          <TIME>
P99 TTFT (ms):                           <TIME>
P99 E2EL (ms):                           <TIME>
第一次出现的共享前缀仍要完成 Prefill;后续请求才有机会复用。因此不要只看第一条请求,也不要把一次冷启动结果当成稳定收益。
检查命中率和 KV 占用
vLLM 的 Prometheus 指标中可以直接读取前缀查询、命中 Token 数以及 KV Cache 使用率。下面把当前累计值汇总成一个易读结果。
# 汇总 Prefix Cache 查询/命中 Token,并读取当前 KV Cache 使用率。
curl -s http://127.0.0.1:8000/metrics | awk '
$1 ~ /^vllm:prefix_cache_queries/ {queries += $2}
$1 ~ /^vllm:prefix_cache_hits/ {hits += $2}
$1 ~ /^vllm:kv_cache_usage_perc/ {kv = $2}
END {
  if (queries > 0) printf "prefix_hit_rate=%.2f%%\n", 100 * hits / queries;
  else print "prefix_hit_rate=N/A";
  printf "kv_cache_usage=%.4f\n", kv
}'
预期输出:
prefix_hit_rate=<VALUE>%
kv_cache_usage=<VALUE>
命中率上升且 TTFT 下降,说明共享前缀确实转化成了计算节省;如果 KV 使用率长期逼近上限、缓存频繁被淘汰,则需要同时检查并发、上下文长度和可复用前缀规模,而不是只追求更高命中率。
识别收益边界
最适合缓存的是“长且稳定”的开头,例如固定系统提示、相同工具定义、模板化 RAG 指令,以及同一会话连续追加的新消息。将稳定内容尽量放前面,把时间戳、用户特有字段和本次检索结果推迟到共享段之后,通常比单纯打开开关更重要。
低复用、短 Prompt 或每次开头都不同的流量,很难获得明显收益。Prefix Cache 也不会加速已经进入 Decode 的逐 Token 生成;如果真正瓶颈在输出很长、Decode 占比高,就应把优化重点转向批调度、量化、并行或投机解码。