
大模型原理与训练 / 系统课时
按模型与负载选择推理引擎
按模型与负载选择推理引擎
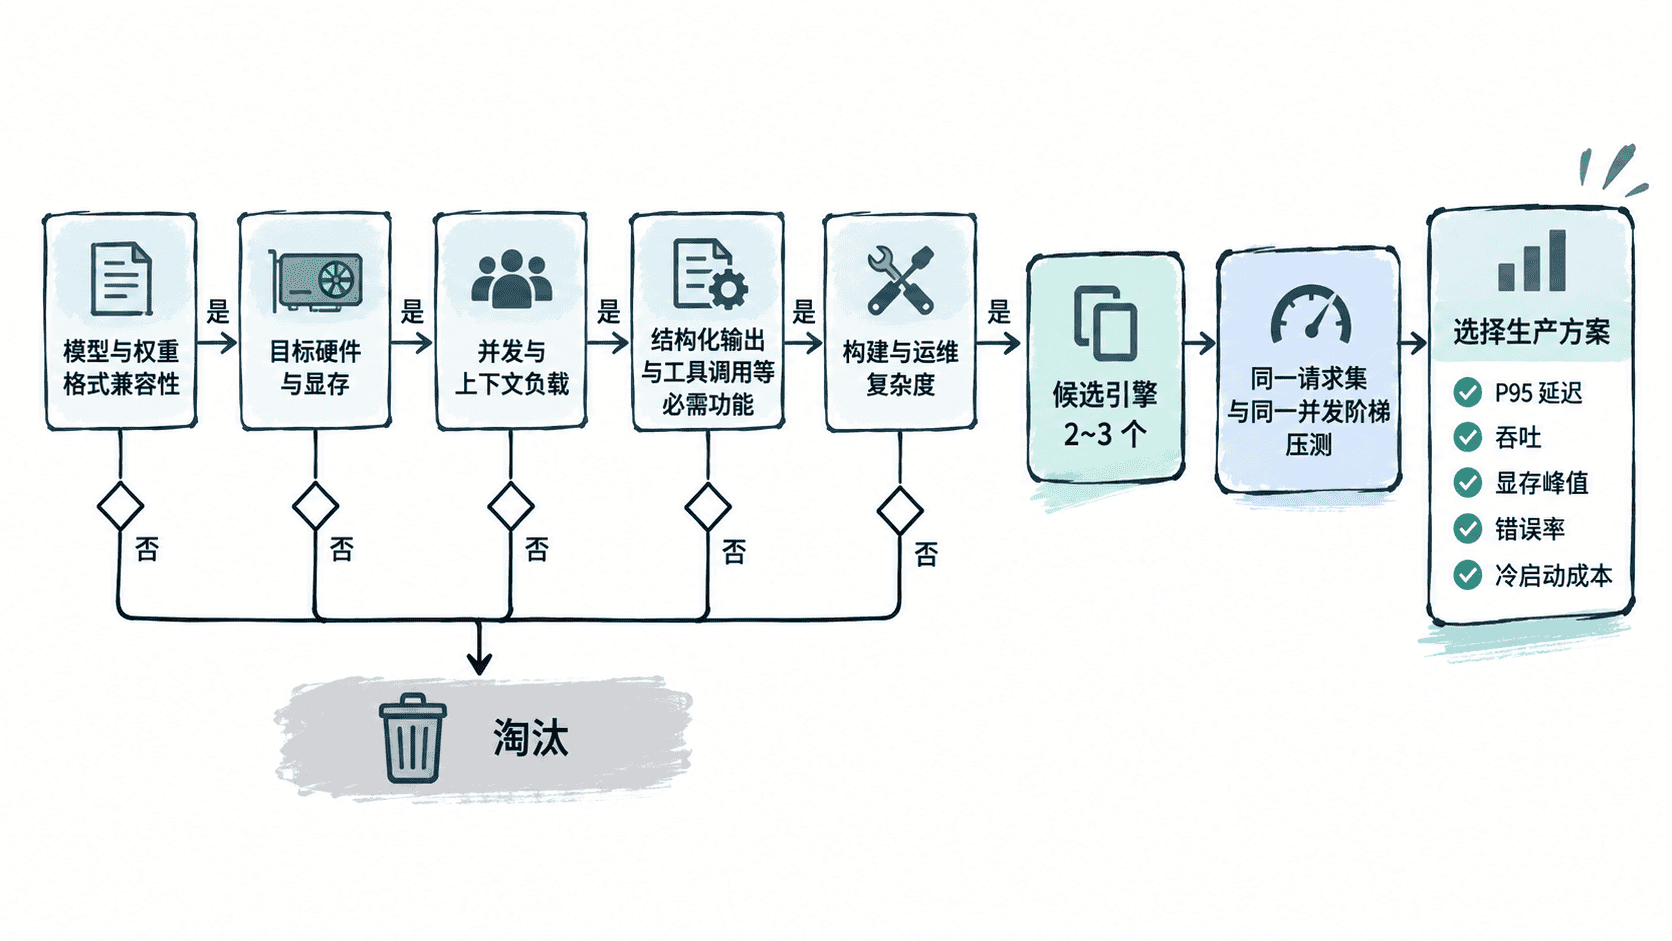
这篇要解决的不是“哪个引擎跑分最高”,而是怎样把模型兼容性、硬件、并发、上下文长度、结构化输出和运维成本放进同一套决策流程,并用同一批真实请求压测后再定生产方案。
学习目标
- 能先用硬约束淘汰不适配的推理引擎,再比较性能。
- 能根据并发、上下文和结构化工作流选择候选引擎。
- 能用同一压测口径比较尾延迟、吞吐、显存和失败率。
先用硬约束淘汰候选
推理引擎的第一轮筛选不应该看 tokens/s,而要先回答“能不能稳定运行”。把模型架构、权重格式、量化方式、目标硬件、最长上下文和必须使用的功能列成硬约束;任何一项不满足,就先移出候选集。
常见候选可以这样理解:vLLM 适合作为通用 GPU 服务基线;SGLang 值得用于结构化生成、前缀复用或复杂请求编排较重的工作负载;TensorRT-LLM 更偏向 NVIDIA 平台上的深度优化;TGI 适合希望沿用 Hugging Face 服务栈的团队;llama.cpp 常见于 CPU、Apple Silicon、边缘设备和 GGUF 量化场景。这里是选型起点,不是固定结论,模型与硬件支持矩阵必须按部署版本重新核对。
| 维度 | 必问问题 | 淘汰信号 |
|---|---|---|
| 模型 | 架构、MoE、多模态、量化格式是否受支持 | 需要改模型结构或缺关键算子 |
| 硬件 | NVIDIA、AMD、CPU 或其他加速器是否匹配 | 目标硬件只能走未验证后端 |
| 内存 | 权重、KV Cache 和运行时峰值能否留出余量 | 只能靠频繁 OOM 重试维持 |
| 功能 | JSON 约束、工具调用、LoRA、前缀缓存是否必须 | 关键功能需自行维护补丁 |
| 运维 | 构建、升级、监控和故障定位成本是否可接受 | 每次升级都依赖长时间手工构建 |
用负载形状缩小候选集
通过硬约束后,再看请求“长什么样”。短上下文、高并发在线聊天通常更依赖连续批处理、KV Cache 管理和调度效率;长上下文会把显存压力和 prefill 时间放大;大量共享系统提示词或固定前缀时,前缀缓存命中率会改变结论;JSON Schema、工具调用或多阶段 Agent 工作流则要把约束解码和请求编排能力纳入主指标。
不要用“单请求最快”代替生产目标。低并发时,内核优化更容易主导结果;并发升高后,调度、批处理、KV Cache 碎片和队列等待会逐步成为瓶颈。因此至少要覆盖低、中、高三档并发,并让输入长度、输出长度和业务真实分布接近线上。
用同一脚本做可比压测
下面的脚本只依赖 Python 标准库,针对 OpenAI 兼容的 /v1/chat/completions 接口发送同一批非流式请求。它记录成功率、P50/P95 端到端延迟和总体生成吞吐,适合先做跨引擎的统一基线。运行前为每个候选引擎设置相同的模型、采样参数、并发和请求数。
import json
import math
import os
import time
import urllib.request
from concurrent.futures import ThreadPoolExecutor, as_completed

URL = os.getenv("BASE_URL", "http://127.0.0.1:8000/v1/chat/completions")
MODEL = os.getenv("MODEL", "Qwen/Qwen3-8B")
REQUESTS = int(os.getenv("REQUESTS", "12"))
CONCURRENCY = int(os.getenv("CONCURRENCY", "4"))

payload = {
    "model": MODEL,
    "messages": [{"role": "user", "content": "用三句话解释张量并行。"}],
    "temperature": 0,
    "max_tokens": 64,
}

def once():
    data = json.dumps(payload).encode("utf-8")
    req = urllib.request.Request(
        URL, data=data, headers={"Content-Type": "application/json"}
    )
    started = time.perf_counter()
    try:
        with urllib.request.urlopen(req, timeout=120) as resp:
            body = json.load(resp)
        elapsed = time.perf_counter() - started
        tokens = body.get("usage", {}).get("completion_tokens", 0)
        return elapsed, tokens, None
    except Exception as exc:
        return time.perf_counter() - started, 0, type(exc).__name__

wall_started = time.perf_counter()
results = []
with ThreadPoolExecutor(max_workers=CONCURRENCY) as pool:
    futures = [pool.submit(once) for _ in range(REQUESTS)]
    for future in as_completed(futures):
        results.append(future.result())
wall = time.perf_counter() - wall_started

ok = [(latency, tokens) for latency, tokens, err in results if err is None]
if not ok:
    raise SystemExit("all requests failed")

latencies = sorted(latency for latency, _ in ok)
p50 = latencies[len(latencies) // 2]
p95 = latencies[math.ceil(len(latencies) * 0.95) - 1]
tokens = sum(tokens for _, tokens in ok)

print(f"success={len(ok)}/{REQUESTS}")
print(f"p50_e2e_ms={p50 * 1000:.1f}")
print(f"p95_e2e_ms={p95 * 1000:.1f}")
print(f"generated_tokens_per_s={tokens / wall:.1f}")
预期输出
success=12/12
p50_e2e_ms=<TIME>
p95_e2e_ms=<TIME>
generated_tokens_per_s=<FREQ>
实际数值取决于模型、GPU 和并发。这个脚本故意只测统一的端到端基线;如果业务是流式聊天,还要补测 TTFT 和 TPOT,并从引擎指标中记录 GPU 显存峰值、排队时间和错误率。
让压测数据而不是偏好做决定
最终比较时先看是否达到 SLO,再看单位资源效率。一个常用顺序是:先淘汰 P95/P99 超标或有错误的方案,再比较每 GPU 的请求吞吐与 token 吞吐,然后检查高并发下显存是否稳定,最后把镜像大小、冷启动、构建时间、升级难度和可观测性纳入运维成本。
如果两个引擎的性能接近,优先选择团队能稳定升级、监控和排障的那个。生产选型的目标不是找“理论最快”的引擎,而是在真实请求分布和明确 SLO 下找到性能、功能与运维成本的可持续平衡。