
大模型原理与训练 / 系统课时
理解连续批处理的调度收益
理解连续批处理的调度收益
连续批处理解决的不是“把更多请求一次塞进 GPU”这么简单,而是让已完成请求立即释放执行槽位,并在下一轮解码时补入新请求。对输出长度差异很大的在线流量,这种动态补槽能显著减少空槽等待,提高 GPU 的有效工作比例并缩短排队时间。
学习目标
- 区分静态批处理和 Continuous Batching 在请求加入、退出时机上的差异。
- 用一个最小调度模型计算混合长度请求下的完成时间和槽位利用率。
- 判断连续批处理何时最有收益,以及哪些瓶颈不会因为它自动消失。
静态批处理浪费在哪里
自回归生成会一轮一轮地产生 token。假设一次最多放两个请求,A 需要生成 6 个 token,B 只需要 2 个 token,C 需要 4 个 token。若采用简化的静态批处理,A 与 B 作为同一批启动后,B 在第 2 轮已经结束,但它占用的批次位置要等 A 完成后才会进入下一批。
这样一来,第 3~6 轮只有 A 在工作,另一个槽位处于空闲;等 A 完成后,C 才开始。混合长度越明显,短请求越多,这种“等待批次中最慢请求”的浪费越突出。
连续批处理如何补槽
Continuous Batching 把“批次”从固定请求集合变成每轮都可以更新的活动集合。B 在第 2 轮结束后,调度器立刻把 C 补进空槽;第 3 轮开始时,A 和 C 就能并行继续解码。请求不必等整个批次结束才进入或退出。
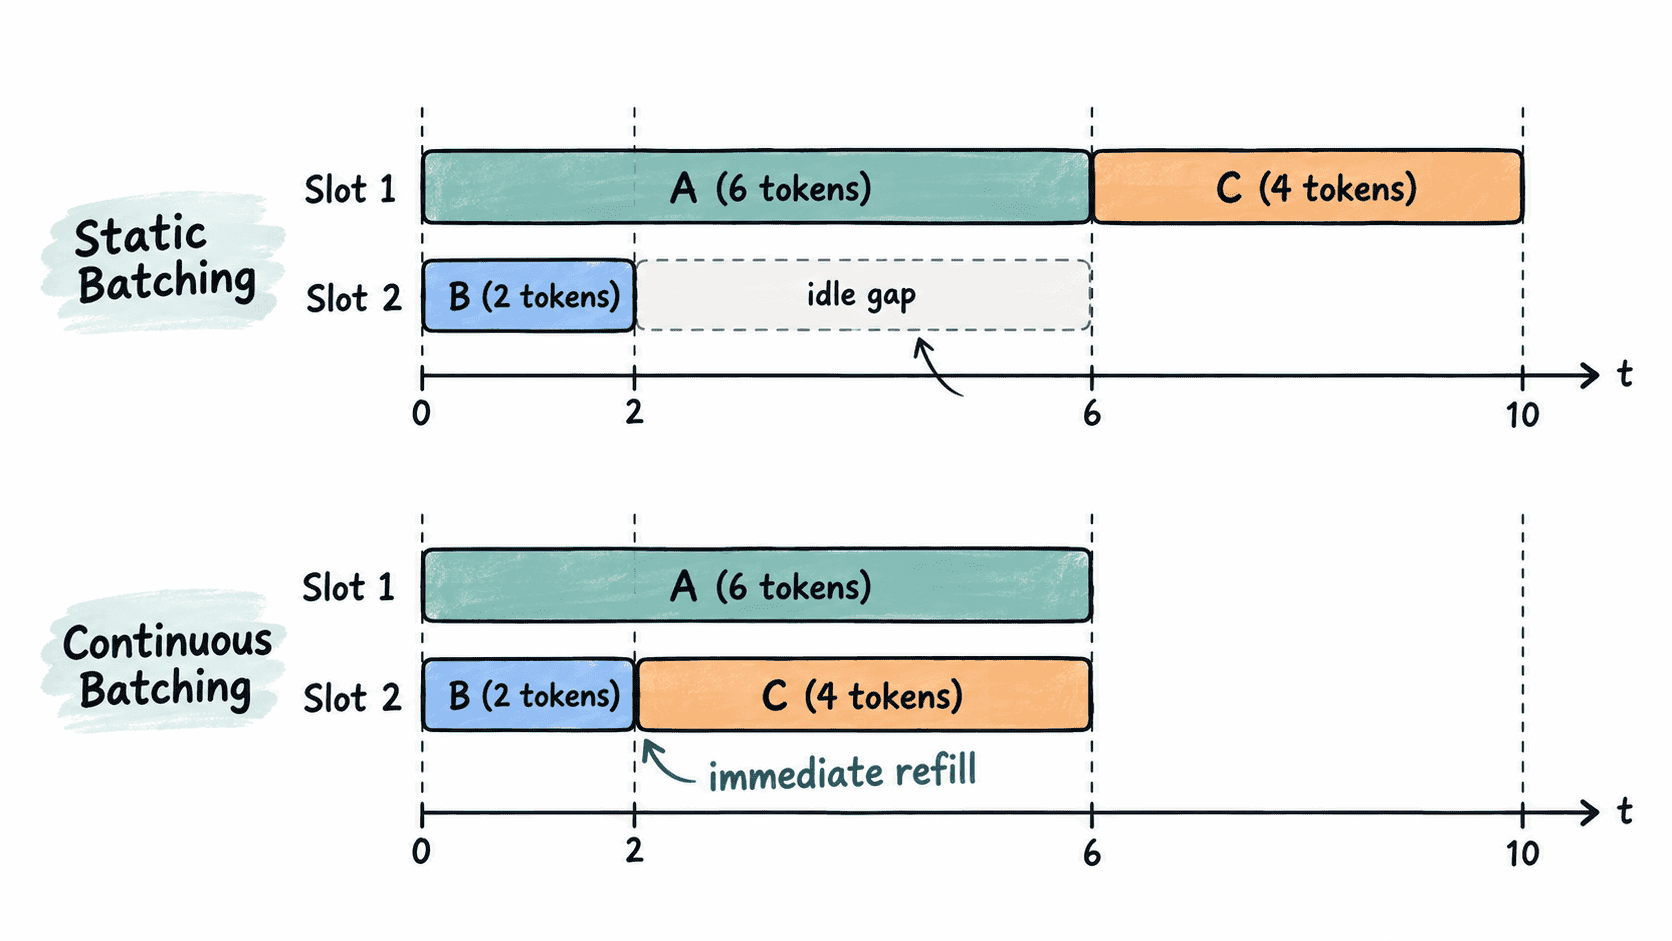
图中真正关键的不是“批大小更大”,而是槽位的生命周期变短:一个请求完成即可退出,一个等待请求即可加入,活动批次会随每轮解码动态变化。
用可运行模拟量化差异
下面的 Python 程序故意忽略真实推理中的 KV Cache、prefill、kernel 和调度开销,只保留“槽位能否即时补入”这个变量。三条请求的总工作量相同,因此完成时间和利用率差异完全来自调度方式。
from collections import deque

REQUESTS = [('A', 6), ('B', 2), ('C', 4)]
SLOTS = 2

def static_batch(requests):
    elapsed = 0
    active_steps = 0
    for i in range(0, len(requests), SLOTS):
        batch = requests[i:i + SLOTS]
        elapsed += max(tokens for _, tokens in batch)
        active_steps += sum(tokens for _, tokens in batch)
    utilization = active_steps / (elapsed * SLOTS)
    return elapsed, utilization

def continuous_batch(requests):
    waiting = deque(
        {'name': name, 'left': tokens}
        for name, tokens in requests
    )
    running = []
    elapsed = 0
    active_steps = 0

    while waiting or running:
        while waiting and len(running) < SLOTS:
            running.append(waiting.popleft())

        for req in running:
            req['left'] -= 1
            active_steps += 1

        elapsed += 1
        running = [req for req in running if req['left'] > 0]

    utilization = active_steps / (elapsed * SLOTS)
    return elapsed, utilization

for name, fn in [
    ('static', static_batch),
    ('continuous', continuous_batch),
]:
    elapsed, utilization = fn(REQUESTS)
    print(f'{name} makespan={elapsed} utilization={utilization:.1%}')
预期输出:
static makespan=10 utilization=60.0%
continuous makespan=6 utilization=100.0%
这个结果不是在预测某个具体推理引擎的真实性能,而是在隔离一个调度事实:相同 12 个 token-step 的工作量,静态批处理因为空槽产生了额外等待,连续批处理则把 C 提前填入空位,使两个槽位在这组请求中一直保持有效工作。
收益与边界
连续批处理最适合在线服务中的混合长度流量:请求到达时间不同、输出长度差异大,而且系统持续有等待请求可补入。此时它通常能提高 GPU 利用率和吞吐,并减少短请求被长请求拖住的排队浪费。
它也不是“无条件加速器”。如果流量很低,没有等待请求可补;如果瓶颈在 prefill、显存带宽、KV Cache 容量或通信链路,动态补槽只能解决其中一部分问题。调度器本身也有开销,因此真实评估仍要在目标并发度和真实长度分布下观察吞吐、P95 延迟、TTFT 与显存占用。
判断 Continuous Batching 是否有效,最重要的不是只看最大 batch size,而是看活动序列能否在请求完成时及时回收、等待请求能否快速进入,以及这种动态变化是否让 GPU 在目标流量下减少空转。