
大模型原理与训练 / 系统课时
传播超时与取消避免资源泄漏
传播超时与取消避免资源泄漏
推理请求一旦失去调用方,最昂贵的错误不是返回超时,而是 GPU 仍继续生成。本文把网关超时、客户端断开和服务端截止时间统一成取消信号,并验证排队任务与生成中任务都能及时回收。
学习目标
- 理解超时、断开与取消传播之间的关系
- 在入队与解码两个阶段检查取消状态
- 用可运行实验验证无效请求不会继续占用生成资源
把取消当成请求上下文的一部分
超时只是一种触发条件,真正要传播的是“这次请求已经没有继续计算的价值”。网关达到 deadline、客户端主动断开、服务端自己的最大执行时间到期,都应汇合成同一个取消状态,并沿着 API 层、调度队列一直传到推理引擎。
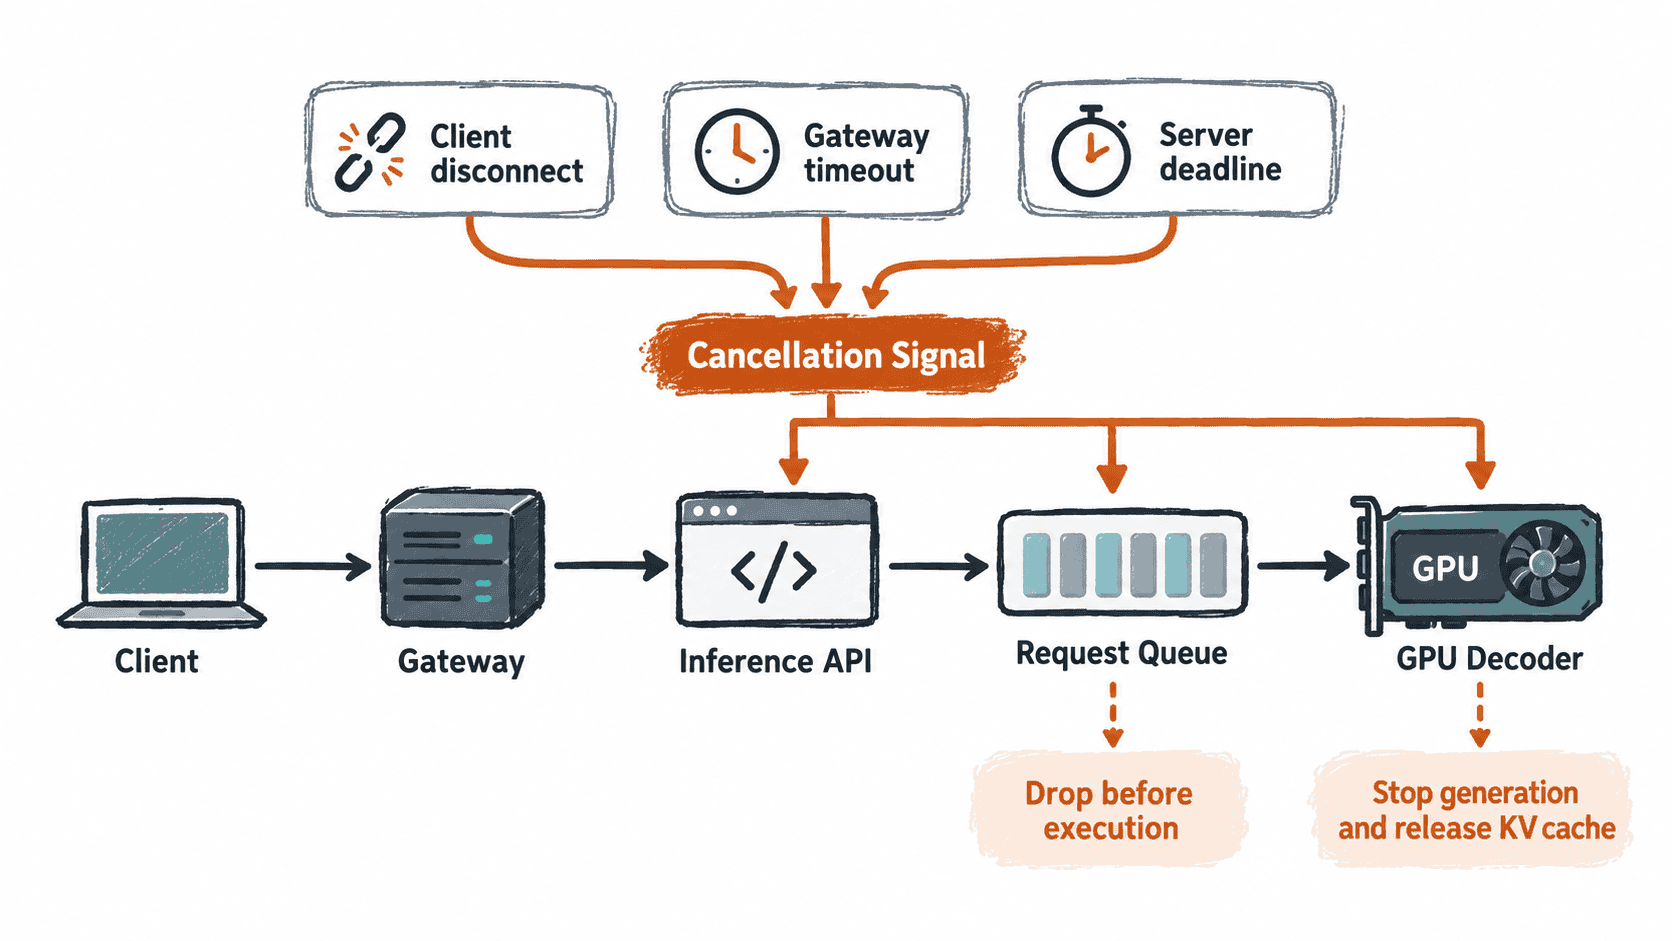
这里有两个必须检查取消状态的位置。出队前检查可以删除尚未执行的请求,避免它后来占用批次;生成循环内检查可以终止已经开始的序列,并尽快释放它对应的 KV Cache。只在 HTTP 层结束连接、返回超时状态或抛出异常,而不通知后端任务,资源泄漏仍然存在。
可运行的取消传播实验
下面用标准库 asyncio 模拟单个 GPU worker。submit() 的超时代表上游 deadline;超时后设置共享的 cancelled 事件。worker 在取出任务时检查一次,生成过程中每个 token 周期再检查一次。
import asyncio
from dataclasses import dataclass, field

@dataclass
class Job:
    job_id: str
    token_budget: int = 10
    cancelled: asyncio.Event = field(default_factory=asyncio.Event)
    done: asyncio.Event = field(default_factory=asyncio.Event)

async def generate(job: Job) -> None:
    for token_index in range(job.token_budget):
        if job.cancelled.is_set():
            print(f"{job.job_id}: stop at token {token_index}")
            return
        await asyncio.sleep(0.05)
    print(f"{job.job_id}: complete")

async def worker(queue: asyncio.Queue[Job]) -> None:
    while True:
        job = await queue.get()
        try:
            if job.cancelled.is_set():
                print(f"{job.job_id}: dropped before execution")
                continue
            print(f"{job.job_id}: start")
            await generate(job)
        finally:
            job.done.set()
            queue.task_done()

async def submit(queue: asyncio.Queue[Job], job: Job, timeout_s: float) -> None:
    await queue.put(job)
    try:
        await asyncio.wait_for(job.done.wait(), timeout=timeout_s)
    except asyncio.TimeoutError:
        job.cancelled.set()
        print(f"{job.job_id}: timeout -> cancel")
        await job.done.wait()

async def main() -> None:
    queue: asyncio.Queue[Job] = asyncio.Queue()
    worker_task = asyncio.create_task(worker(queue))

    blocker = Job("blocker", token_budget=8)
    await queue.put(blocker)
    await asyncio.sleep(0.02)

    await submit(queue, Job("queued"), timeout_s=0.10)
    await queue.join()

    await submit(queue, Job("running", token_budget=20), timeout_s=0.18)
    await queue.join()

    worker_task.cancel()
    try:
        await worker_task
    except asyncio.CancelledError:
        pass

asyncio.run(main())
预期输出
blocker: start
queued: timeout -> cancel
blocker: complete
queued: dropped before execution
running: start
running: timeout -> cancel
running: stop at token <TOKEN_INDEX>
<TOKEN_INDEX> 会随调度时机略有变化。关键结果有两个:queued 没有进入生成阶段,running 在达到完整 token_budget 前停止。
接入真实推理服务时的传播边界
API 层应为每个请求保存 deadline 与取消句柄。检测到客户端断开时立即触发同一取消句柄;网关与服务端的超时值不要彼此独立地“各等各的”,而应把剩余时间继续向下游传递。这样排队时间已经消耗掉的请求,不会在进入 GPU 后重新获得一整段超时预算。
批处理推理还要避免一个常见误区:取消某个 sequence 时,不应粗暴终止整个 batch。调度器应把该 sequence 标记为 finished,在安全点回收它的 KV block,其余仍有效的 sequence 继续生成。若底层引擎只支持整批取消,则需要缩短 batch 生命周期或使用支持逐请求取消的调度接口。
验证资源确实被回收
功能上看到客户端收到超时并不够。上线前至少观察三类指标:取消请求在队列中的残留数量、取消后继续生成的 token 数、KV Cache 或活跃 sequence 数是否在短时间内下降。若请求已经断开但 token 计数仍持续增长,说明取消只停在 HTTP 层。
压测时分别制造“排队期间断开”和“生成期间断开”两种场景,并确认它们都不会形成长期 GPU 占用。做到这一步,超时才真正从接口行为变成了资源治理机制。