
大模型原理与训练 / 系统课时
完成容量规划与故障演练
完成容量规划与故障演练
本节把“能跑”推进到“能扛峰值并能恢复”:先用真实 Token 分布、目标 SLO 和单实例压测基线换算 GPU 容量,再逐项注入实例退出、节点故障与网络退化,检查扩容、重调度和流量切换是否在可接受范围内完成。
学习目标
- 用峰值 QPS、Token 吞吐和单实例基线计算所需副本与 GPU 数量。
- 设计实例、节点和网络三类故障演练,并限制爆炸半径。
- 用延迟、错误率、排队深度和恢复时间判断扩缩容与流量切换是否达标。
把峰值流量换算成 GPU 容量
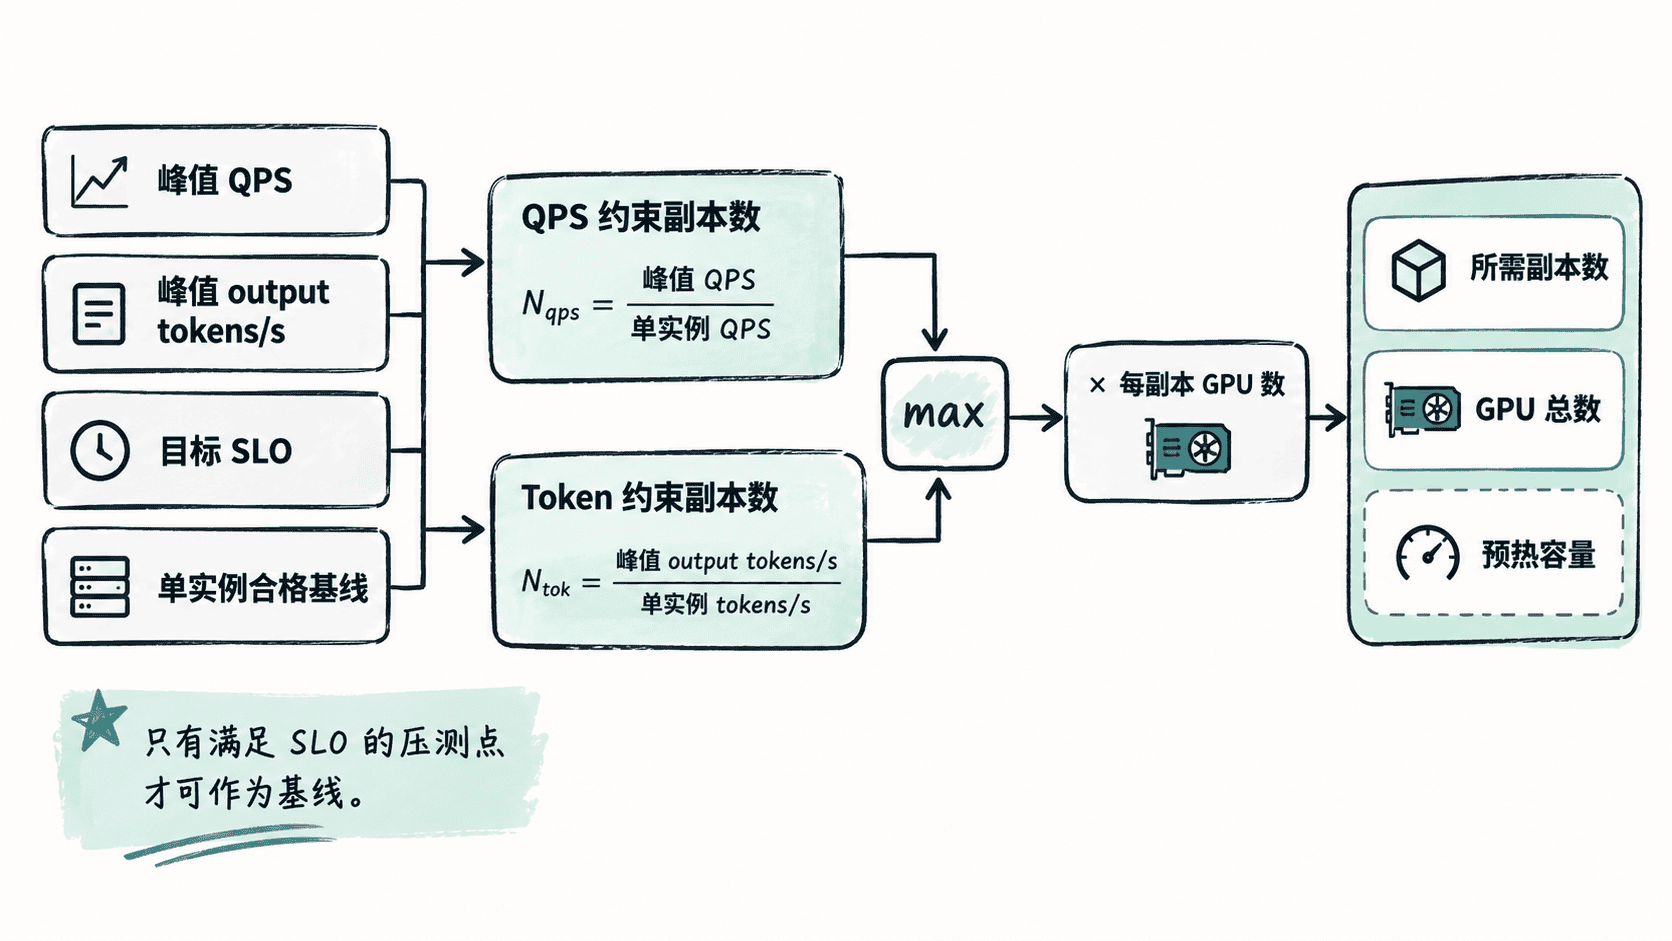
容量规划不能只看“每秒请求数”。大模型服务同时受请求速率和 Token 吞吐约束,输入还应来自与线上相同的 prompt/output Token 分布。先在目标模型、量化方式、并行策略和最大批处理参数不变的条件下,测出满足 SLO 时单实例可持续的 QPS 与 output tokens/s,再叠加容量余量。
设峰值请求速率为 、峰值输出 Token 速率为 、单实例合格基线分别为 与 、容量余量系数为 。分别向上取整计算请求约束与 Token 约束,最终副本数取两者较大值:
下面用一组可替换的压测数据计算。假设峰值为 18 QPS、峰值输出 5200 tokens/s,单实例在目标 SLO 内可持续 2.8 QPS 和 850 tokens/s,每个实例占 2 张 GPU,并预留 30% 容量。
import math

peak_qps = 18.0
peak_output_tps = 5200.0
instance_qps = 2.8
instance_output_tps = 850.0
headroom = 1.30
gpus_per_replica = 2

qps_replicas = math.ceil(peak_qps * headroom / instance_qps)
tps_replicas = math.ceil(peak_output_tps * headroom / instance_output_tps)
required_replicas = max(qps_replicas, tps_replicas)
required_gpus = required_replicas * gpus_per_replica
limiting_factor = "qps" if qps_replicas >= tps_replicas else "output_tps"

print(f"qps_replicas={qps_replicas}")
print(f"tps_replicas={tps_replicas}")
print(f"required_replicas={required_replicas}")
print(f"required_gpus={required_gpus}")
print(f"limiting_factor={limiting_factor}")
预期输出
qps_replicas=9
tps_replicas=8
required_replicas=9
required_gpus=18
limiting_factor=qps
真实规划时不要只代入平均 Token 数。应直接回放线上分布或至少覆盖 P50/P95 长度组合,否则长输出比例上升后,单实例的合格 QPS 会明显下降。若模型加载需要数分钟,还要把预热副本和扩容提前量纳入计划,不能假设 HPA 在峰值到来后才启动也来得及。
先定义演练的观测项和停止条件
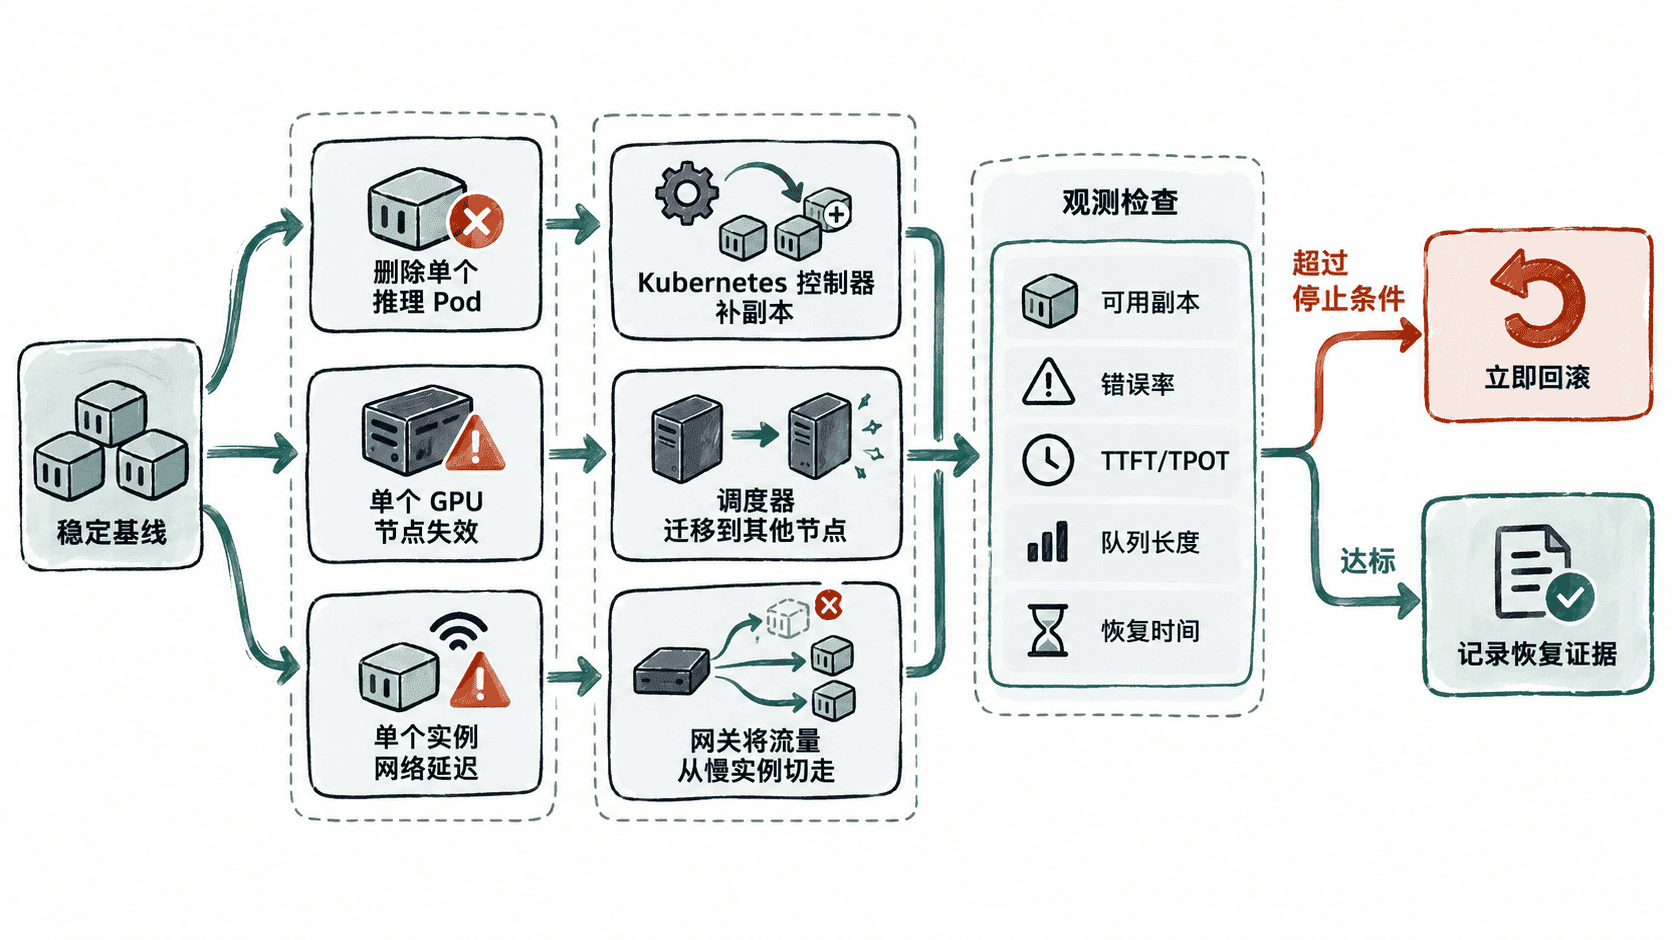
故障演练前先固定基线窗口,记录正常负载下的 TTFT、TPOT、端到端延迟、5xx/超时率、请求队列长度、GPU 利用率以及可用副本数。演练是否成功,应由“故障发生后这些指标多久恢复到既定 SLO”判定,而不是只看 Pod 最终是否重新变成 Running。
建议把停止条件写进演练单:错误率持续超过生产 SLO、健康副本低于安全下限、队列持续增长或第二个故障同时出现时立即终止注入。生产环境还应预先确认 PDB、拓扑分散、节点池冗余和备用流量路径都已生效。
注入实例退出并验证自愈
先从最小爆炸半径开始,只删除一个推理 Pod。命令中的命名空间和 Pod 名替换为当前环境实际值。
kubectl -n <NAMESPACE> delete pod <POD>
kubectl -n <NAMESPACE> get pods -l app=<APP> -o wide
预期结果
pod "<POD>" deleted
NAME              READY   STATUS    RESTARTS   AGE   IP         NODE
<NEW_POD>         1/1     Running   0          <TIME> <IP>     <NODE>
...
输出中的名称、时间、IP 和节点会因集群而不同。验证重点是:失效 Pod 能迅速从 Service 后端移除,新副本被创建并在 readiness 通过后重新接流量;整个窗口内错误率与尾延迟不得超过事先约定的容忍范围。若客户端仍把请求打到已退出实例,优先检查 readiness、连接复用与网关的摘除延迟,而不是继续扩大副本数。
注入节点故障并观察重调度
节点级演练要验证的不只是 Deployment 补副本,还包括 GPU 节点池是否有足够空闲容量、Pod 是否能调度到其他故障域,以及 PDB 是否会阻止一次性驱逐过多副本。可先用 drain 验证受控的重调度路径;真正的节点失联应在预生产或维护窗口通过基础设施层停机/断网进行。
kubectl cordon <NODE>
kubectl drain <NODE> --ignore-daemonsets --delete-emptydir-data --grace-period=30
kubectl -n <NAMESPACE> get pods -l app=<APP> -o wide
预期输出
node/<NODE> cordoned
node/<NODE> drained
NAME              READY   STATUS    RESTARTS   AGE   IP         NODE
<RESCHEDULED_POD> 1/1     Running   0          <TIME> <IP>     <OTHER_NODE>
...
如果 Pod 长时间处于 Pending,立即检查 GPU 资源余量、nodeSelector/affinity、污点容忍和拓扑约束。若只有同一节点池具备所需 GPU 型号,则“有副本数”并不等于“有故障容量”,容量规划必须把至少一个节点故障域的冗余算进去。
注入网络退化并验证流量切换
网络退化的目标是制造“实例还活着,但响应越来越慢”的灰色故障。不要临时给生产推理容器增加 NET_ADMIN;应使用平台已批准的混沌工具,在小比例目标上注入延迟或丢包。下面给出 Chaos Mesh 已安装时的配置片段示例,按标签只选中一个演练 Pod,并限制持续时间。
apiVersion: chaos-mesh.org/v1alpha1
kind: NetworkChaos
metadata:
  name: llm-serving-delay
  namespace: <NAMESPACE>
spec:
  action: delay
  mode: one
  selector:
    labelSelectors:
      app: <APP>
  delay:
    latency: "250ms"
    jitter: "50ms"
  duration: "2m"
生效行为与验证方法:应用后,仅一个匹配 Pod 的网络请求被额外注入约 250 ms 延迟并带少量抖动。观察网关或负载均衡器是否因为健康检查、异常探测或延迟策略把流量转向健康实例,同时确认总错误率、TTFT/TPOT 和队列长度没有越过停止条件;两分钟后规则应自动结束。若当前平台没有受控的网络混沌能力,应先在预生产补齐工具链,不要用不可审计的临时系统命令替代。
用验收表判断容量和恢复是否真的够用
一次完整演练至少留下四类证据:峰值负载下的 SLO 曲线、故障开始与恢复时间戳、调度/扩容事件、网关侧流量变化。容量结果要能解释“为什么需要这些 GPU”,故障结果则要回答“坏掉一部分后还能不能在目标时间内恢复”。
| 检查项 | 通过条件 |
|---|---|
| 峰值容量 | 回放目标 Token 分布时,TTFT、TPOT、错误率和队列均满足既定 SLO |
| 实例退出 | 单 Pod 退出后,后端摘除、补副本和流量恢复在目标时间内完成 |
| 节点故障 | 单节点不可用后仍有可调度 GPU,副本迁移到其他节点或故障域 |
| 网络退化 | 慢实例被降权或摘流,健康实例承接流量且没有持续排队 |
| 容量余量 | 故障期间仍保留必要冗余,不依赖所有 GPU 同时健康才能达标 |
最终应把“峰值所需副本数”和“单节点/单实例故障时仍需满足的最低健康副本数”一起写入容量基线。这样扩容策略、节点池规模和故障演练使用的是同一组约束,避免平时压测能过、真正少一台机器就立刻失去 SLO。