
大模型原理与训练 / 系统课时
用数据并行扩展服务副本
用数据并行扩展服务副本
当单个推理实例已经能稳定服务后,最直接的扩容方式是复制完整模型,让多个副本同时接收请求。本篇把副本级路由与副本内部动态批处理放到同一条链路分析,避免“副本越多吞吐越高”的误判,并给出识别冷热副本与流量倾斜的方法。
学习目标
- 区分全局负载均衡与单副本内部批处理各自负责的问题。
- 估算增加副本后每个批处理窗口还能积累多少请求,避免批次被过度稀释。
- 使用队列、负载与缓存信号识别热点副本,并设计更稳健的路由策略。
两层调度必须一起看
数据并行服务中,每个副本都持有完整模型,副本之间通常不需要为一次前向传播同步参数。全局路由器先决定请求进入哪个副本,随后该副本自己的调度器再把等待请求组成动态批次。因此,前者决定“流量是否均匀”,后者决定“单卡是否能形成高效批次”。
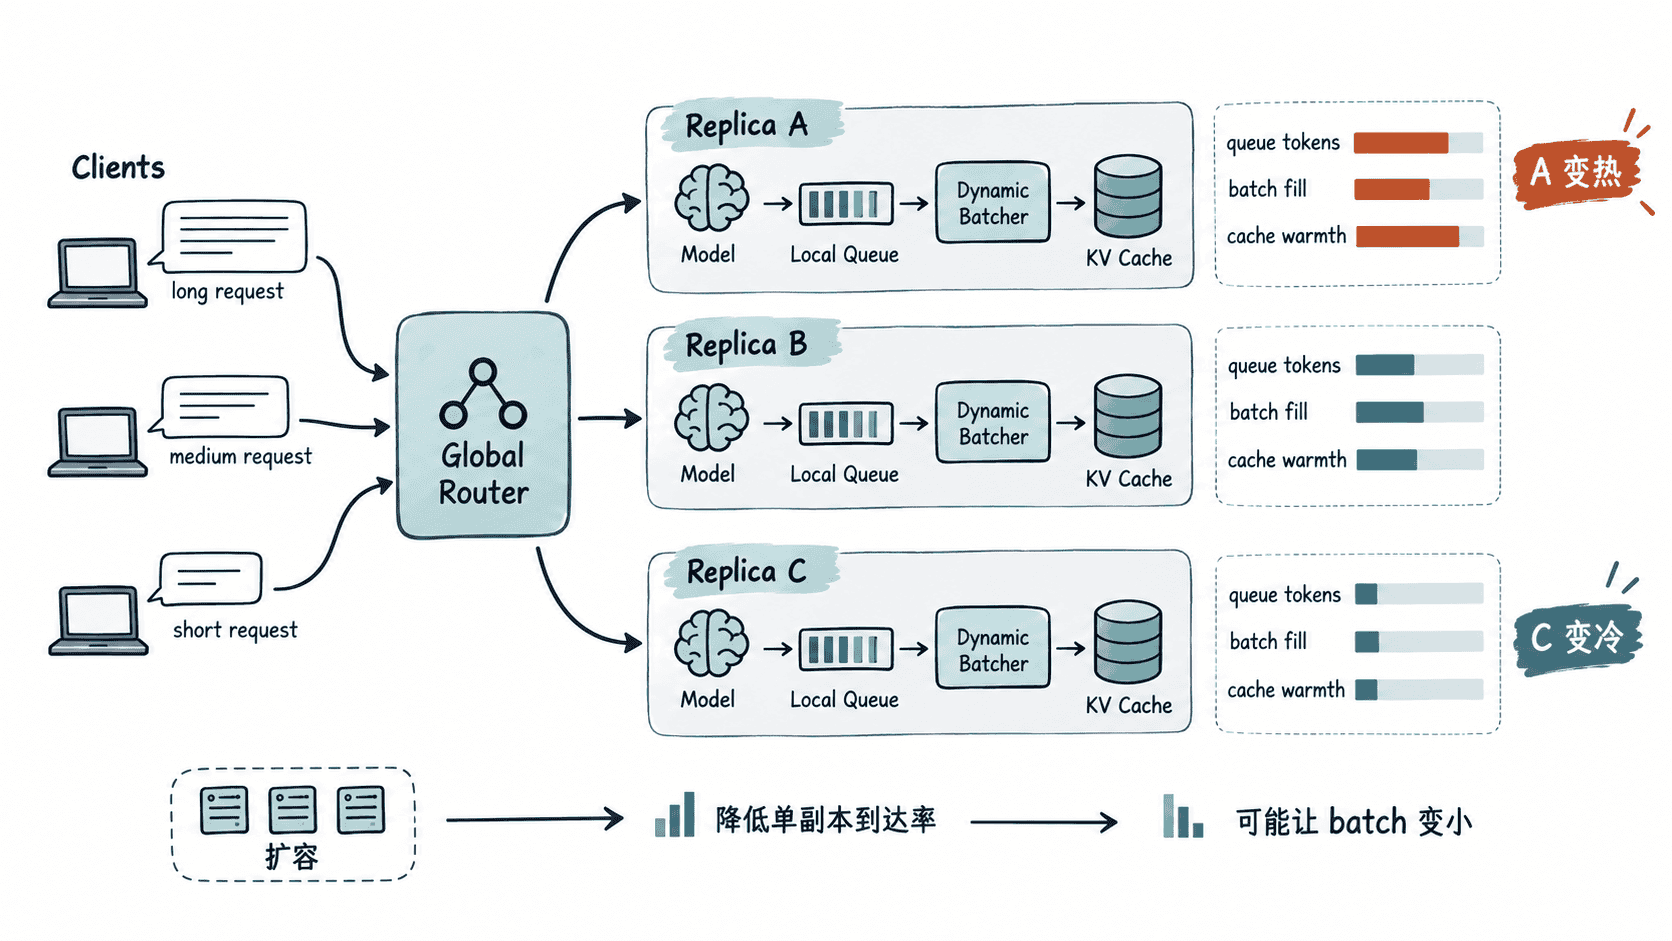
如果路由器只追求请求数平均,却忽略请求长度、正在生成的 token 数和流式连接持续时间,三个“各收到 10 个请求”的副本也可能拥有完全不同的实际负载。反过来,即使路由非常均匀,副本数量过多也会把到达流量切得太碎,使每个本地批处理器长期凑不满目标批次。
估算扩容会不会稀释批次
可以先用一个简单容量估算判断副本数是否过多。若总到达率为 个请求每秒,批处理等待窗口为 秒,副本数为 ,理想均匀路由下每个副本在一个窗口内平均收到约 个请求。这个均值不是实际批次大小保证,但能快速识别明显不合理的扩容方案。
下面的脚本比较同一流量在不同副本数下的理论批次填充程度。
arrival_rps = 1200
batch_window_ms = 20
target_batch = 8

for replicas in [1, 2, 4, 8]:
    expected = arrival_rps * (batch_window_ms / 1000) / replicas
    fill = min(expected / target_batch, 1.0)
    print(
        f"replicas={replicas}, expected_per_window={expected:.1f}, "
        f"estimated_fill={fill:.1%}"
    )
预期输出:
replicas=1, expected_per_window=24.0, estimated_fill=100.0%
replicas=2, expected_per_window=12.0, estimated_fill=100.0%
replicas=4, expected_per_window=6.0, estimated_fill=75.0%
replicas=8, expected_per_window=3.0, estimated_fill=37.5%
在这个理想化例子中,从 4 个副本扩到 8 个副本会把窗口内平均到达量从 6 个请求降到 3 个,请求虽然更分散,单副本却更难形成大批次。若 GPU 主要依赖批处理提升吞吐,盲目扩容可能让集群总利用率反而下降。
避免冷热副本与流量倾斜
最基础的 Round Robin 只适合请求成本相近、连接生命周期短的流量。大模型请求差异通常更大:长 Prompt 会占用更长 Prefill 时间,长输出会长期占据 Decode 槽位,流式连接也会让“当前连接数”与“剩余工作量”不一致。
更稳健的路由器应至少观测副本当前排队请求数、排队 token 数、活跃序列数和近期吞吐,再把新请求送往负载较低的健康副本。若系统依赖 Prefix/KV Cache 复用,还可以加入会话或前缀亲和性,但亲和规则必须带负载上限和回退路径,否则命中率提高的同时可能制造单点热点。
扩容后的验收方式
扩容不是只确认新副本健康,而要比较扩容前后的服务效率。至少同时观察每个副本的请求到达率和排队 token 是否接近、平均与 P95 批次大小是否明显下降、TTFT 与 TPOT 是否改善,以及整体 tokens/s 是否随副本数近似增长。
当新副本刚启动时,还要考虑模型加载、编译或图捕获、内存池建立和缓存预热。路由器应等副本真正 ready 后再放量,并采用渐进权重或短暂预热,避免刚上线的冷副本立即承接与成熟副本相同的流量。下线时则先停止接收新请求,再等待已有流式请求排空。
数据并行扩容的核心不是“复制更多模型”,而是保持每个副本都有足够且相近的有效工作。只有全局路由没有倾斜、本地批处理没有被稀释、冷启动过程也被纳入调度,新增 GPU 才会稳定转换成可见的吞吐增益。