
大模型原理与训练 / 系统课时
按队列和时延设计自动扩缩容
按队列和时延设计自动扩缩容
大模型推理实例即使 CPU 很闲,也可能已经被 KV Cache、批处理槽位或 GPU 计算压满。本节把扩缩容信号改为队列、TTFT、并发与 GPU 利用率,并把冷启动、缩容排空和防震荡一起纳入控制环,最终得到一套可在 Kubernetes 上执行的扩缩容策略。
学习目标
- 用队列长度与 TTFT 作为面向用户体验的主扩容信号。
- 用并发和 GPU 利用率补充容量判断,并理解多指标共同驱动扩容的方式。
- 为模型冷启动、缩容排空和指标波动设置稳定窗口,避免频繁震荡。
先让指标代表真正的容量压力
推理服务的 CPU 利用率通常不是最早出现的瓶颈。请求已经开始排队时,CPU 可能仍然很低;相反,模型加载、Tokenizer 或日志线程又可能让 CPU 短时升高,却不代表需要更多 GPU 实例。因此扩容信号应优先回答“用户是否开始等待”和“单个副本还能接多少请求”。
队列长度适合做最直接的容量信号:只要等待请求持续增加,就说明现有批处理槽位来不及消化流量。TTFT 则直接约束首 Token 体验,可用于捕获“队列还不长,但 Prefill 已变慢”的情况。活跃序列数反映每个实例正在承载的并发,GPU 利用率用于确认设备是否接近持续饱和。
这四类指标不要简单求平均。生产上更稳妥的做法是让每个指标独立计算所需副本数,再采用更激进的扩容建议;缩容则必须额外经过稳定窗口和排空约束。这样队列或 TTFT 任一恶化都能触发扩容,而低 GPU 利用率不会把仍在处理长请求的实例过早缩掉。
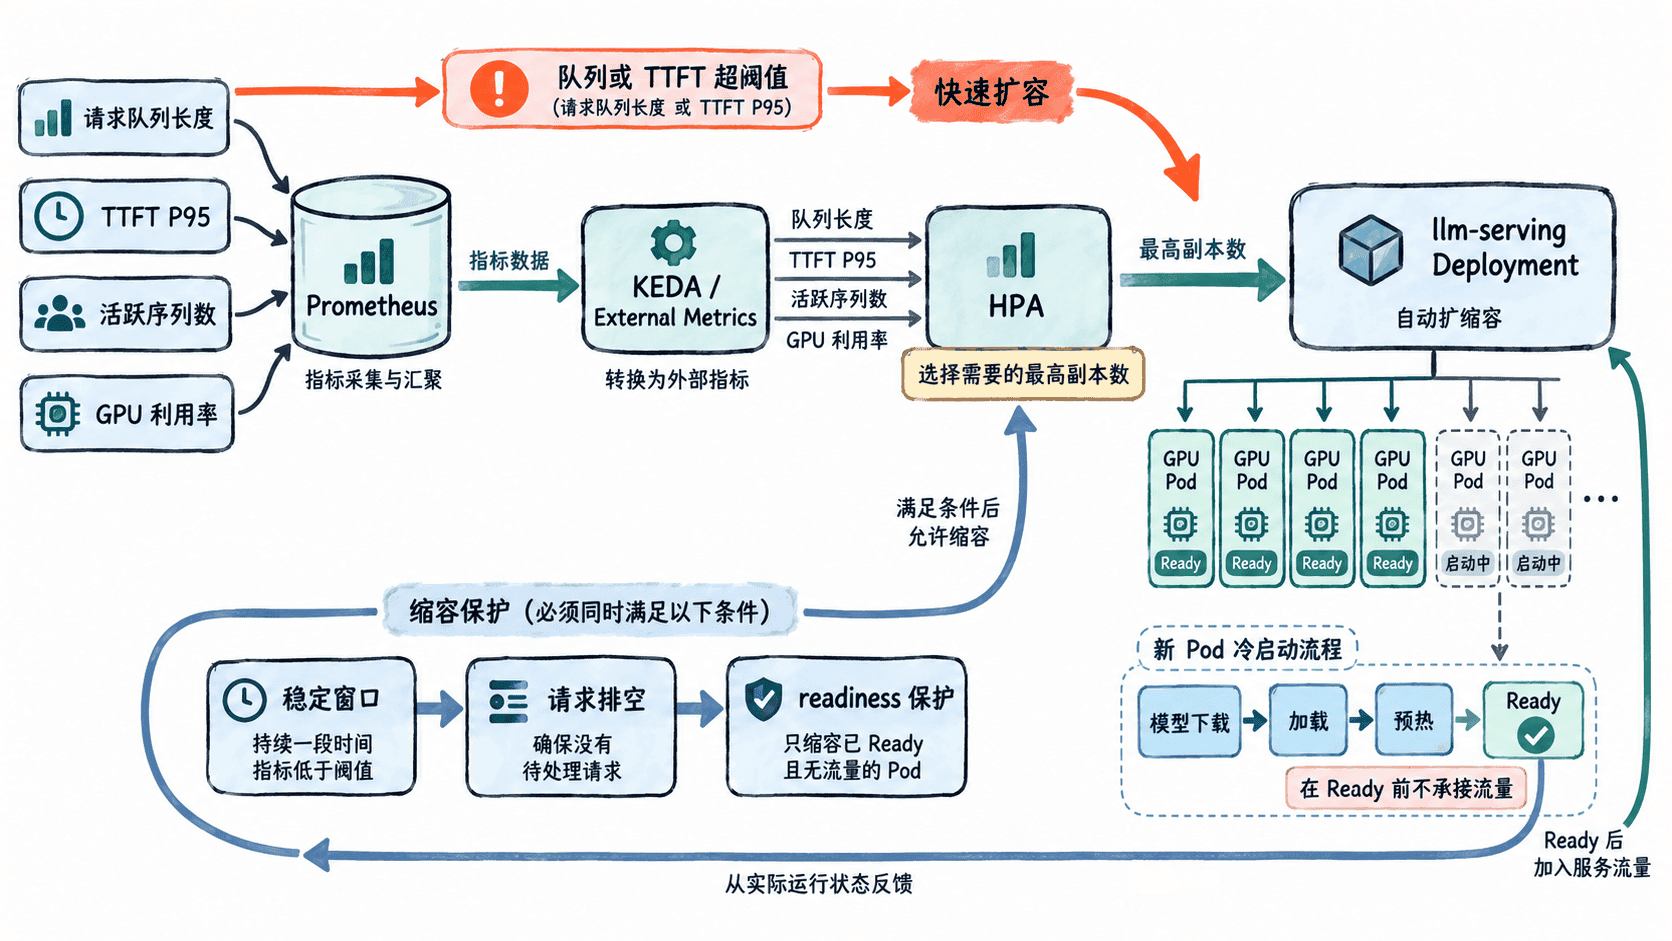
配置多信号扩缩容
下面假设命名空间 inference 中已有名为 llm-serving 的 Deployment,KEDA 已安装,并且 Prometheus 能查询示例中的四个指标。队列与活跃序列使用 AverageValue,让目标值表达“每个副本可承受的平均压力”;TTFT 和 GPU 利用率使用 Value,用于在体验或设备饱和度越过阈值时放大副本需求。
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: llm-serving-autoscaler
  namespace: inference
spec:
  scaleTargetRef:
    name: llm-serving
  pollingInterval: 15
  cooldownPeriod: 600
  minReplicaCount: 2
  maxReplicaCount: 16
  advanced:
    horizontalPodAutoscalerConfig:
      behavior:
        scaleUp:
          stabilizationWindowSeconds: 0
          policies:
            - type: Percent
              value: 100
              periodSeconds: 60
            - type: Pods
              value: 2
              periodSeconds: 60
          selectPolicy: Max
        scaleDown:
          stabilizationWindowSeconds: 600
          policies:
            - type: Pods
              value: 1
              periodSeconds: 120
          selectPolicy: Min
  triggers:
    - type: prometheus
      name: queue-depth
      metricType: AverageValue
      metadata:
        serverAddress: http://prometheus.monitoring.svc:9090
        query: sum(llm_queue_depth{service="llm-serving"})
        threshold: "4"
    - type: prometheus
      name: ttft-p95
      metricType: Value
      metadata:
        serverAddress: http://prometheus.monitoring.svc:9090
        query: histogram_quantile(0.95, sum by (le) (rate(llm_ttft_seconds_bucket{service="llm-serving"}[2m])))
        threshold: "1.5"
    - type: prometheus
      name: active-sequences
      metricType: AverageValue
      metadata:
        serverAddress: http://prometheus.monitoring.svc:9090
        query: sum(llm_active_sequences{service="llm-serving"})
        threshold: "24"
    - type: prometheus
      name: gpu-utilization
      metricType: Value
      metadata:
        serverAddress: http://prometheus.monitoring.svc:9090
        query: avg(llm_gpu_utilization_ratio{service="llm-serving"})
        threshold: "0.85"
这组阈值只是容量规划的起点,必须用压测结果校准。例如单卡在 24 条活跃序列时是否仍满足 TTFT SLO,应由目标模型、最大上下文、量化方式和批处理策略共同决定。若 GPU 利用率指标是 0~100 的百分数而不是 0~1 的比例,阈值也应相应改成 85。
首次创建资源时,可执行:
kubectl create -f llm-autoscale.yaml预期输出:
scaledobject.keda.sh/llm-serving-autoscaler created随后观察 KEDA 创建的 HPA、队列曲线与 TTFT 曲线。压测时如果队列持续高于每副本 4 个请求,或 TTFT P95 持续超过 1.5 秒,期望副本数应向上增长;指标恢复后不会立即缩容,而是先经过 600 秒稳定窗口。
把冷启动和排空时间算进控制环
GPU Pod 从创建到真正可服务,往往还要经历调度、镜像拉取、模型权重加载、显存分配和一次或多次预热。扩容如果只在 TTFT 已严重恶化后才触发,新副本尚未 Ready,排队还会继续增长。因此应把“从触发扩容到 readiness 通过”的 P95 时间测出来,并据此保留足够的 minReplicaCount 或更早的队列阈值。
缩容的风险相反:Pod 可能仍在生成长响应。应让 readiness 在排空开始时先摘除新流量,再通过应用的优雅关闭逻辑等待在途请求完成,并把 terminationGracePeriodSeconds 设得不短于典型长请求的排空时间。上例每 120 秒最多缩 1 个 Pod,再叠加 600 秒稳定窗口,就是在牺牲一点空闲成本换取更低的抖动概率。
用压测验证而不是凭阈值上线
验收时至少做一次阶跃流量测试:从稳定流量突然提升到目标峰值,记录队列开始增长、扩容被触发、新 Pod Ready、TTFT 恢复这四个时间点。若 TTFT 在新副本 Ready 前已经越过不可接受区间,应优先降低扩容阈值、提高保底副本数或缩短模型启动链路,而不是继续调高最大副本数。
再做一次反向测试,把流量恢复到低位并保留少量长请求,确认旧 Pod 会先停止接收新请求,再完成在途请求后退出。只有“扩得够早、缩得够慢、Pod 能排空”三件事同时成立,自动扩缩容才真正适合大模型推理服务。