
大模型原理与训练 / 系统课时
用 vLLM 暴露兼容推理接口
用 vLLM 暴露兼容推理接口
这一节把单卡上的模型封装成统一 HTTP 服务,并逐项验证模型列表、Chat Completions、SSE 流式返回与并发请求。完成后,应用接入和后续压测都可以复用同一个模型名、端口和接口路径,不再依赖本地 Python 调用。
学习目标
- 用
vllm serve启动 OpenAI 兼容服务并确认对外模型名。 - 用
/v1/chat/completions验证普通响应与流式响应。 - 用并发请求确认统一 HTTP 路径能够被应用和压测工具复用。
启动服务并确认模型名
示例使用 Qwen/Qwen2.5-0.5B-Instruct 和本机 8000 端口。模型首次使用时可能需要下载权重;如果你已经有本地模型,可以把模型 ID 替换为实际路径。为避免误暴露服务,这里只监听 127.0.0.1。
MODEL=Qwen/Qwen2.5-0.5B-Instruct
PORT=8000

vllm serve "$MODEL" \
  --host 127.0.0.1 \
  --port "$PORT" >vllm.log 2>&1 &
PID=$!
READY=0

for _ in $(seq 1 600); do
  if curl -fsS "http://127.0.0.1:$PORT/v1/models" >/dev/null; then
    READY=1
    break
  fi
  sleep 1
done

if [ "$READY" -eq 1 ]; then
  echo "READY pid=$PID"
else
  echo "server not ready" >&2
  kill "$PID" 2>/dev/null || true
fi
预期输出
READY pid=<ID><ID> 是后台进程号,实际值每次不同。服务就绪后,用模型列表接口读取真正对外暴露的名称;后续请求的 model 字段必须与它一致。
curl -fsS http://127.0.0.1:8000/v1/models \
| python -c 'import json,sys; print([m["id"] for m in json.load(sys.stdin)["data"]])'
预期输出
['Qwen/Qwen2.5-0.5B-Instruct']验证 Chat Completions
普通 Chat Completions 请求先验证三件事:HTTP 请求成功、响应中的模型名正确、至少返回一个非空 assistant 内容。这里不把自然语言答案写死,因为不同权重和版本的具体文本可能不同。
curl -fsS http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen2.5-0.5B-Instruct","messages":[{"role":"user","content":"只回答 OK"}],"temperature":0,"max_tokens":8}' \
| python -c 'import json,sys; d=json.load(sys.stdin); print(d["model"]); print(len(d["choices"]) == 1); print(bool(d["choices"][0]["message"]["content"]))'
预期输出
Qwen/Qwen2.5-0.5B-Instruct
True
True
如果这里报模型不存在,优先重新检查 /v1/models 的返回值;如果提示 chat template 相关错误,则说明当前模型或 tokenizer 没有可用于聊天消息的模板,应改用具备聊天模板的指令模型,或显式提供正确模板。
验证流式与并发路径
流式请求仍使用同一个 /v1/chat/completions,区别只是把 stream 设为 true。客户端会收到多条 SSE data: 事件,最后以 [DONE] 结束。
curl -N -s http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen/Qwen2.5-0.5B-Instruct","messages":[{"role":"user","content":"用一句话说明什么是 GPU"}],"temperature":0,"max_tokens":24,"stream":true}' \
| grep '^data:' \
| tail -n 2
预期输出
data: <最后一个 JSON 事件,内容和 ID 会变化>
data: [DONE]
接着用四个并发请求只检查 HTTP 状态码。返回顺序可能不同,因此验收条件不是行序,而是四条记录都为 200。
seq 1 4 | xargs -I{} -P4 sh -c '
curl -s -o /dev/null \
  -w "request={} status=%{http_code}\n" \
  http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"Qwen/Qwen2.5-0.5B-Instruct\",\"messages\":[{\"role\":\"user\",\"content\":\"回答数字 {}\"}],\"temperature\":0,\"max_tokens\":8}"
'
预期输出
request=1 status=200
request=2 status=200
request=3 status=200
request=4 status=200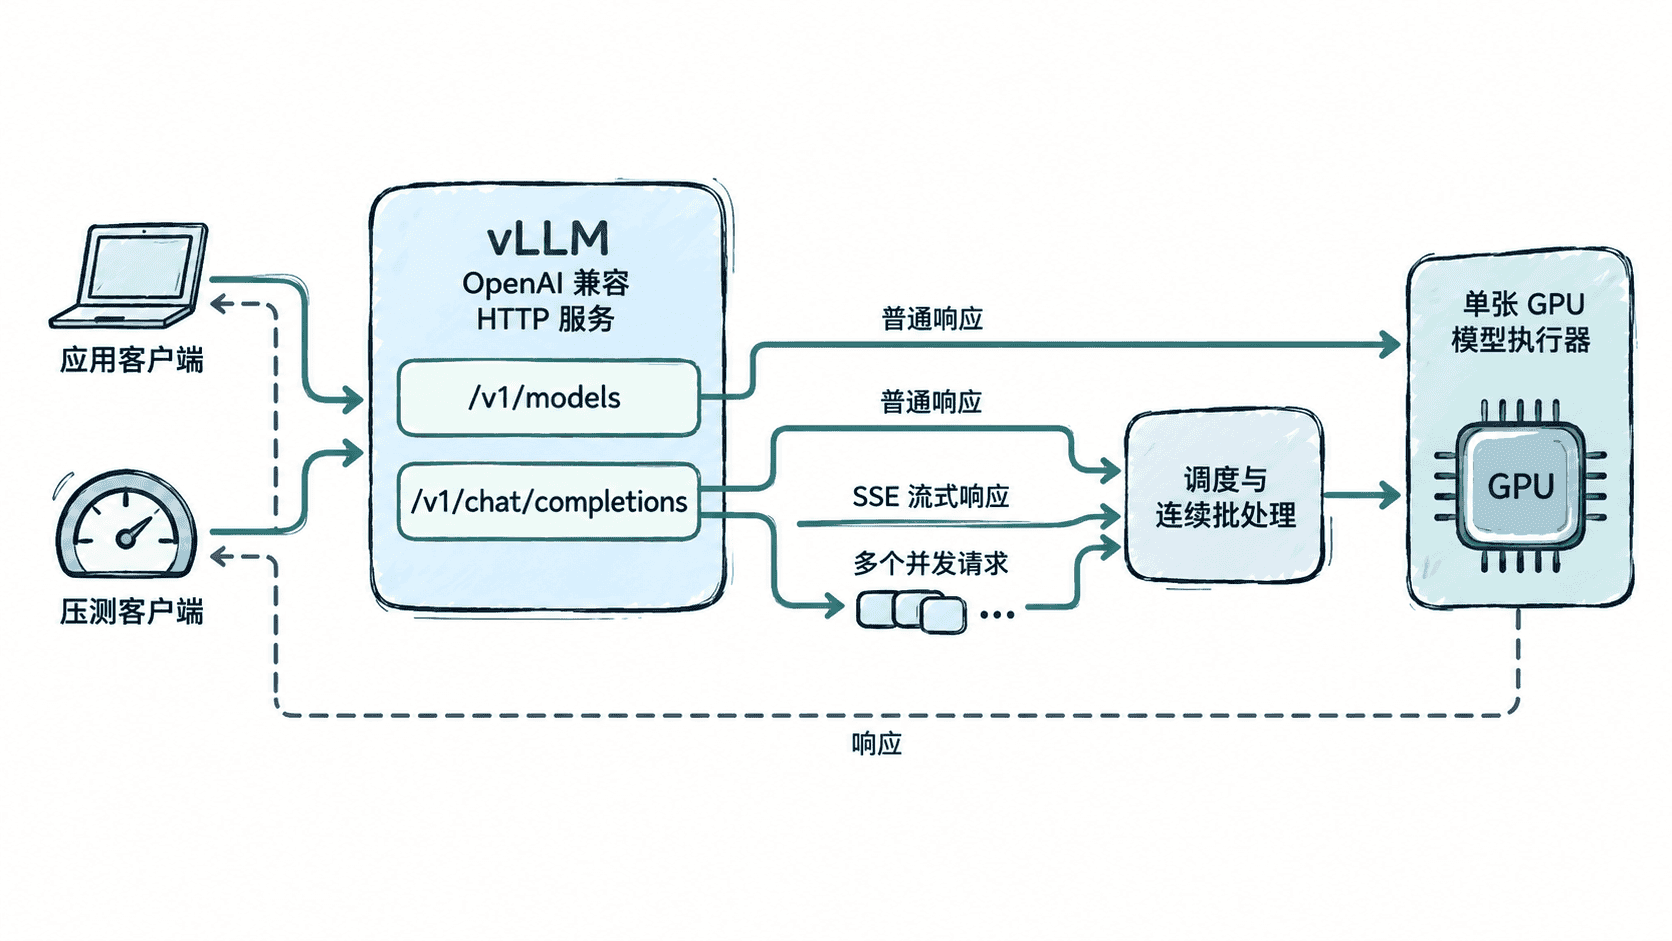
固定应用接入边界
应用侧最好只把三个值做成配置:base_url、model 和必要的认证信息。接口一旦通过上述四项验收,后续压测、SDK 接入和业务服务都应复用同一入口,避免一部分请求走本地推理、另一部分走 HTTP,导致指标无法比较。
并发四请求全部成功只说明请求路径可用,不代表服务已经达到安全容量。真正的并发上限还要结合 TTFT、TPOT、吞吐、错误率和显存占用测量;这些性能指标应在固定输入输出长度与并发度的条件下建立基线。