
大模型原理与训练 / 系统课时
用 GPU 指标定位资源浪费
用 GPU 指标定位资源浪费
GPU 指标只有和请求吞吐、批次大小、队列状态放到同一时间轴上才有诊断价值。本篇给出一套最小采集与判读方法,用组合信号区分低批次、空转、降频和跨卡通信瓶颈,并用服务指标验证优化是否真正生效。
学习目标
- 采集 GPU 利用率、显存、功耗、温度、时钟与互联吞吐等核心指标
- 将 GPU 指标与 QPS、批次大小和延迟对齐,识别常见资源浪费模式
- 用前后对照验证优化是否提高吞吐且没有破坏延迟目标
先把硬件指标放到请求时间轴
单看 GPU-Util 很容易误判。推理服务至少要把请求层、调度层和 GPU 层按相同采样周期对齐,通常从 1 秒粒度开始,再按问题需要缩短窗口。
| 证据层 | 建议指标 | 主要回答的问题 |
|---|---|---|
| 请求 | QPS、输入/输出 token、P95/P99、TTFT、TPOT | 负载是否变化,慢在首 token 还是持续解码 |
| 调度 | pending 请求、batch size、queue time | GPU 低利用是否只是批次太小或调度断档 |
| GPU 核心 | utilization、SM clock、power、temperature | 是否真正忙碌,是否被功耗或温度限制 |
| 显存 | used/total、KV Cache 占用 | 是否有容量压力,扩批是否还有空间 |
| 互联 | PCIe/NVLink Rx/Tx bytes/s | 多卡吞吐是否被跨卡同步与传输限制 |
采集一组足够的 GPU 证据
下面的命令连续采样 5 次常用 GPU 指标,每秒一次。它适合先确认利用率、显存、功耗、温度和时钟是否与请求波动同步。
for i in 1 2 3 4 5; do nvidia-smi --query-gpu=timestamp,index,uuid,utilization.gpu,memory.used,memory.total,power.draw,temperature.gpu,clocks.sm,clocks.mem --format=csv,noheader,nounits; sleep 1; done预期输出(实际时间、设备 ID 和数值会不同):
<TIME>, 0, <GPU_UUID>, <GPU_UTIL>, <MEM_USED_MIB>, <MEM_TOTAL_MIB>, <POWER_W>, <TEMP_C>, <SM_CLOCK_MHZ>, <MEM_CLOCK_MHZ>
<TIME>, 0, <GPU_UUID>, <GPU_UTIL>, <MEM_USED_MIB>, <MEM_TOTAL_MIB>, <POWER_W>, <TEMP_C>, <SM_CLOCK_MHZ>, <MEM_CLOCK_MHZ>
...
如果服务使用多卡,还要采集 PCIe 或 NVLink 的收发字节并换算为 bytes/s。DCGM Exporter、Nsight Systems 等工具都能提供这类证据;不同版本的字段名可能不同,应以实际 /metrics 或采集器输出为准,再对单调字节计数计算速率。
用组合信号识别资源浪费
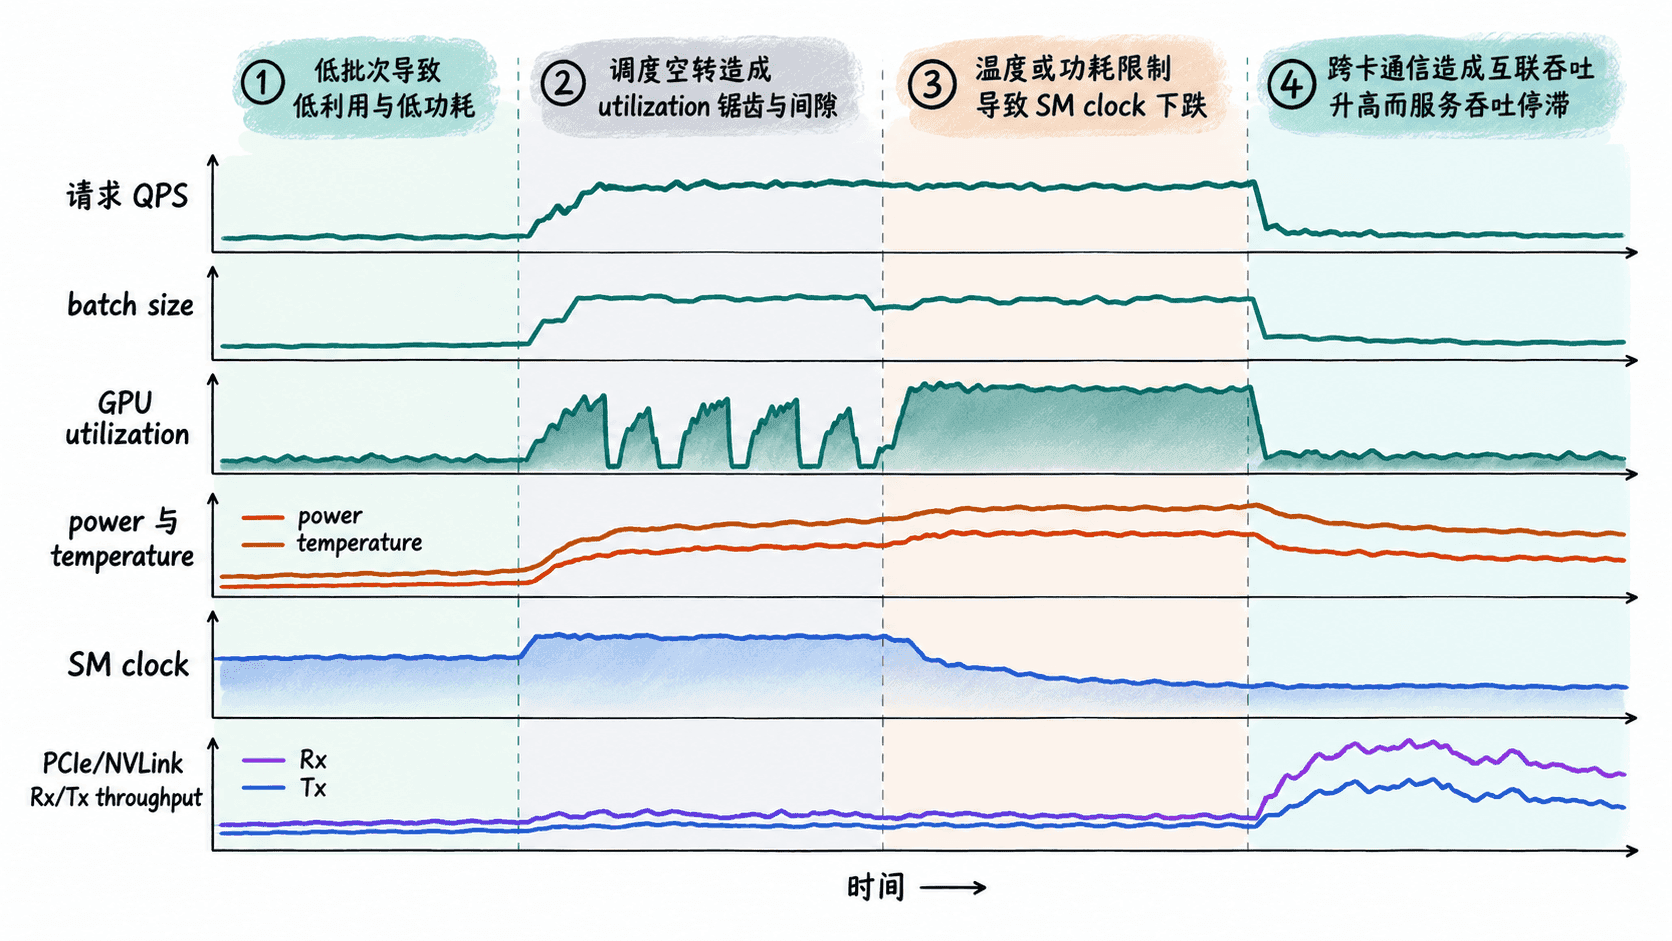
低批次通常表现为 batch size 长期很小、GPU 利用率和功耗都偏低,同时请求队列接近空。此时 GPU 没有被喂饱,优先检查 continuous batching、最大并发序列数和请求合批策略,而不是先换更快的 GPU。
空转更常见于队列里明明有请求,但 GPU 利用率呈周期性锯齿并出现明显空洞。根因可能在 CPU 分词、调度循环、Host-to-Device 拷贝或同步点,应该继续对齐 queue time、CPU 使用率和批次形成时间。
降频要同时看温度、功耗与 SM clock。若利用率仍高,但温度或功耗接近限制值且 SM clock 明显下降,吞吐会在高负载下反而变差。修复方向是散热、功耗上限、时钟策略与机箱供电,而不是继续增大 batch。
跨卡通信瓶颈常见于张量并行。若单卡利用率波动、多卡吞吐随 batch 增长很快进入平台期,同时 PCIe/NVLink 收发速率持续升高,应检查并行度、GPU 拓扑和 collective 开销。此时“GPU 很忙”并不代表计算效率高,时间可能花在等待同步上。
用服务结果验证优化
每次调参都要固定模型、精度、并行方式和请求分布,再比较相同负载下的吞吐与延迟。至少记录请求吞吐、输出 tokens/s、TTFT、TPOT、P95/P99,以及对应的 batch size 和 GPU 指标。
一个有效优化通常会同时出现两类证据:服务吞吐上升或延迟下降,以及 GPU 利用方式更合理,例如空洞减少、时钟稳定、跨卡通信占比下降。若只是 GPU 利用率从 60% 升到 95%,但 tokens/s 没变甚至 P99 变差,这不是性能优化,而只是把更多硬件时间消耗在无效工作上。