
大模型原理与训练 / 系统课时
搭建多节点 GPU 推理服务
搭建多节点 GPU 推理服务
跨节点 Serving 最容易出现“进程都启动了,但 GPU、权重和网络并没有按预期组成一个整体”的问题。本节以两台各 4 卡的节点为例,用 Ray 负责节点发现与进程调度,用 NCCL 承担模型并行通信,并把验证重点放在权重加载、Rank 拓扑和故障一致退出上。
学习目标
- 设计两节点 8 GPU 的进程拓扑,并区分控制面与模型通信数据面
- 配置 GPU 可见性、Ray 节点发现和 vLLM 分布式启动
- 验证权重加载、跨节点高速网络路径以及 Rank 故障后的整体行为
先设计进程与网络拓扑
假设有 node-a 和 node-b 两台服务器,每台 4 张 GPU。一个更稳妥的初始拓扑是让 Tensor Parallel 规模为 4,使高频张量集合通信尽量留在单机内部,再用 Pipeline Parallel 规模为 2 跨两台机器连接阶段。这样总 World Size 为 8,同时避免一开始就让 TP All-Reduce 频繁跨机。
Ray 在这里主要负责节点发现、资源登记和 Worker 调度;真正的模型并行数据仍由 NCCL 等通信库传输。两类网络不要混淆:Ray 能看到两台机器,并不等于 NCCL 已经走上预期的 InfiniBand、RoCE 或专用高速以太网。
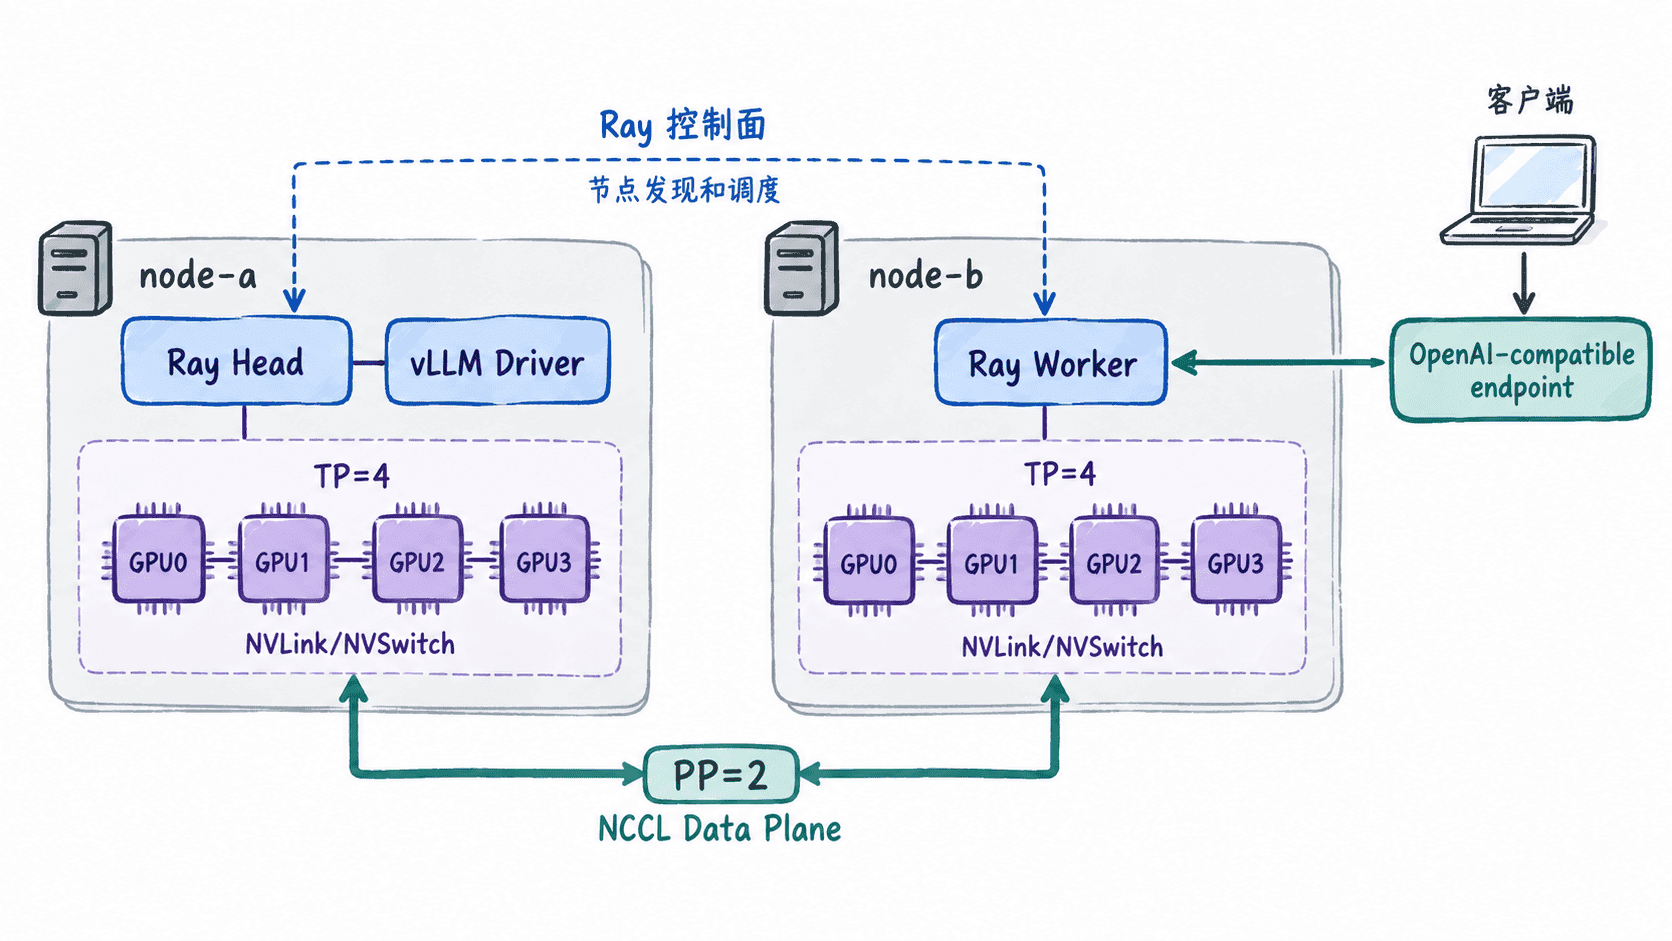
启动节点发现并固定通信接口
两台节点应使用一致的 CUDA、驱动、NCCL、Python 与 vLLM 环境,模型路径也必须在两端可访问。<NIC> 替换为实际高速网络或集群指定的通信接口名;NCCL_SOCKET_IFNAME 和 GLOO_SOCKET_IFNAME 主要用于固定 Socket/bootstrap 与控制通信接口,是否真正使用 RDMA 还需要结合 NCCL 日志和网络侧指标验证。
在 node-a 启动 Ray Head:
export CUDA_VISIBLE_DEVICES=0,1,2,3
export NCCL_SOCKET_IFNAME=<NIC>
export GLOO_SOCKET_IFNAME=<NIC>

ray stop --force
ray start --head \
  --node-ip-address=<HEAD_IP> \
  --port=<RAY_PORT> \
  --num-gpus=4
预期结果
Ray Head 在 <HEAD_IP>:<RAY_PORT> 启动,并向集群登记 4 个 GPU 资源。在 node-b 加入同一个集群:
export CUDA_VISIBLE_DEVICES=0,1,2,3
export NCCL_SOCKET_IFNAME=<NIC>
export GLOO_SOCKET_IFNAME=<NIC>

ray stop --force
ray start \
  --address=<HEAD_IP>:<RAY_PORT> \
  --node-ip-address=<WORKER_IP> \
  --num-gpus=4
预期结果
Worker 节点成功加入 Ray 集群;集群现在包含 2 个节点和总计 8 个 GPU 资源。<HEAD_IP>、<WORKER_IP>、<RAY_PORT> 与 <NIC> 都是环境相关值。若节点之间只能通过管理网互通,而高速网地址不具备必要的路由与防火墙规则,应先修复网络可达性,再启动 Serving。
启动跨节点 Serving
在 Head 节点启动 vLLM。这里使用 TP=4、PP=2,总共需要 8 个 GPU Worker;--distributed-executor-backend ray 让 vLLM 使用已经建立的 Ray 集群调度进程。临时打开 NCCL 初始化与网络日志,可以帮助确认实际选中的通信路径。
export NCCL_DEBUG=INFO
export NCCL_DEBUG_SUBSYS=INIT,NET

vllm serve <MODEL_PATH> \
  --served-model-name cluster-llm \
  --tensor-parallel-size 4 \
  --pipeline-parallel-size 2 \
  --distributed-executor-backend ray \
  --host 0.0.0.0 \
  --port <PORT>
预期结果
Serving 进程保持运行,8 个 GPU Rank 完成分布式初始化,模型权重加载完成,并在 <PORT> 提供 cluster-llm 服务;NCCL 初始化过程中没有 Rank 超时或网络初始化失败。启动成功后不要直接假定 TP Rank 一定按“每节点 4 卡”放置。应从启动日志或进程映射中确认 8 个 Rank 的节点归属,并检查 NCCL INIT,NET 日志是否选择了预期接口。若发现 TP 组跨越两台机器,应该先调整资源放置或并行策略,而不是用更大的批次掩盖跨机 All-Reduce 开销。
验证模型、拓扑与服务入口
先从任意能够访问 Head 服务端口的机器查询模型列表,确认客户端真正连到了这套集群,而不是旧进程或单机副本。
curl -fsS http://<HEAD_IP>:<PORT>/v1/models | \
python -c 'import json,sys; print(json.load(sys.stdin)["data"][0]["id"])'
预期输出
cluster-llm随后核对三个层面。权重层面要确认所有 Worker 都完成加载,没有某个节点因为路径、权限或磁盘空间问题停在初始化阶段;进程层面要确认 8 个 Rank 数量与 TP × PP 一致,且 GPU 可见性没有重复或遗漏;网络层面要确认跨节点流量出现在目标高速接口,而不是意外落到管理网卡。
故障验证应在非生产环境执行。对于模型并行副本,任意关键 Rank 退出后,正确行为通常是让整个副本失败并由上层编排重新拉起,而不是让剩余 Rank 继续对外返回不完整结果。测试时可以停止一个 Worker 进程,确认请求快速失败或服务副本退出,并检查编排系统能否重建完整的 8 Rank 拓扑。
降低跨节点通信开销
多节点优化的第一原则是减少“高频、小粒度”的跨机集合通信。能在单机 NVLink/NVSwitch 内完成的 TP 尽量留在单机,把跨机边界交给通信频率更低、粒度更大的 Pipeline Stage;如果模型或显存约束必须让 TP、EP 跨节点,则应确保高速 NIC、交换网络、NUMA 绑定和 NCCL 设备选择都与 Rank 放置一致。
另外要避免节点环境漂移。驱动、CUDA、NCCL、vLLM 版本不一致,或模型文件在不同节点不是同一版本,都会把问题伪装成随机超时和初始化失败。最终验收应同时满足:所有 Rank 一次性完成权重加载,进程拓扑与设计一致,NCCL 走预期链路,正常请求可返回结果,而任意关键 Rank 故障时整个副本能够一致退出并被可靠重建。